Command Palette
Search for a command to run...
GloVe:用于词表示的全局向量
GloVe:用于词表示的全局向量
Jeffrey Pennington Richard Socher Christopher D. Manning
摘要
近年来的词向量空间表示学习方法在通过向量运算捕捉精细的语义和句法规律方面取得了成功,但这些规律的来源一直不够明确。我们对词向量中产生此类规律所需的模型特性进行了分析和明确阐述。由此提出了一种新的全局对数线性回归模型,该模型融合了文献中两大主流模型家族的优势:全局矩阵分解和局部上下文窗口方法。我们的模型仅在词-词共现矩阵的非零元素上进行训练,而非在整个稀疏矩阵或大规模语料库的单个上下文窗口上训练,从而高效地利用了统计信息。该模型生成了具有有意义子结构的向量空间,其在近期词类比任务上 75% 的准确率证明了这一点。此外,该模型在相似性任务和命名实体识别任务上也优于相关模型。
一句话总结
斯坦福大学研究者提出 GloVe。这是一种全局对数双线性回归模型,仅使用词与词共现矩阵中的非零项进行训练,从而将全局矩阵分解方法与局部上下文窗口方法统一起来。该模型在词类比任务上达到 75% 的性能,并在词相似性和命名实体识别任务上优于相关模型。
核心贡献
-
GloVe 被提出为一种全局对数双线性回归模型,用于学习词向量表示,它结合了全局矩阵分解方法和局部上下文窗口方法。
-
分析确定了语义规律和句法规律得以显现所需的模型属性;模型在词与词共现矩阵的非零项上高效训练,而不是在完整的稀疏矩阵或单独的上下文窗口上训练。
-
实验结果显示出有意义的向量空间子结构,在近期的一项词类比任务上达到 75% 性能,并在词相似性和命名实体识别任务上相比相关模型有所提升。
引言
语义词向量空间很重要,因为它们支持信息检索、文档分类、问答、命名实体识别和解析等应用。早期方法面临一种权衡:像 LSA 这样的全局矩阵分解模型能够高效使用语料统计,但常常缺少词类比任务所需的线性结构;而像 skip-gram 这样的局部上下文窗口模型能够捕捉类比式意义方向,但对全局共现统计的使用效率较低。研究者针对这一问题提出 GloVe,一种基于加权最小二乘的全局对数双线性回归模型,直接基于词与词共现计数进行训练,将高效统计学习与有意义的向量子结构结合起来。
数据集
-
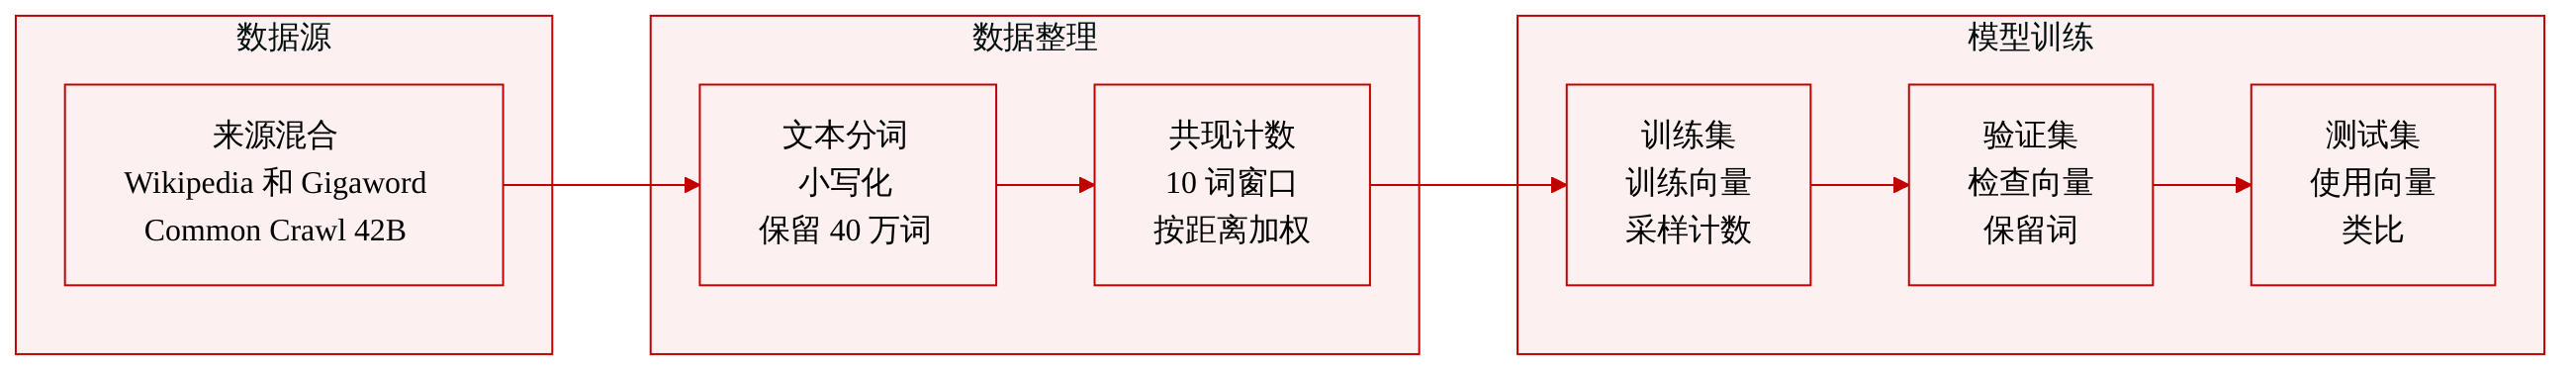
作者使用五个英文文本语料:包含 10 亿 tokens 的 2010 Wikipedia dump、包含 16 亿 tokens 的 2014 Wikipedia dump、包含 43 亿 tokens 的 Gigaword 5、包含 60 亿 tokens 的 Gigaword 5 与 Wikipedia 2014 合并语料,以及包含 420 亿 tokens 的 Common Crawl 网页数据。
-
每个语料都使用 Stanford tokenizer 进行分词并转换为小写。词表限定为出现频率最高的 400,000 个词。文中未描述标签、元数据字段或监督式 schema;语料按纯 token 序列处理。
-
从每个语料构建的主要数据结构是词共现计数矩阵 X。默认上下文窗口捕获目标词左侧十个词和右侧十个词。
-
共现计数会按距离降权。词对之间间隔 d 个词时,向总计数的贡献为 1/d,这反映出距离较远的词对对词关系信息较少。
-
对于向量学习,作者设置权重参数 x_max = 100 和 alpha = 3/4,并在训练期间从共现矩阵中采样非零条目。
-
各语料并未按指定比例合并为单一混合语料。相反,模型分别在每个语料或语料组合上训练,包括包含 60 亿 token 的 Gigaword 5 加 Wikipedia 2014 配置。
-
对于 word2vec 比较,包含 60 亿 token 的语料使用相同的 400,000 词词表以及大小为十的上下文窗口进行训练。
-
对于 SVD 基线,共现矩阵被截断,仅保留频率最高的 10,000 个词列,从而减少稀疏零条目并降低计算成本。
方法
GloVe 架构被构建为一个全局向量学习系统,它将语料级别的共现统计转换为稠密词表示。模型不是通过反复执行局部预测任务来学习嵌入,而是直接从预先计算的词与词共现矩阵中学习一种类矩阵分解结构。因此,该方法围绕三个主要组件组织:语料统计提取、连接嵌入与共现概率的参数化目标函数,以及控制频繁事件和稀有事件影响的加权回归过程。
系统的输入是一个大型文本语料,从中构造共现计数矩阵 X。每个条目 Xij 记录词 j 在词 i 的上下文中出现的次数。行和
Xi=k∑Xik统计了观察到的词 i 的总上下文数量;条件共现概率
Pij=P(j∣i)=XiXij表示词 j 出现在词 i 上下文中的概率。这些统计量成为学习词向量的目标信号。
核心思想是,相比原始概率,共现概率的比值能更清楚地揭示有意义的语义关系。对于两个关注词,例如 i 和 j,通过比值
PjkPik.考察其相对于探测词 k 的行为。如果 k 与 i 相关但与 j 不相关,则该比值较大。如果 k 与 j 相关但与 i 不相关,则该比值较小。如果 k 与两者均不相关,或与两者均相关,则该比值接近 1。这一观察促使构建一个模型,使其向量空间结构能够复现此类比值。
研究者从一个一般函数形式出发
F(wi,wj,w~k)=PjkPik,其中 wi 和 wj 是词向量,w~k 是单独的上下文向量。为了将其与线性向量运算联系起来,模型被约束为 F 依赖于两个目标词向量之差:
F(wi−wj,w~k)=PjkPik.由于输入是向量,而右侧是标量,模型进一步将交互归约为内积:
F((wi−wj)Tw~k)=PjkPik.为了保持词与其上下文之间的对称性,要求该函数表现为从加法到乘法的同态:
F((wi−wj)Tw~k)=F(wjTw~k)F(wiTw~k).这意味着 F 必须是指数形式。加入目标偏差项和上下文偏差项后,最终回归目标变为
wiTw~k+bi+b~k=logXik.因此,模型学习得到的嵌入使得目标向量、上下文向量及其偏差之间的内积近似于观察到的共现计数的对数。
实际训练目标是一种加权最小二乘公式:
J=i,j=1∑Vf(Xij)(wiTw~j+bi+b~j−logXij)2,其中 V 是词表大小。权重函数 f(Xij) 很关键,因为许多共现条目为零或非常小,而另一些则极其频繁。权重满足三个设计要求:f(0)=0,因此零共现不产生贡献;f 非递减,因此稀有事件不会被过度加权;并且 f 在较大的 Xij 处饱和,因此极常见的词对不会主导训练。模型采用一种实用参数化
f(x)={(x/xmax)α,1,x<xmax,x≥xmax.在所描述的设定中,xmax=100 和 α=3/4。这种权重在拟合中等共现与限制极频繁或极稀疏证据的影响之间形成平滑插值。
训练在共现矩阵的各个条目上进行,通常仅在非零条目上进行,因为权重函数会从目标中移除零计数。学习得到的参数包括目标词向量 wi、上下文向量 w~j 以及标量偏差 bi 和 b~j。该优化可被视为拟合共现矩阵的对数分解,其中内积项和偏差项作为对数频率曲面的低秩解释。
研究者还将 GloVe 与 skip-gram 等基于窗口的模型联系起来。softmax 上下文模型定义了一个概率
Qij=∑k=1Vexp(wiTw~k)exp(wiTw~j).当训练在语料上扫描时,隐含的全局目标可写为
J=−i=1∑Vj=1∑VXijlogQij.这可以解释为针对经验上下文分布和建模上下文分布的加权交叉熵目标。通过从概率空间散度转移到对数空间中的最小二乘目标,并将隐式共现权重替换为更一般的函数 f(Xij),GloVe 模型获得了一个更直接且计算上更简洁的回归目标。
方法的复杂度取决于 X 中非零条目的数量。如果共现计数在按排名排序的词对上服从幂律关系,
Xij=rijαk,则在典型条件下,非零共现的数量随语料大小呈亚二次增长。对于观测到的 α≈1.25 共现分布,有效非零条目数量大致表现为 ∣C∣0.8,其中 ∣C∣ 表示语料大小。这使得训练过程远比稠密词表矩阵所暗示的最坏情况 O(∣V∣2) 界更高效。
实验
实验在词类比、词相似性和命名实体识别上评估该词向量模型,同时分析向量维度、上下文窗口、语料大小、训练成本,以及 word2vec 和 SVD 基线的比较。模型在这些任务上表现强劲,尤其在类比和下游实体识别上,并且即使使用较小语料或较短训练时间仍具有竞争力或更优。额外分析显示,句法受益于较小的非对称上下文,语义受益于较大的上下文,语料领域会影响效果,而所提出的权重方案有助于模型比朴素 SVD 基线获得更好的规模扩展性。
概率结果显示,ice 与 steam 的上下文关联比值能够揭示每个词特有的属性。与某个目标词关联更强的词产生远离 1 的比值,而与两者均相关或均不相关的词产生接近 1 的比值。这支持使用共现概率比值来突出语义属性并降低一般上下文词带来的噪声。与 ice 相关但与 steam 不相关的探测词具有远大于 1 的 ice 到 steam 概率比值。与两个目标词均相关或均不相关的探测词保持在接近 1 的比值附近。
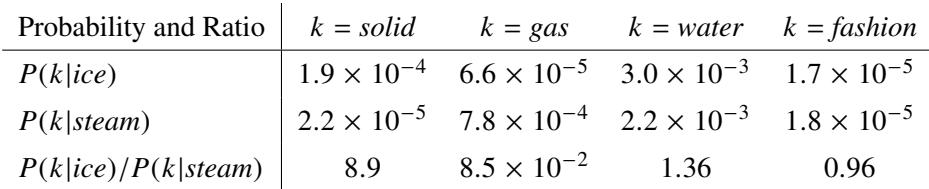
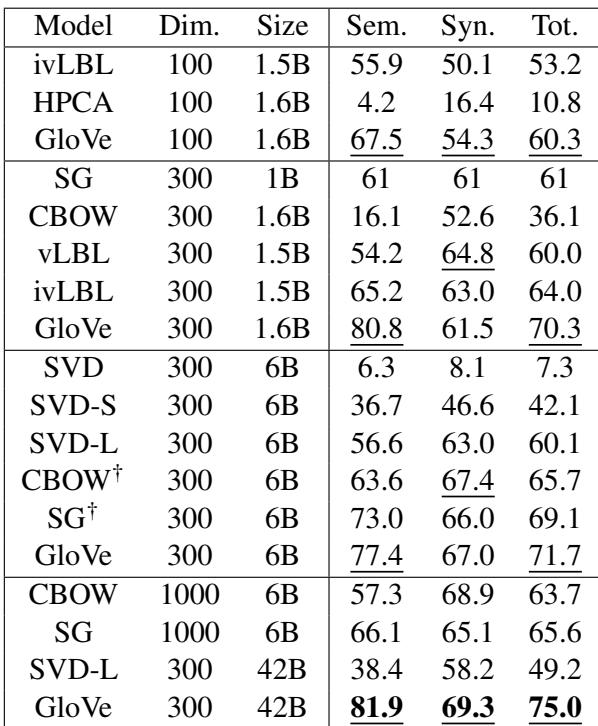
GloVe 在整体词类比准确率上取得最强结果,即使使用更小的向量维度或更小的训练语料,也常常超过基线。重新训练的 skip-gram 和 CBOW 结果略优于许多已发表基线,部分原因可归因于负采样和语料选择。扩展到更大的语料会给模型带来显著性能提升,而基础 SVD 模型在该语料上准确率下降,这支持了模型权重方案的必要性。在比较的向量模型中,GloVe 达到最佳的整体类比准确率。更大的语料显著提升模型,但可能导致基础 SVD 基线准确率下降。
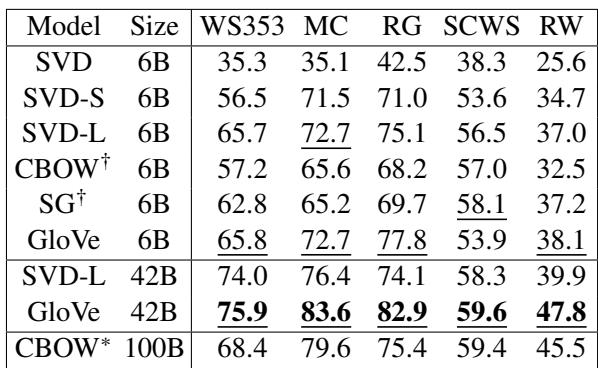
该表比较了 300 维词向量在五个词相似度数据集上相对于人工判断的 Spearman 秩相关结果。GloVe 在多数基准上表现强劲,并优于包含短语向量的 word2vec 向量,尽管后者在更庞大的语料上训练。将 SVD-L 扩展到更大语料可提升若干分数,但并未在所有相似度任务上产生一致增益。GloVe 在全部五个评估集上显示出有竞争力的词相似性结果。GloVe 在使用更小训练语料的情况下超过已发表的 word2vec 向量。更大语料的 SVD-L 提升了部分相似度分数,但在不同数据集上的结果仍参差不齐。
结果比较了使用 50 维向量的命名实体识别 F1 分数与不使用词向量的离散基线。使用 HPCA 和 CW 训练的向量显示出最强的整体性能,尤其在 ACE 和 MUC7 数据集上。SVD 变体更接近离散基线,而 SVD-L 在新闻导向的评估集上明显更弱。在报告的评估集中,HPCA 向量取得最佳性能。CW 向量接近 HPCA,并在整体上优于基于 SVD 的模型。在 ACE 和 MUC7 上,SVD-L 低于离散基线,表明其规模扩展行为较弱。
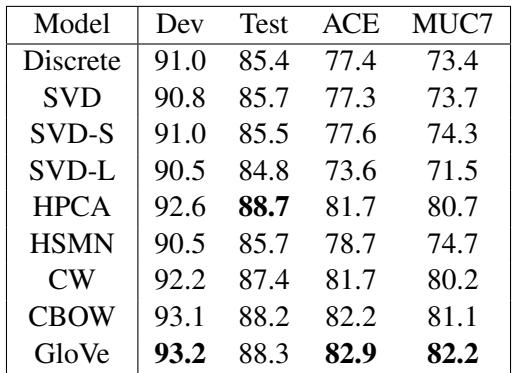
实验同时评估共现概率比值的诊断作用以及分布式向量模型的实际效用。比值分析显示,对某一概念具有选择性的词会产生极端比值,而泛化或不相关词聚集在 1 附近,这表明此类比值能够揭示词特定语义并抑制噪声。在标准语言任务上,GloVe 表现出持续强劲的性能,尤其在词类比和相似度基准上;对于具有合适权重方案的模型,更大的训练语料通常能改善学习到的表示。命名实体识别结果进一步支持了精心构造的稠密向量的价值,其中 HPCA 和 CW 取得最强的下游增益,而某些对规模扩展敏感的基线则表现出较弱或不稳定的行为。