Command Palette
Search for a command to run...
LSRM:基于扩展上下文窗口的高保真物体中心重建
LSRM:基于扩展上下文窗口的高保真物体中心重建
Zhengqin Li Cheng Zhang Jakob Engel Zhao Dong
摘要
我们提出了大规模稀疏重建模型(LSRM),以研究扩展 Transformer 上下文窗口对前馈式三维重建的影响。尽管近期以物体为中心的前馈方法能够生成鲁棒且高质量的重建结果,但在恢复细粒度纹理和外观方面仍落后于密集视角优化方法。我们发现,通过大幅增加活跃的物体和图像标记数量来扩展上下文窗口,可以缩小这一差距,从而实现高保真的三维物体重建与逆渲染。为了有效扩展规模,我们将原生稀疏注意力 [76] 适配于三维重建任务,具有以下三项关键贡献:(1) 一种高效的由粗到细流水线,通过预测稀疏高分辨率残差将计算集中在信息丰富的区域;(2) 一种三维感知的空间路由机制,利用显式几何距离而非标准注意力分数来建立精确的二维至三维对应关系;(3) 一种自定义的块感知序列并行策略,结合 All-gather-KV 协议以均衡 GPU 间的动态稀疏负载。因此,LSRM 能够处理的物体标记数量是先前最先进(SOTA)方法的 20 倍,图像标记数量超过其 2 倍。在标准新视角合成基准上的大量实验表明,相较于当前 SOTA 方法取得了显著提升,PSNR 提高超过 2.4 dB,LPIPS 降低超过 40%。此外,将 LSRM 扩展至逆渲染任务后,在广泛使用的基准上的定性和定量评估表明,其在纹理和几何细节方面均取得了一致的改善,LPIPS 达到甚至超越了 SOTA 密集视角优化方法的水平。代码和模型权重已在项目主页上公开。
一句话总结
Meta Reality Labs Research 提出 LSRM,一种 Large Sparse Reconstruction Model,它通过原生稀疏注意力、由粗到细流程、3D 感知空间路由以及 block-aware 序列并行,扩展用于前馈式 3D 对象重建的 transformer 上下文窗口,能够处理 20× 更多 object tokens,并相较此前最先进方法实现 >2.4 dB 更高的 PSNR。
核心贡献
- 这项工作提出了 Large Sparse Reconstruction Model,一种前馈式 3D 重建与逆渲染方法,它通过原生稀疏注意力扩展 transformer 上下文窗口,处理 20× 更多 object tokens 和超过 2× 更多 image tokens,相比此前最先进方法具有更强的扩展性。
- LSRM 为 3D 重建适配稀疏注意力,包含高效的由粗到细流程,用于预测稀疏高分辨率残差;包含 3D 感知空间路由机制,利用显式几何距离建立 2D 与 3D 对应关系;并采用带有 All-gather-KV 协议的 block-aware 序列并行策略,以在多个 GPU 上处理动态稀疏负载。
- 在标准新视角合成基准上的评估显示,相较当前最先进方法,PSNR 提升超过 2.4 dB,LPIPS 降低超过 40%;逆渲染实验则表明纹理和几何细节得到改善,并且 LPIPS 达到或超过稠密视角优化的水平。
引言
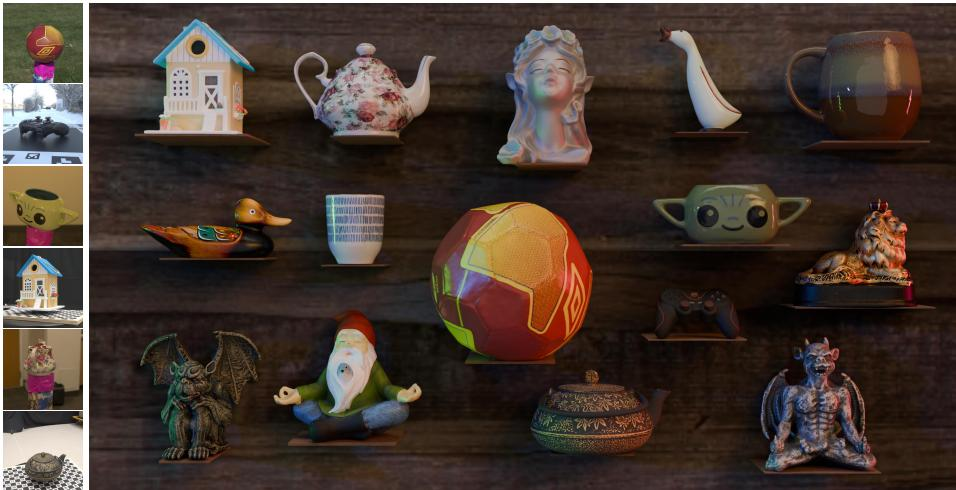
基于 transformer 构建的 3D 基础模型使得以对象为中心的重建和逆渲染大幅提速,这对于创建可靠的 3D 数字孪生等实际任务非常重要。关键限制在于,前馈式模型经常会产生模糊纹理、较差的细部细节和畸变几何,因为增加 3D 对象和 image tokens 数量很快会导致内存和计算成本过高。作者通过原生稀疏注意力扩展上下文窗口来解决这一问题,并使用由粗到细流程、3D 感知 block 路由和 block-aware 序列并行。他们的 LSRM 方法处理了更多的 object tokens 和 image tokens,提升了纹理与几何保真度,并扩展到可重照明的 3D 资产逆渲染。
方法
作者采用两阶段 transformer 流程。第一阶段从少量有 pose 的图像构建粗粒度稠密特征体积。第二阶段从稠密模型初始化,扩展输入与体积分辨率,并只激活具有空间信息量的 image 和 volume tokens。稀疏阶段依赖 Native Sparse Attention(NSA)、block-aware token 划分,以及定制序列并行调度,以在不破坏空间局部性的情况下扩展上下文窗口。
第一阶段从 image 和 volume tokenization 开始。输入包含 M 张有 pose 的图像,其相机参数编码为 Plücker 光线。每个视图被处理为不重叠的 8×8 patch,形成空间尺寸为 Sdimg=32 的 image token 图,对应 256×256 视图。对于每个 patch Im 及其关联的 Plücker 光线 Rm,模型将原始 patch 与光线的线性投影加到投影后的 DINOv3 特征上,形成融合后的 image token。由于 DINOv3 在 16×16 patch 上运行,每个输入 patch 首先以 2 倍上采样:
y={Linear(Im,Rm)+Linear(DINOv3(Upsample(Im)))}m=1M.这种融合将预训练视觉结构注入重建主干,并加速收敛。volume tokens x 由学习得到的 3D 位置嵌入初始化。作者不是实例化稠密参数体积,而是沿三个轴分解位置嵌入,学习三个独立的 1D 嵌入表 Px,Py,Pz∈RSdvol×d,其中隐藏维度 d=1024,稠密体积分辨率 Sdvol=16。对于体素坐标 (i,j,k) 处的 token,其嵌入为求和
pi,j,k=Pix+Pjy+Pkz.初始化后的 volume tokens 与 image tokens 拼接,并由稠密 transformer blocks 处理。
稠密重建 transformer 使用 24 个 blocks,隐藏维度为 1024。它采用 grouped-query attention,有 32 个 query heads 和仅 2 个 key/value heads。这种压缩 KV 布局很重要,因为它降低注意力内存压力,并使架构与后续的稀疏 transformer 对齐。每个 block 不使用单体式 self-attention 操作,而使用 volume 与 image tokens 之间门控混合的 cross-attention 更新。设 x 表示 volume tokens,y 表示 image tokens,注意力输出为
ox=wx−selfCrossAttn(x,x)+wx−crossCrossAttn(x,y), oy=wy−selfCrossAttn(y,y)+wy−crossCrossAttn(y,x),其中门控由线性投影后接 sigmoid 产生:
wx−self,wx−cross=Sigmoid(Lineargatex(x)), wy−self,wy−cross=Sigmoid(Lineargatey(y)).这种解耦设计允许 image-to-volume 和 volume-to-image 注意力分支在后续稀疏阶段被独立调整。最终稠密输出记为 xd 和 yd。volume tokens 经线性层投影为空间分辨率 64、特征维度 32 的稠密特征体积 Xd:
Xd=Linear(xd).该体积可在连续点 p∈R3 处通过三线性插值采样,得到用于轻量 MLP 解码器的特征 f。根据任务不同,这些解码器预测 SDF、颜色或材质属性,例如反照率、粗糙度和金属分量。对于体积渲染,SDF 表述为后续光线行进和 token filtering 提供简单的几何接口。
第二阶段显著扩展空间上下文。输入 image token 图可从 Sdimg=32 增长到 Simg=96,体积网格可从 Sdvol=16 增长到 Svol=96。稠密处理每一个 token 代价高昂,因此该方法首先通过选择有信息量的 token 构建稀疏表示。对于 image tokens,使用前景掩码丢弃背景区域,保留包含对象像素的 patch。对于 volume tokens,使用由冻结稠密阶段编码的几何信息。在每个体素内,采样 T=43=64 个点 Pi,j,k,使用稠密特征体积评估其 SDF 值,如果该体素靠近表面或被表面穿过,则将其标记为 active:
st=MLPs(Trilinear(Xd;pt)), Mi,j,kvol=I(pt∈Pi,j,kmin∣st∣≤τ∨(pt∈Pi,j,kminst)(pt∈Pi,j,kmaxst)≤0).该过滤步骤保留影响外观的体素,同时排除空区域。
为了在 token 剪枝后保留空间结构,active tokens 被分组为空间 blocks。image tokens 按 8×8 blocks 分组,volume tokens 按 8×8×8 blocks 分组。这种 block 划分对 NSA 是必要的,因为朴素的一维 token 划分会破坏细粒度 3D 推理所需的局部性。在每个 block 内,token-level keys 和 values 经过残差模块并被平均,形成压缩后的 key 和 value features:
kcmp=AvgPool(ResBlock(kt)), vcmp=AvgPool(ResBlock(vt)).这些压缩后的 block-level features 为注意力提供全局粗粒度上下文,而被选中的 active blocks 提供局部细粒度细节。
稀疏重建 transformer 保持与稠密模型相同的 block 数量和隐藏维度,但用基于 NSA 的 cross-attention 分支替换稠密 cross-attention。它从稠密权重初始化,这迁移了学习到的几何与视觉对应关系,并加速收敛。稀疏阶段还被训练为预测稠密预测上的残差,而不是从零开始重建完整高分辨率体积。设 xdup 和 ydup 表示稠密体积与图像输出中被上采样的 informative regions,稀疏 block 更新为
x(m),y(m)=NSABlock(m)(x(m−1)+Linear(m)(xdup),y(m−1)+Linear(m)(ydup)),其中 m=1,…,24,随后进行残差组合
xs,ys=x(24)+xdup,y(24)+ydup.输出的 sparse tokens 被投影为分辨率 Sfvol=384 的高分辨率稀疏特征体积 Xs,但仅在仍处于 active 状态的体素中。体积渲染期间,位于 active 表面区域内的射线采样点查询 Xs 以获得高频细节,而位于空区域或 inactive 区域的射线采样点查询 Xd 以获得低频结构。在 active 与 inactive 边界附近,方法在 sparse 与 dense features 之间使用线性混合以避免不连续性。
该稀疏阶段的一个关键模块是 3D-aware block routing。标准 NSA 使用针对压缩 keys 的注意力分数来选择 KV blocks,这在早期 transformer 层中可能不可靠。下方可视化的路由模式显示,基于注意力分数的选择可能在网络早期遗漏空间上相关的 blocks,而显式几何保持更一致的对应关系。
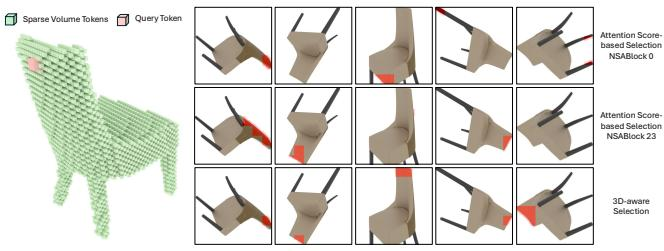
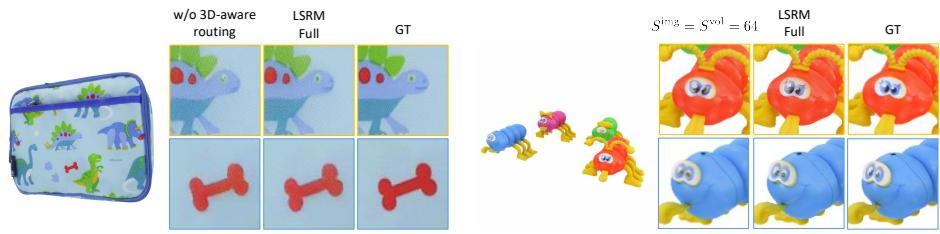
为了使路由由几何驱动,每个 token 被分配一个显式 3D 位置。volume token 使用其体素中心。image token 使用通过稠密特征体积渲染得到的、具有最高不透明度的前景表面点。对于 query-to-image-block 选择,query point 被投影到每个输入图像平面,按视图检索附近的 image blocks,并按候选 block 到 query point 的最小 3D 距离排序。对于 query-to-volume-block 选择,方法计算到 volume block centers 的 3D 欧氏距离,并保留最近的 blocks。这种基于几何的规则改善了图像证据与 3D 体素位置之间的对应关系。以下定性消融实验证实,路由机制和更高空间分辨率都有助于更清晰的纹理恢复。
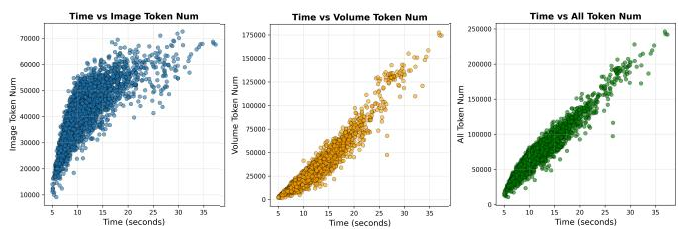
稀疏 tokenization 还带来系统级训练挑战。由于不同实例激活非常不同的 image 和 volume tokens 数量,不同 GPU 上的 worker 负载变化很强。如下方图所示,token 数量与每个实例的计算时间相关,因此朴素分片会导致掉队者效应,拖慢分布式训练。
作者通过定制 block-aware 序列并行方案解决这一问题。目标是在将 tokens 均匀分布到各 GPU 的同时,保持每个空间 block 完整位于单个设备上。这保留了 NSA 所需的 block 局部性,使窗口注意力和 KV-block 压缩可以局部执行,无需为这些操作进行额外的跨 GPU 通信。下方总结的流程显示,在第一个 NSA block 之前使用 all-to-all 通信重新分布 tokens,同时空间 blocks 保持完整,并将 queries 返回用于解码和渲染。
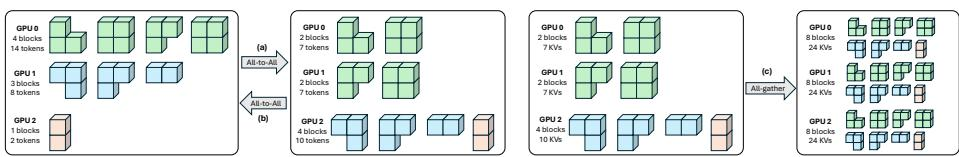
为了在稀疏注意力期间仍提供全局上下文,方法对压缩后和选中的 KV features 采用 all-gather 策略。压缩后的 keys 和 values 在所有设备上复制,而 queries 保持本地分片。由于 KV cache 已被大幅压缩,该 gather 操作的开销相对较小。这种设计在多个 GPU 间平衡计算,并允许比标准上下文并行切分更大的 sparse tokens 数量。
训练过程分阶段进行以稳定优化。首先在较低分辨率训练稠密模型。随后冻结稠密模型,并用它为稀疏模型生成 token masks、稠密残差和几何线索。稀疏阶段先在中等图像和体积分辨率下训练,以支持更大 batch sizes 和更快收敛,再扩展到高分辨率 token 网格。在每次迭代中,模型从球形相机配置中采样输入视角和目标视角。训练损失监督渲染颜色、前景掩码和深度,并在训练计划后期加入数值法向损失以提高几何保真度。对于逆渲染,模型从已收敛的新视角合成权重初始化,使用额外线性通路编码 background images 以减少光照与材质耦合,并在增广环境贴图下微调前,从预训练材质权重初始化 BRDF 预测头。
实验
实验在 GSO 上评估 LSRM 的新视角合成,并在 StanfordORB、DigitalTwinCatalogue 和 ObjectsWithLighting 上评估逆渲染,通过消融实验分离上下文窗口扩展与三维路由的影响。在这些设置中,更大的上下文窗口,尤其是 volume-token 扩展,以及 3D-aware routing,改善纹理清晰度、面部结构和几何结构,并提升可重照明性。逐像素逆渲染比较仍受全局材质模糊性限制,但感知质量和定性细节恢复明显优于前馈基线,并可与优化方法竞争。模型还从多视角训练泛化到较少视角评估,保持高保真重建,并在重照明的表现上超过此前方法。
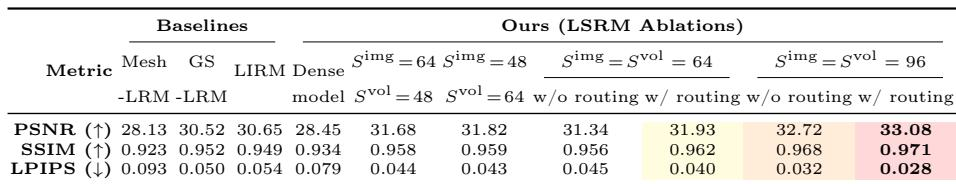
GSO 定量结果显示,LSRM 在新视角合成质量上强于对比的前馈基线。扩展图像和体积 token 分辨率相对低分辨率和稠密表示设置改善了 PSNR、SSIM 和 LPIPS,而 3D-aware block routing 提供额外增益。这些发现表明,更广泛的上下文建模和几何感知注意力路由是最终重建质量的重要贡献因素。LSRM 在 GSO 新视角合成的 PSNR、SSIM 和 LPIPS 上优于 Mesh、GS 和 LIRM。相比更小分辨率和仅稠密变体,增加 token 分辨率改善了新视角质量。在匹配 token 分辨率设置下,3D-aware routing 比省略路由产生更好结果。
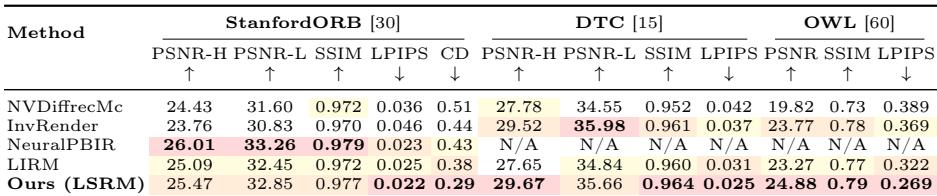
逆渲染结果显示,LSRM 在 StanfordORB、DTC 和 OWL 上提供最强的感知质量,并在三个基准上均取得最低 LPIPS。逐像素保真度有适度提升,而纹理细节和可重照明性受益于更一致的高频重建。结果还显示更好的几何一致性,尤其是 StanfordORB 上 Chamfer 距离的显著降低。LSRM 在所有逆渲染数据集上一致取得最低 LPIPS。感知增益大于 PSNR 增益,后者受全局材质模糊性限制。LSRM 在对比方法中显示 StanfordORB 上最佳 Chamfer 距离。定性观察支持细纹理、清晰文字和小几何细节的恢复。
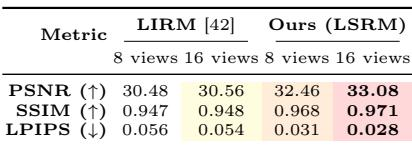
在 GSO 基准上的减少输入视角结果显示,LSRM 在使用八视角时仍保持很强的新视角合成质量,即使它使用十二到十六个视角训练。相比 LIRM,在八和十六输入视角下,其报告的 PSNR 和 SSIM 指标更高,LPIPS 更低。这一比较表明,扩展 context tokens 支持向较少视角的强泛化,而无需针对较小视角数量微调。八视角 LSRM 在两种视角设置下的报告图像质量指标上均优于 LIRM。较少输入视角仅导致轻微纹理清晰度损失,同时保持相对先前前馈基线的明显优势。
当逆渲染仅使用六个输入视角时,所提出模型在三个测试基准上给出最佳报告质量,在外观、感知相似度和几何误差方面超过 RelitLRM 和 LIRM。这一优势尤为显著,因为模型使用 12 到 16 个视角训练,并未针对减少视角推理进行微调。将视角数量增加到 18 进一步改善若干重建和几何指标,尽管某些材质和感知分数可能有所变化。模型在三个基准上均取得最强的六视角逆渲染结果。在 StanfordORB 上显示相对竞争方法更低的几何误差。在低于其 12 到 16 个输入训练视角数量时泛化良好。
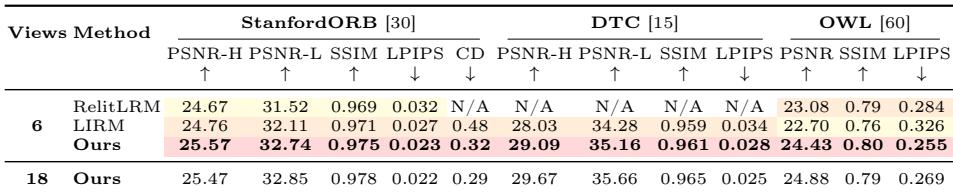
实验在 GSO 上评估新视角合成,并在 StanfordORB、DTC 和 OWL 上评估逆渲染,表明 LSRM 在感知质量和整体重建保真度上一致优于前馈基线。增加 token 和体积分辨率,以及 3D-aware routing,增强新视角结果,而逆渲染实验显示感知一致性、纹理细节和几何方面的最大增益,尤其是在 StanfordORB 上。模型还很好地泛化到比训练中使用的输入视角更少的情况,仅有限损失纹理清晰度或几何,并保持相对先前方法的明显优势。