Command Palette
Search for a command to run...
Poppy:基于偏振的即插即用引导方法,增强单目法线估计
Poppy:基于偏振的即插即用引导方法,增强单目法线估计
Irene Kim Sai Tanmay Reddy Chakkera Alexandros Graikos Dimitris Samaras Akshat Dave
摘要
在大规模 RGB-法线数据上训练的单目表面法线估计器在反射表面、无纹理表面和暗表面等边缘场景中往往表现不佳。偏振信息独立于纹理和反照率编码表面朝向,为这些情况提供了基于物理学的补充。然而,现有的偏振方法需要多视角采集或专门的训练数据,限制了泛化能力。我们提出 Poppy,一个免训练框架,在测试时利用单次偏振测量来精化任意冻结的 RGB 骨干网络输出的法线。Poppy 在保持骨干网络权重冻结的前提下,优化输入 RGB 和输出法线的逐像素偏移以及可学习的反射分解。可微渲染层将精化后的法线转换为偏振预测,并惩罚其与观测信号之间的不匹配。在七个基准测试和三种骨干网络架构(扩散、流和前馈)上,Poppy 在合成数据上将平均角度误差降低了 23–26%,在真实数据上降低了 6–16%。这些结果表明,在测试时利用偏振线索引导基于 RGB 的学习型法线估计器,可以在无需重新训练的情况下精化困难表面上的法线。
一句话总结
石溪大学提出了 Poppy,这是一种无需训练的框架,通过可微渲染层利用单次拍摄的极化测量,对冻结的单目法向估计器进行逐像素偏移优化,在七个基准上无需重新训练即可将合成数据上的平均角误差降低 23\%$--$26\%,真实数据上降低 6\%$--$16\%。
核心贡献
-
Poppy 是一种无需训练的框架,通过在测试时针对任何冻结的 RGB 法向估计器优化逐像素图像和法向偏移,使其与单次拍摄的极化测量保持一致,从而精修表面法线。它面向反光、无纹理和暗表面,不需要极化训练数据或骨干网络重新训练。
-
该方法将学习到的反射分解与可微的法向到 Stokes 渲染层相结合,使精修法线能够预测漫反射和镜面反射极化,并惩罚与观测信号之间的不一致。学习得到的镜面辐射图有助于在单视场极化中解析漫反射/镜面反射模糊。
-
在七个基准上,并跨扩散、流匹配以及前馈骨干网络,Poppy 将合成数据上的平均角误差降低 23% 到 26%,真实采集数据上降低 6% 到 16%。结果表明,可以利用基于物理的极化线索,对冻结的 RGB 法向估计器进行即插即用的测试时引导。
引言
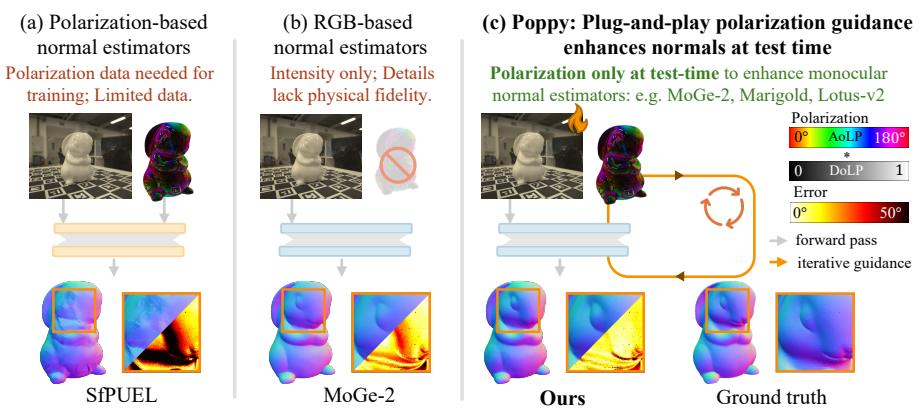
单目表面法线估计从单张 RGB 图像恢复逐像素三维方向,这对机器人、增强现实、场景理解和三维重建至关重要。现有仅使用 RGB 的方法往往在反光、无纹理和暗表面上失败,因为这些像素具有模糊或弱的明暗线索;而基于极化的方法要么存在固有法向模糊,要么需要昂贵的成对训练数据。作者提出了 Poppy,这是一种无需训练的框架,利用测试时拍摄的线偏振来引导任何冻结的 RGB 法向估计器。该方法通过可微极化渲染层优化可学习的逐像素图像和法向偏移以及镜面辐射图,从而解析全局场景方向和漫反射-镜面反射模糊,在无需重新训练骨干网络的情况下改善困难材质上的法线估计。
方法
作者利用一个冻结的单目 RGB 法向估计网络,并将极化感知的表面法线恢复建模为推理时引导问题。目标是在保持现代 RGB 法向估计器所习得的强几何先验的同时,强制预测结果与线偏振相机拍摄的极化测量保持一致。该方法不重新训练骨干网络,而是优化一组少量测试时参数,使网络预测趋向物理有效的 Stokes 测量。
给定角度 0∘、45∘、90∘ 和 135∘ 拍摄的极化图像,流水线首先计算观测 Stokes 向量
S=[S0,S1,S2]⊤.非偏振强度 S0 被用作 RGB 输入 x。一个预训练的 RGB 法向估计器 f 预测基本法向场
n^base=f(x).为了将该预测与观测到的极化数据进行比较,作者引入了一个可微渲染模型,该模型将候选表面法线和镜面辐射 Ls 转换为预测的 Stokes 向量
S^=F(n^,Ls).如果仅优化镜面辐射 Ls,当冻结骨干网络产生错误法向估计时,该方法可能失败。在这种情况下,残差 ∣S−S^∣ 可能仍然存在,因为误差源自法向本身,或者辐射可能过拟合到错误的几何结构。如下所示:
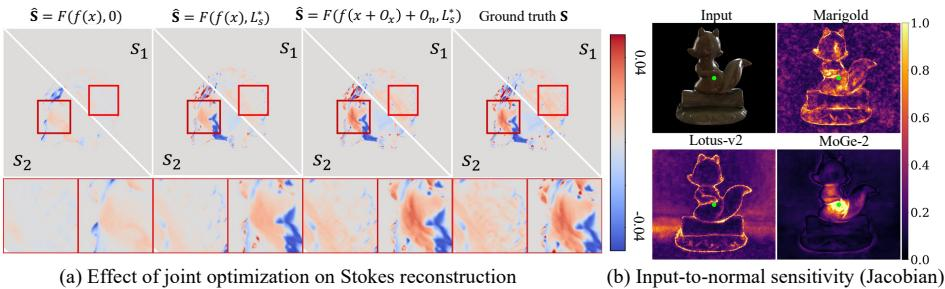
为解决这一失效模式,作者在冻结骨干网络的输入端和输出端应用可学习的偏移。迭代 t 处的精修法线可写为
n^t=f(x+Ox)+On,其中 Ox∈RH×W×3 是逐像素输入偏移,On∈RH×W×3 是逐像素法向偏移。在整个优化过程中骨干网络权重保持固定。
输入偏移 Ox 提供全局引导。由于 RGB 输入中的微小扰动可以影响输出法线图的较大区域,因此修改 Ox 允许优化将整体预测几何引导向符合极化一致的解。该行为与冻结网络的输入到法向敏感度有关。法向偏移 On 提供局部引导。它补偿了 RGB 法向估计器倾向于产生过度平滑预测的趋势,并有助于恢复骨干网络可能遗漏的高频表面细节。
在引导过程中,可训练参数为
Θ={Ls,Ox,On}.每次迭代中,骨干网络处理偏移输入 x+Ox,产生基本法向预测。然后加入法向偏移得到精修法线 n^t。给定 n^t 和当前镜面辐射 Ls,可微渲染器产生预测的 Stokes 向量
S^(n^t,Ls).该方法最小化观测 Stokes 向量与渲染 Stokes 向量之间的差异:
L=p∑M(p)i=0∑2Si(p)−Si(p),其中 p 表示一个像素。有效性掩码 M(p) 将损失限制在具有物理意义的测量上。如果像素具有足够的非偏振强度,
S0>0.01,没有饱和,
S0<1,并且满足物理 Stokes 约束
S12+S22≤S02.优化采用分阶段调度。在初始阶段,仅更新 Ls 和 Ox。这允许镜面辐射收敛,并使全局几何与观测到的极化场达到合理一致。预热阶段后引入法向偏移 On,从而能够优化局部高频校正。此时,三个参数组 Ls、Ox 和 On 都会更新,直到最终迭代 T。每个参数组都可以使用各自的学习率。
参数通过梯度下降更新:
Θ(k+1)=Θ(k)−λΘ∇ΘL.优化后,通过归一化引导预测得到最终法线:
n^=∥f(x+Ox)+On∥2f(x+Ox)+On.学习得到的镜面辐射和精修法线共同产生更符合观测 Stokes 向量的 Stokes 预测,而冻结的 RGB 骨干网络继续贡献其习得的几何先验。该方法假设正交投影并忽略观察方向,这一近似只有当场景在非常近距离拍摄时才会引入少量误差。
实验
实验在合成和真实基准上评估极化引导法向估计,跨三种骨干网络,并比较在无纹理、高光和低信噪比条件下与单目法线基线。极化引导始终改善表面方向和精细细节,其中图像偏移驱动大范围几何校正,法向偏移恢复更锐利的局部结构,同时在噪声和多种反射条件下保持稳定。精修法线还支持外观分解和更好的下游网格重建。
为 RGB 法向估计器添加极化引导,在真实和合成基准上一致地降低平均角误差和均方根角误差,同时提高阈值精度。改进在低角误差容差下尤其显著,表明该方法修正全局表面方向并恢复精细局部几何细节。当极化线索有噪声时,引导模型也表现得保守,向未引导预测收敛,而不是放大不可靠测量。极化引导在所评估的 RGB 骨干网络上均降低平均绝对法向误差和均方根法向误差。阈值精度在更严格的角误差阈值下改善最多,尤其在合成数据上。图像和法向偏移的联合优化有助于先修正大范围几何,再细化高频表面结构。该方法在材质变化下仍然有用,并随着极化噪声增加而变得保守。所评估的引导通常优于骨干网络基线,在某一种情况下性能下降可归因于未建模的透视畸变。
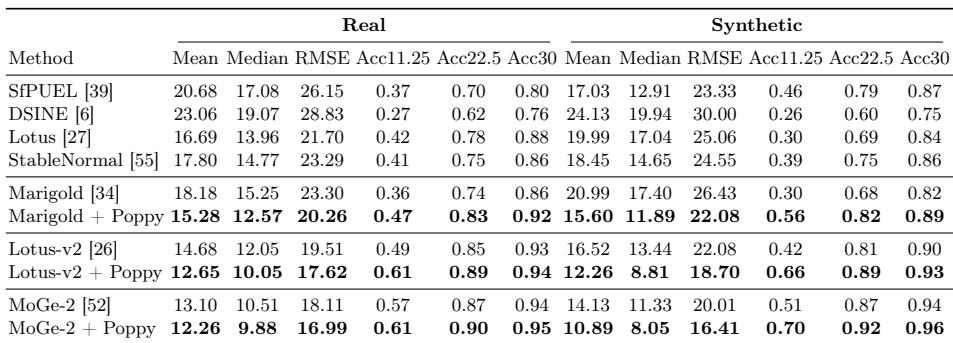
使用极化引导的 Poppy 变体在合成和真实数据集上相对于未引导骨干网络预测降低了 MAE。联合优化通常与仅图像引导相当或略有提升,表明细化法向偏移有助于恢复更准确的几何结构。增益在真实数据集上仍然可见,尽管具有挑战性的透视效应可能削弱引导优势。对于所展示的骨干网络,仅图像和联合 Poppy 都相对于无引导基线降低了误差。联合 Poppy 通常给出最佳 MAE,表明法向偏移细化改善了精细几何细节。优势在真实输入上仍然存在,但透视畸变可能在困难情况下降低引导效果。
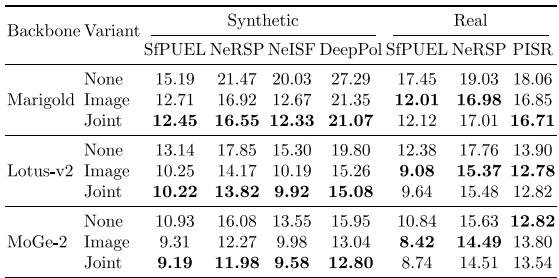
实验在合成和真实基准上评估极化引导的 RGB 法向估计,包括 Poppy 变体,与未引导骨干网络比较,测试角精度、材质变化、噪声鲁棒性和优化模式。极化引导始终改善全局表面方向和精细几何细节,联合图像和法向偏移细化有助于先修正大范围几何,再恢复更高频结构。当极化线索有噪声时,该方法仍然保守,尽管透视畸变可能降低其在困难真实案例中的优势。