Command Palette
Search for a command to run...
无遗忘学习
无遗忘学习
Zhizhong Li Derek Hoiem
摘要
在构建统一的视觉系统或逐步为系统添加新能力时,通常的假设是所有任务的训练数据始终可用。然而,随着任务数量的增长,存储这些数据并在其上进行重新训练变得不可行。一个全新的问题随之出现:在卷积神经网络(CNN)上添加新能力时,其已有能力的训练数据不可用。我们提出了 Learning without Forgetting 方法,该方法仅使用新任务数据来训练网络,同时保留原有能力。与常用的特征提取和微调适配技术相比,我们的方法表现更优,并且与使用我们假设不可用的原始任务数据的多任务学习方法表现相当。一个更令人意外的发现是,在新旧任务数据集相似的情况下,Learning without Forgetting 可能能够替代微调方法以获得更好的新任务性能。
一句话总结
伊利诺伊大学厄巴纳香槟分校的 Li 和 Hoiem 提出了 Learning without Forgetting,该方法将原始网络的软输出作为知识蒸馏的伪正则化来源,从而在不访问原始任务数据的情况下,利用新任务数据训练卷积神经网络时保留既有能力。
核心贡献
-
该论文提出了 Learning without Forgetting,一种在原始训练数据不可用时扩展卷积神经网络新能力的方法。它在新任务数据上训练网络,同时对网络施加正则化,使原始任务的输出保持接近预训练网络的输出。
-
该适配过程联合优化共享表示和最后一层,抑制对旧任务输出的改变,而不是仅冻结任务特定参数。它还在完整微调前采用热身步骤,以改善实际迁移效果。
-
使用 ImageNet 作为初始网络,并在 PASCAL VOC 等新任务上进行实验表明,Learning without Forgetting 在仅使用新任务数据时能够保留原始任务性能,并接近利用不可用的原始数据的多任务学习。它在新任务性能上优于 Less Forgetting Learning,并且在新旧任务数据集相似的一些设置中,相比微调有所提升。
引言
作者面向增量式视觉模型更新,例如在现有 CNN 上添加新的物体、安全或场景分类器,而不使用旧数据重新训练。这一点很重要,因为实用系统需要适应新任务,同时保留先前能力并避免灾难性遗忘,尤其当遗留数据属于专有、未记录或复用成本过高时。现有方法存在局限:特征抽取能够保留旧知识,但在新任务上往往表现不足;微调能够提升新任务,但会改变共享参数并可能损害旧任务;复制微调网络会增加测试时间;联合训练表现强劲,但需要旧训练数据并且变得繁琐。作者扩展了 Learning without Forgetting,该方法仅使用新任务样本优化新任务准确率,同时将原始网络的预测蒸馏为软目标。这可以保留旧输出,对共享表示进行正则化,并在计算成本更低、部署比联合训练或多个专用网络更简单的前提下改善新任务和旧任务性能。
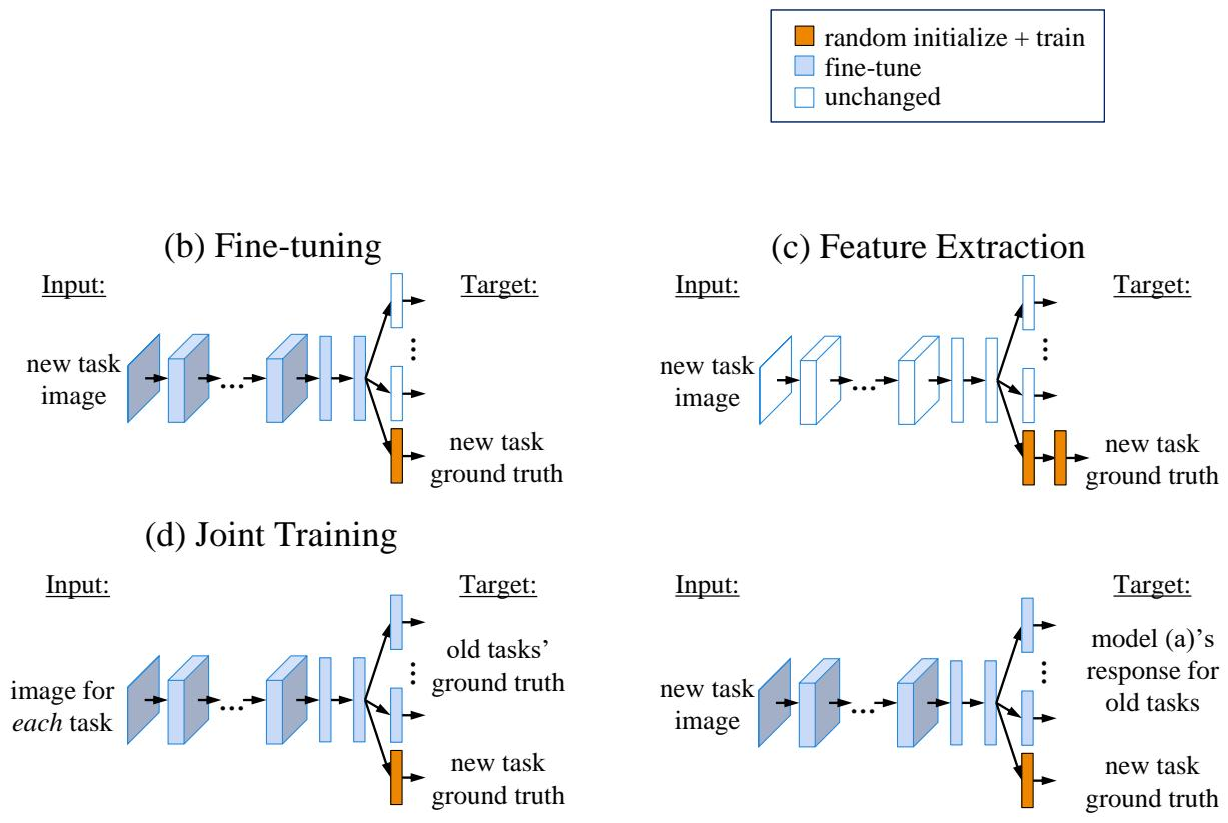
方法
作者使用包含共享参数 θs 和任务特定参数的 CNN 进行新任务适配。先前学习的任务由 θo 表示,新任务引入额外参数 θn。该方法仅使用新任务的图像和标签,同时通过约束网络输出,使其保持接近原始网络的响应,从而保留先前任务的有用行为。整体结构可理解为在现有模型中添加新的输出分支,并使用组合目标训练两个分支。参见框架图。
流程首先将每个新任务训练图像通过由 θs 和 θo 定义的原始网络。对于每张图像,网络产生旧任务响应向量 yo,在分类设置下由标签概率组成。这些记录的响应在后续训练中被视为教师信号。然后,向最后的共享层添加新类别的输出节点,并使用新初始化的权重 θn 进行连接。所添加参数的数量通常较小,因为它等于新类别数乘以最后共享层的节点数。作者在实现中对新参数使用 Xavier 初始化。
训练优化一个混合目标,它组合了新任务的有监督学习与旧任务的响应保持。对于新任务,网络输出 y^n 是 softmax 分布,而 yn 是 one-hot 真值标签。新任务损失使用多项逻辑损失:
Lnew(yn,y^n)=−yn⋅logy^n.如果存在多个新任务或多标签输出,则对所有任务和标签的该损失求和。
对于旧任务,该方法不要求访问原始训练图像。相反,它要求当前网络在新任务图像上的输出 y^o 与原始网络记录的响应 yo 相匹配。这通过知识蒸馏损失完成。概率值首先使用温度 T 进行修改:
yo′(i)=∑j(yo(j))1/T(yo(i))1/T,y^o′(i)=∑j(y^o(j))1/T(y^o(i))1/T.然后旧任务损失为温度缩放交叉熵项:
Lold(yo,y^o)=−i=1∑lyo′(i)logy^o′(i).报告中使用的温度为 T=2。大于 1 的值会增强较小概率的相对影响,促使网络保留类别相似性信息,而不只是匹配最可能的标签。总训练目标将这些项与正则化组合:
L=Lnew+λoLold+R,其中 R 是简单的权重衰减项,在实验中设置为 0.0005,λo 控制新任务学习与旧任务保持之间的平衡。较大的 λo 会给旧任务响应保持损失更高权重,从而将性能推向原始任务,但可能以牺牲新任务为代价。参见权衡图。
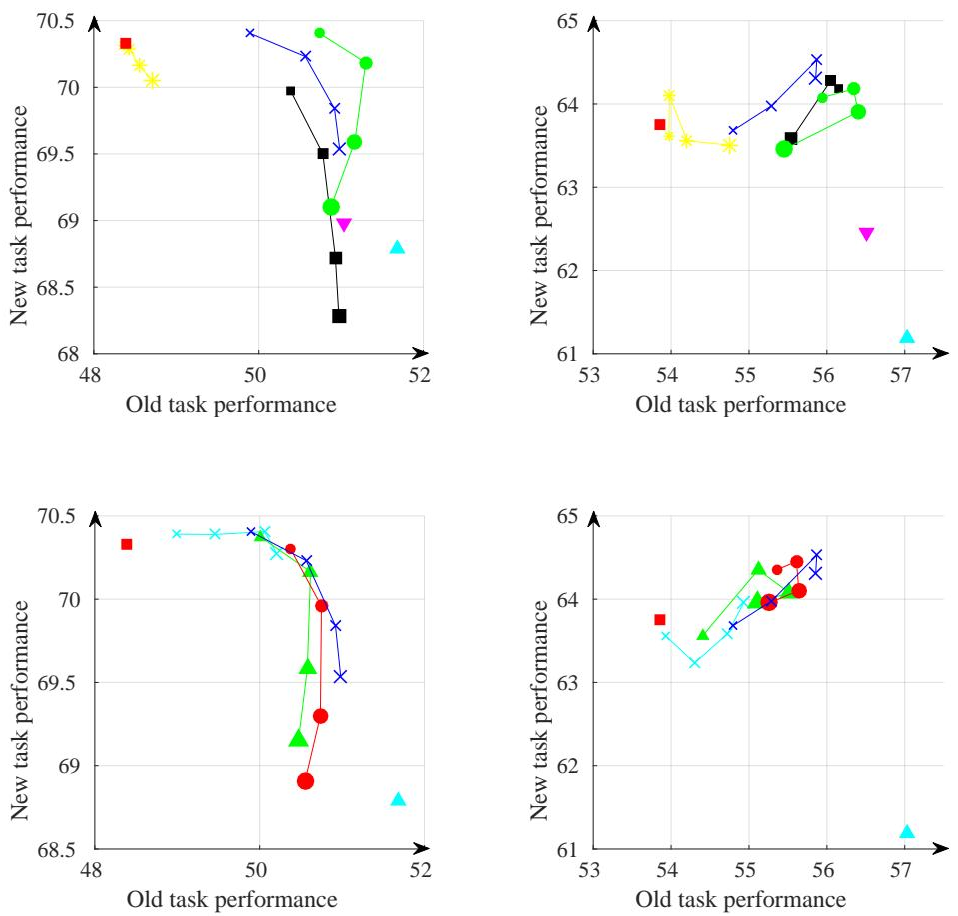
优化分两个阶段。在热身阶段,共享参数 θs 和旧任务参数 θo 被冻结,只训练新初始化的参数 θn 直到收敛。这在调整共享表示之前为新输出头提供稳定初始化。在联合优化阶段,所有参数 θs、θo 和 θn 一起训练直到收敛。作者采用这一两阶段方案,是为了与比较方法保持公平,并获得小的性能收益。
在实现中,网络使用随机梯度下降训练,动量为 0.9。全连接层中的 dropout 保持启用。数据预处理遵循原始网络设置,包括均值相减、尺寸调整,以及随机固定尺寸裁剪、随机镜像和 RGB 方差扰动。适配的学习率明显低于原始训练学习率,通常约为原始值的 0.1 到 0.02 倍。特征抽取基线使用大得多的学习率,因为它只优化少量参数。热身阶段和联合优化阶段的 epoch 数在保留验证数据上选择,当验证准确率趋于平稳时,学习率缩小 10 倍。
该方法可视为不存储旧数据集时对联合训练的一种近似。联合训练会使用旧任务和新任务的图像与标签,并将相应的任务损失分别应用到对应图像。相比之下,该方法使用新任务图像作为共同输入,并使用记录的旧任务响应作为旧行为的替代监督。这消除了访问或存储旧训练数据的需要,并允许每张新任务图像通过共享特征抽取器一次,用于新任务损失和旧任务蒸馏损失。基线特征抽取变体冻结共享参数,禁用 dropout,并在冻结特征之上添加一个小型两层网络,而联合训练会在不同任务的批次之间交替,并平衡每个 epoch 中每个任务采样的图像数量。
实验
实验评估 Learning without Forgetting 将预训练卷积网络适配到新的图像分类任务时,在保留旧任务性能方面的表现,并在相似度不同的数据集上与特征抽取、微调、部分微调、Less Forgetting Learning 和联合训练进行比较。LwF 通常比基于微调的基线提供更强的新任务适配能力,并且比完整微调更好地保留旧任务性能,尽管不需要旧任务训练数据,往往接近联合训练;不过,高度不相似的任务或顺序添加的任务仍可能导致更大的性能漂移。消融实验表明,使用蒸馏式损失保留旧任务输出比权重正则化、降低共享学习率、增加额外任务特定层或网络扩张更有效,支持将 LwF 作为标准微调在持续预测扩展中的实用且可解释替代方案。
比较表明,Learning without Forgetting 在保留新旧任务性能的同时,只需要中等存储,并且无需访问先前任务数据。它训练和测试都很快,相比高效但在原始任务上较弱的微调,以及准确但缓慢、存储负担重且依赖先前数据的联合训练,提供了更均衡的选择。Learning without Forgetting 在新任务上取得强性能,同时保持原始任务准确率。联合训练表现良好,但更慢,并且需要先前任务数据和更大存储。微调高效,但可能损害原始任务性能。
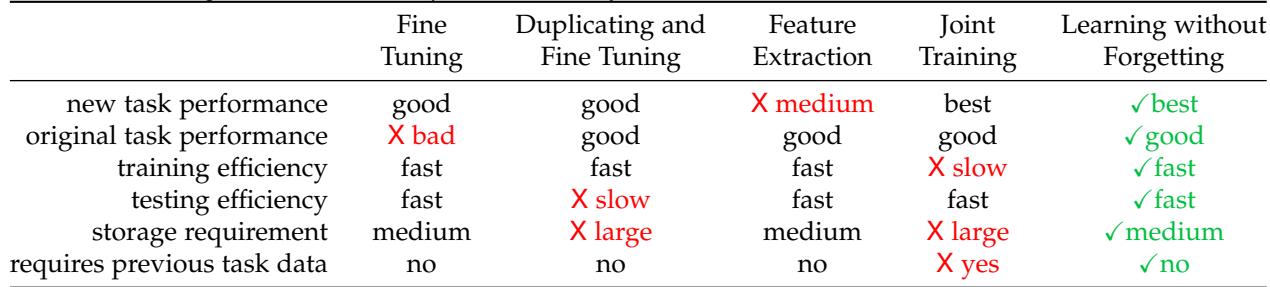
实验比较了不同持续学习策略在任务性能、效率、存储和数据需求方面的表现。Learning without Forgetting 在新任务和原始任务上都有较强表现,只需要中等存储,并且不需要先前任务数据。相比高效但在原始任务上较弱的微调,以及准确但更慢、存储负担重且依赖先前数据的联合训练,这使其更有优势。