Command Palette
Search for a command to run...
用于实时风格迁移和超分辨率的感知损失
用于实时风格迁移和超分辨率的感知损失
Justin Johnson Alexandre Alahi Li Fei-Fei
摘要
本文研究图像变换问题,即如何将输入图像转换为输出图像。针对此类问题,现有方法通常使用输出图像与真实图像之间的逐像素损失来训练前馈卷积神经网络。与此同时,另一条并行研究路线表明,通过定义并优化基于预训练网络所提取的高层特征的感知损失函数,可以生成高质量的图像。我们结合了上述两种方法的优势,提出在图像变换任务中使用感知损失函数来训练前馈网络。我们在图像风格迁移任务上展示了实验结果,其中前馈网络被训练用于实时求解 Gatys 等人提出的优化问题。与基于优化的方法相比,我们的网络取得了相似的视觉质量,但速度提升了三个数量级。此外,我们还在单图像超分辨率任务上进行了实验,结果表明将逐像素损失替换为感知损失可以获得令人满意的视觉效果。
一句话总结
斯坦福大学作者提出使用基于预训练网络高层特征的感知损失函数训练前馈卷积网络,实现实时风格迁移,在获得与 Gatys et al. 基于优化的方法相当的定性结果的同时,速度快三个数量级,并且也提升了单图像超分辨率效果。
核心贡献
-
使用由预训练卷积网络高层特征计算得到的感知损失函数训练前馈卷积转换网络,而不是使用传统的逐像素损失,从而将快速前馈架构与基于优化的感知图像生成结合起来。
-
该方法在图像风格迁移上得到验证,通过训练前馈网络实时近似 Gatys et al. 的优化目标。所得网络产生定性上相似的结果,同时比基于优化的方法快三个数量级。
-
在单图像超分辨率中,将逐像素损失替换为感知损失可产生视觉上令人满意的结果,并更好地重建细粒度细节和边缘。
引言
许多图像转换任务,例如去噪、超分辨率、上色、分割和风格迁移,都涉及将输入图像映射为结构化输出图像。一种常见方案是使用逐像素损失训练前馈卷积网络,这使得推理很快,但可能无法良好反映人类感知到的差异,例如轻微错位或缺失细粒度细节。使用感知损失的基于优化的方法通过比较预训练网络的高层特征来提升输出质量,但需要在测试时进行缓慢优化。作者通过直接使用从预训练 CNN 导出的感知损失函数训练前馈网络来弥补这一差距。该方法在保持实时推理的同时,从损失网络中转移语义和感知知识,从而得到快速风格迁移结果,并提升单图像超分辨率中的细节重建效果。
方法
作者利用基于学习的图像转换框架,而不是直接从初始噪声图像优化每个输出图像。该系统包含两个主要组件:一个可训练的图像转换网络 fW,以及一个固定的损失网络 ϕ,后者定义训练期间使用的目标函数。参见框架图。
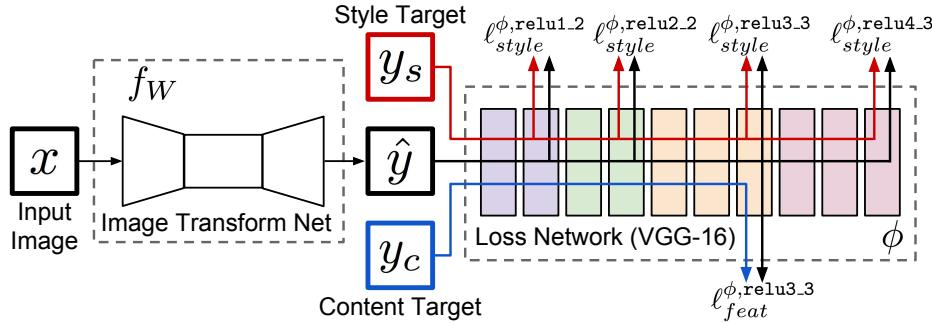
转换网络是由权重 W 参数化的深度残差卷积网络。给定输入图像 x,它生成输出图像 y^=fW(x)。损失网络 ϕ 用于计算 y^ 与目标图像(例如内容目标 yc 或风格目标 ys)之间的感知度量。该网络通过随机梯度下降训练,以最小化损失函数的加权组合:
W∗=argWminEx,{yi}[i=1∑kλiℓi(fW(x),yi)].损失网络预先在图像分类上训练,并在训练过程中保持固定。在提出的方法中,该损失网络通常是一个 16 层卷积分类网络,其学习到的特征表示用作内容和风格的感知度量。关键设计思想是,用于分类的网络已经包含与人类感知图像相似性相关的有信息量中间特征,因此这些特征可以在损失函数中被复用,而不是仅依赖原始像素距离。
转换网络遵循带有残差块的全卷积架构准则。它不使用池化层。相反,下采样和上采样通过带步长卷积和分数步长卷积完成。除输出层外,所有非残差卷积层之后都接空间批量归一化和 ReLU 非线性,输出层使用缩放后的 tanh 激活函数来约束输出像素值。第一层和最后一层使用 9×9 卷积核,其余卷积层使用 3×3 卷积核。
对于风格迁移,网络将尺寸为 3×256×256 的彩色图像映射为相同尺寸的彩色图像。对于上采样因子为 f 的单图像超分辨率,网络从尺寸为 3×288/f×288/f 的低分辨率图像块生成尺寸为 3×288×288 的高分辨率图像块。由于该架构是全卷积的,它可以在测试时应用于不同分辨率的图像。
下采样和上采样设计对于效率和感受野增长都至关重要。在风格迁移中,网络使用两个步长为 2 的卷积来降低空间尺寸,然后使用若干残差块,再使用两个步长为 1/2 的分数步长卷积来恢复原始分辨率。对于超分辨率,在一组残差块之后,它应用 log2f 个步长为 1/2 的卷积层。这避免了使用固定的插值步骤进行上采样。相反,上采样行为与转换网络的其余部分联合学习。
在深度残差主体之前进行下采样有两个实际好处。第一,它降低计算成本。对尺寸为 C×H×W 的特征图应用带 C 个滤波器的 3×3 卷积,与对尺寸为 DC×H/D×W/D 的特征图应用带 DC 个滤波器的 3×3 卷积具有相同的计算成本。因此,在下采样后,网络可以在相似成本下使用更宽的特征表示。第二,下采样扩大了有效感受野。没有下采样时,每个 3×3 卷积使有效感受野增加 2 个像素。在因子为 D 的下采样后,同一个 3×3 卷积使有效感受野增加 2D。这对风格迁移很重要,因为连贯的风格效果需要图像范围内的大范围空间感知变化。
感知损失设计使用固定的损失网络 ϕ 来计算内容和风格目标。设 ϕj(x) 表示损失网络在处理图像 x 时第 j 层的激活值。如果第 j 层是卷积层,则 ϕj(x) 是形状为 Cj×Hj×Wj 的特征图。特征重建损失不是匹配 y^ 与目标图像 y 之间的原始像素,而是鼓励相似的特征表示:
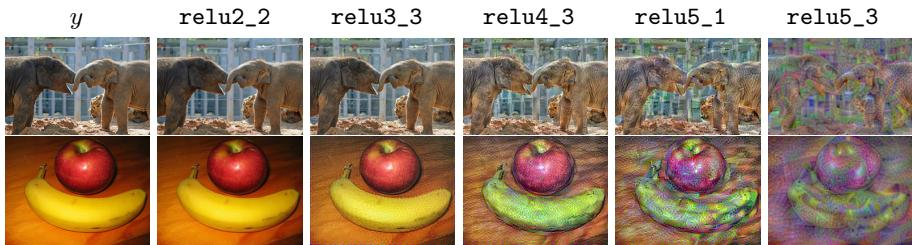
ℓfeatϕ,j(y^,y)=CjHjWj1∥ϕj(y^)−ϕj(y)∥22.预训练分类网络中的早期层保留低层外观细节,因此从早期层重建往往会产生在颜色、纹理和局部结构上与原始图像非常接近的图像。较高层保留内容和全局空间组织,同时忽略许多细粒度纹理细节。参见不同网络深度的视觉特征重建比较。
风格重建损失衡量纹理、颜色统计和共同出现特征模式之间的差异。它使用特征图的 Gram 矩阵定义。对于图像 x,第 j 层的 Gram 矩阵是一个 Cj×Cj 矩阵,其元素为
Gj,c,c′ϕ(x)=CjHjWj1h=1∑Hjw=1∑Wjϕj(x)h,w,cϕj(x)h,w,c′.如果将 ϕj(x) 解释为在每个空间位置提取的 Cj 维特征,则 Gram 矩阵近似这些特征在空间位置上的未中心化协方差。它捕捉哪些特征会共同激活。Gram 矩阵可通过将 ϕj(x) 重塑为 Cj×HjWj 的矩阵 ψ 并计算
Gjϕ(x)=CjHjWjψψT.来高效求解。
单层风格损失则为
ℓstyleϕ,j(y^,y)=Gjϕ(y^)−Gjϕ(y)F2.对于来自一组层 J 的风格迁移,风格损失在这些层上求和:
ℓstyleϕ,J(y^,y)=j∈J∑ℓstyleϕ,j(y^,y).这种表述是有用的,因为 Gram 矩阵由特征统计量而非空间对齐的像素值计算得到。因此,即使输出图像和风格目标尺寸不同,风格损失仍然有明确定义。最小化该损失会鼓励输出图像重现风格目标的统计外观模式,同时不要求保留该目标的确切空间布局。
除感知损失外,该方法在需要时还使用简单的像素空间目标。像素损失是输出图像与目标图像之间的归一化平方欧氏距离:
ℓpixel(y^,y)=CHW1∥y^−y∥22.该损失适用于存在真实目标图像的情况,例如超分辨率。还会对输出应用全变差正则项,以抑制过度的空间噪声并鼓励更平滑的局部结构。
对于风格迁移,训练设置通常对每个风格目标使用一个转换网络。内容目标是输入图像 x,风格目标 ys 控制输出的视觉风格。网络被训练以最小化特征重建损失、风格重建损失和全变差正则化的加权组合。对于超分辨率,输入 x 是低分辨率图像,内容目标 yc 是高分辨率真实值,风格损失通常被省略。对每个超分辨率倍率训练一个网络。
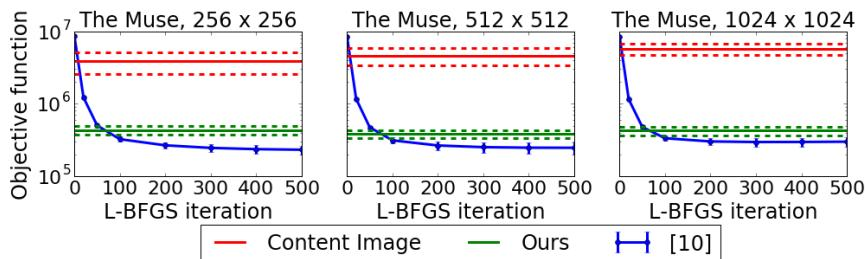
由此得到的训练过程将计算负担从推理转移到训练。直接优化通过重复最小化固定损失网络中的同一感知目标,一次生成一张图像。所提方法则训练一个前馈转换网络,使得训练完成后,风格迁移或超分辨率可通过单次前向传播完成。所学习的网络针对与迭代优化方法相同的感知目标函数族进行优化,同时也能泛化到比训练中使用图像更大的输入图像。这种目标函数和泛化行为体现在迭代优化过程中的损失值比较以及不同分辨率下输出质量的比较中。
实验
实验在风格迁移和单图像超分辨率上评估该方法。对于风格迁移,将在 MS-COCO 上训练的前馈网络与基于优化的基线方法进行比较,结果显示视觉质量相似,同时大幅降低推理时间,并在更高分辨率下保持语义内容。对于超分辨率,将使用特征重建损失训练的模型与像素损失基线和 SRCNN 基线进行比较,表明感知特征能够改善清晰边缘和细粒度细节,尽管低层伪影可能增加。
对于风格迁移,前馈网络远快于迭代优化基线,同时产生相似的定性结果。速度优势在多种图像分辨率上都非常大,并且随着分辨率提高仍然很强。生成风格迁移结果所需时间仅为基线方法的一小部分。可以比基线方法的单个优化步骤更快。在运行时间大幅缩减的同时保持类似的定性输出质量。
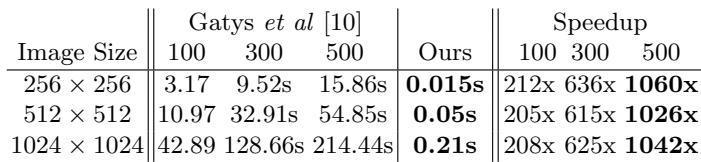
实验将前馈网络与用于风格迁移的迭代优化基线在多种图像分辨率上进行比较。结果验证前馈模型能够以更快速度生成风格化图像,同时保持类似的定性输出,且速度优势在更高分辨率下仍然很强,甚至超过基线方法的单个优化步骤。