Command Palette
Search for a command to run...
SSD:单次多框检测器
SSD:单次多框检测器
Wei Liu Dragomir Anguelov Dumitru Erhan Christian Szegedy Scott Reed Cheng-Yang Fu Alexander C. Berg
摘要
本文提出了一种使用单个深度神经网络在图像中检测目标的方法。该方法命名为 SSD,将边界框的输出空间离散化为不同特征图位置上多种宽高比和尺度的默认框。在预测阶段,网络为每个默认框生成各目标类别存在的得分,并对边界框进行调整以更好地匹配目标形状。此外,网络融合了来自不同分辨率的多个特征图的预测结果,从而自然地处理各种尺寸的目标。相较于需要目标候选区域的方法,SSD 更为简洁,因为它完全消除了候选区域生成以及后续像素或特征重采样阶段,将所有计算封装在单个网络中。这使得 SSD 易于训练,并能够简便地集成到需要检测组件的系统中。在 PASCAL VOC、COCO 和 ILSVRC 数据集上的实验结果证实,SSD 的精度与使用额外目标候选区域步骤的方法相当,但速度更快,同时为训练和推理提供了统一的框架。对于 300 × 300 的输入,SSD 在 VOC2007 测试集上以 59 FPS 达到了 74.3% mAP(Nvidia Titan X);对于 512 × 512 的输入,SSD 达到了 76.9% mAP,优于同等水平的 Faster R-CNN 模型。与其他单阶段方法相比,即使在更小的输入图像尺寸下,SSD 也具有更好的精度。代码见:https://github.com/weiliu89/caffe/tree/ssd。
一句话总结
SSD 是由北卡罗来纳大学教堂山分校、Zoox 和 Google 研究人员提出的单阶段目标检测器,将边界框输出离散化为跨多个长宽比、尺度和特征图分辨率的默认框,完全消除候选区域生成,在 VOC2007 上以 59 FPS 和 300×300 输入达到 74.3% mAP,在显著更快的同时与 Faster R-CNN 相媲美。
核心贡献
-
SSD 使用单个深度神经网络检测目标,在每个特征图位置为许多默认框预测类别得分和边界框调整,消除候选区域生成和重采样阶段。
-
该方法将卷积边界框预测器附加到不同分辨率的多个特征图上,并对许多位置、尺度和长宽比进行采样,在保持比两阶段候选区域流程更简单的同时,提升对多尺度目标的建模能力。
-
在 PASCAL VOC、COCO 和 ILSVRC 上的实验显示出相当或更优的准确率,其中 SSD300 在 VOC2007 上以 59 FPS 达到 74.3% mAP,SSD512 达到 76.9% mAP,优于可比较的 Faster R-CNN 模型。
引言
作者研究了现代目标检测系统,这些系统假设边界框、重采样像素或特征,并对每个区域进行分类,从而在 PASCAL VOC 和 COCO 等基准上实现高准确率,但由于计算量大且延迟高,使得嵌入式和实时部署困难。先前工作通过优化候选区域或池化来提升速度,但这些收益通常以牺牲检测准确率为代价,而两阶段区域候选方法增加了训练和集成复杂度。作者利用 SSD,这是一种单阶段检测器,使用固定默认框和小型卷积滤波器,直接从多个特征图和针对特定长宽比的滤波器预测目标类别和框偏移,在无需像素或特征重采样的情况下实现高准确率,并在 VOC2007 上达到 59 FPS 和 74.3% mAP 等实时性能。
方法
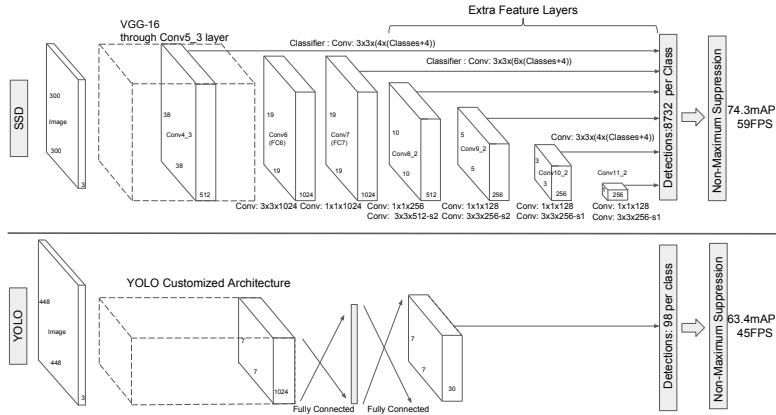
作者利用前馈卷积检测器,在一次前向过程中预测一组固定边界框和类别得分,随后通过非极大值抑制步骤获得最终检测结果。早期层构成基础网络,即在分类层之前截断的标准分类骨干网络。额外特征层附加到基础网络末端。这些层逐步降低空间分辨率,形成多尺度特征图,使模型能够预测不同尺寸目标的检测结果。
每个特征图,无论是已有基础网络特征图还是新增辅助特征图,都由卷积预测器处理。对于尺寸为 m×n、包含 p 个通道的特征图,在每个空间位置应用小型 3×3×p 卷积核。对于与该位置关联的每个 k 个默认框,卷积核输出四个坐标偏移和 c 个类别置信值,其中 c 是目标类别数量。这在每个位置产生 (c+4)k 个滤波器,并在整个特征图上产生 (c+4)kmn 个输出。预测器是卷积的而非全连接的,这使得检测结果能够与特征图保持空间对齐。如下面的框架图所示:
中心预测单元是默认框,它是 SSD 中锚框的对应物。默认框以卷积方式分配到每个特征图单元,因此每个默认框在其单元内的相对位置是固定的。每个位置的多个默认框提供不同尺度和长宽比。在每个位置,网络预测相对于默认框几何形状的偏移以及每个类别的置信得分。偏移输出不是绝对框坐标,而是相对于对应默认框的修正。
训练过程中的默认框平铺、尺度变化以及正负样本分配如下图所示:
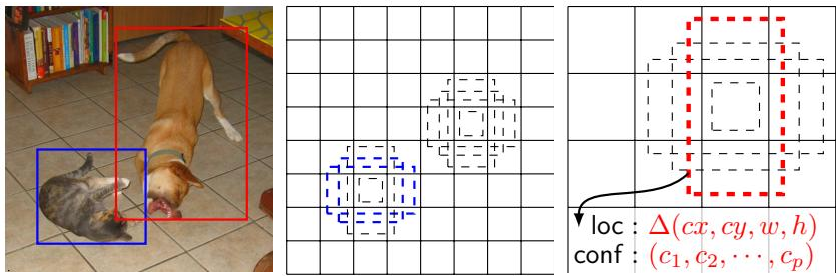
对于尺寸为 ∣fk∣ 的给定特征图位置处的默认框,其中心位于
(∣fk∣i+0.5,∣fk∣j+0.5),i,j∈[0,∣fk∣).该构造使网络能够通过组合多个特征图、多个位置、多个尺度和多个长宽比来离散化可能的目标框空间。
训练期间,真实框必须被分配到固定检测器预测集合中的特定输出。对于每个真实框,作者首先选择具有最佳 Jaccard 重叠的默认框。随后额外匹配所有与真实框 Jaccard 重叠大于 0.5 的默认框。这为某些真实框产生多个正样本匹配,并通过允许多个高质量框重叠来获得高分从而简化学习。其余未匹配框被视作负样本。
训练目标是定位损失和置信度损失的加权和。设 xijp∈{1,0} 表示第 i 个默认框是否与类别 p 的第 j 个真实框匹配。由于多个默认框可以匹配同一个真实框,∑ixijp≥1 是可能的。总损失为
L(x,c,l,g)=N1(Lconf(x,c)+αLloc(x,l,g)),其中 N 是匹配默认框的数量,α 通过交叉验证设置为 1。如果 N=0,损失设置为 0。
定位损失是预测框参数与真实框参数之间的 Smooth L1 损失。网络回归相对于默认框中心、宽度和高度的偏移:
Lloc(x,l,g)g^jcxg^jw=i∈Pos∑Nm∈{cx,cy,w,h}∑xijksmoothL1(lim−g^jm),=diwgjcx−dicx,g^jcy=dihgjcy−dicy,=log(diwgjw),g^jh=log(dihgjh).置信度损失是多个类别上的 softmax 损失。正默认框对其匹配类别贡献类别损失,而负默认框贡献背景损失:
Lconf(x,c)=−i∈Pos∑Nxijplog(c^ip)−i∈Neg∑log(c^i0),其中
c^ip=∑pexp(cip)exp(cip).分配给每个特征图的尺度是系统选择的,而不是依赖多个图像尺度。如果用于预测的特征图数量为 m,特征图 k 的尺度计算如下
sk=smin+m−1smax−smin(k−1),k∈[1,m],其中 smin=0.2 且 smax=0.9。这使得最低层特征图负责较小目标,最高层特征图负责较大目标。给定长宽比 ar 的默认框宽度和高度为
wka=skar,hka=arsk.作者使用长宽比 {1,2,3,21,31}。对于长宽比 1,还额外添加一个尺度为
sk′=sksk+1,这改善了相邻特征图尺度之间的覆盖。
匹配后,大多数默认框是负样本,从而造成严重的正负样本不平衡。为避免优化不稳定,作者采用难负样本挖掘。他们按置信度损失对负样本排序,并只保留最难负样本,使负正比例至多为 3:1。这使训练聚焦于信息量最大的背景区域,并提升优化速度和稳定性。
数据增强旨在使检测器对目标尺度、长宽比和光度变化具有鲁棒性。每张训练图像可采用以下多种方式之一:完整原始图像、与真实目标的最小 Jaccard 重叠被限制为 0.1、0.3、0.5、0.7 或 0.9 的采样图块,或完全随机图块。采样图块面积介于原始图像的 0.1 到 1 之间,长宽比介于 21 到 2 之间。如果真实框中心位于采样图块内部,则保留该真实框。随后将该图块缩放至网络输入尺寸,可选进行水平翻转,并添加光度失真增强。
对于小目标,随机裁剪通过在训练期间创建更大的目标实例而起到放大操作作用。裁剪前还可应用扩展操作:将图像随机放置在填充均值的更大画布上。这会创建更小外观目标,并提供具有不同相对尺度的额外训练样本。
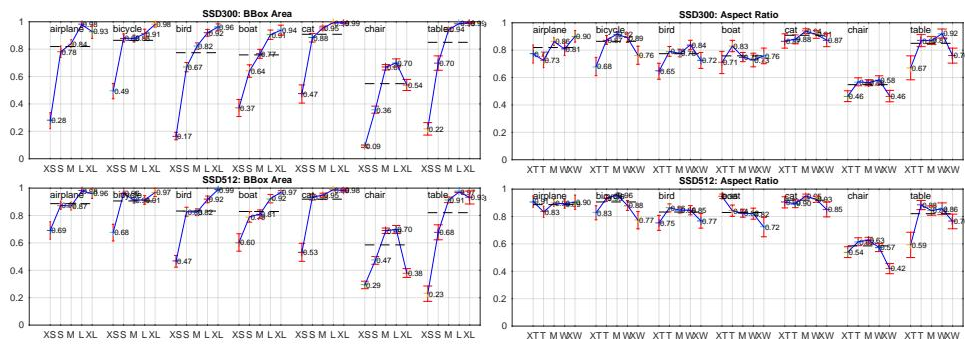
作者还分析检测质量如何随目标类别、边界框面积和长宽比变化。这些诊断揭示检测器遇到的错误类型,包括定位误差、与相似类别混淆以及对小目标或异常长宽比的敏感性。这些观察促使采用多尺度默认框设计、难负样本挖掘和激进的图块增强。类别级诊断如下图所示:
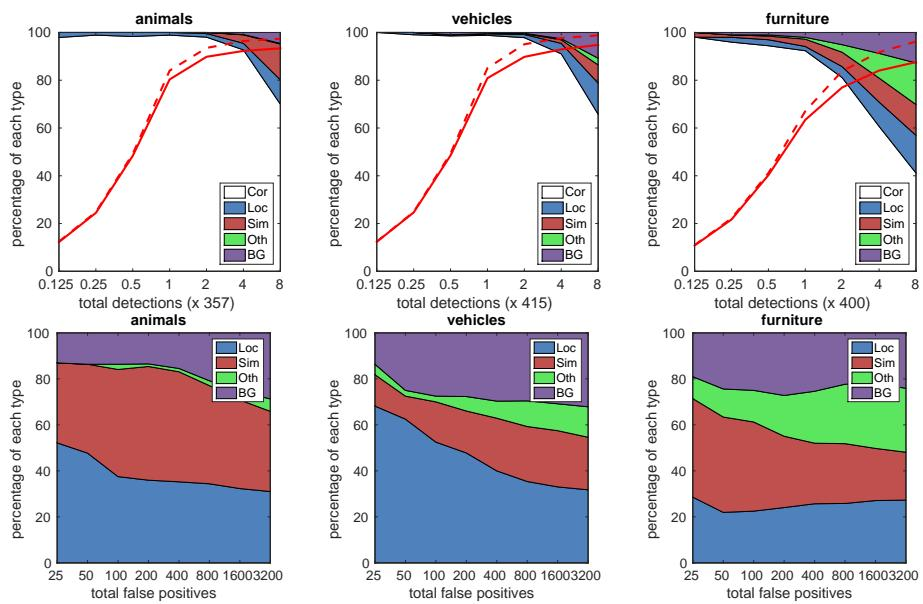
尺寸和长宽比诊断强调模型行为会随目标尺寸变化,尤其对于小边界框和非典型长宽比。这引导训练过程采用能反复使检测器暴露于多样裁剪尺度和空间布局的增强策略。
实验
实验使用基于 VGG16 的 SSD 架构,并在 PASCAL VOC2007 和 VOC2012、COCO 以及初步 ILSVRC 检测任务上进行评估。主要基准表明,SSD 在保持实时推理的同时,相对于 Fast R-CNN、Faster R-CNN 和 YOLO 提供相当或更优的检测准确率。额外模型分析验证了数据增强、多样默认框形状、空洞卷积和多分辨率特征图的作用,而基于增强的缩小策略和时间测量结果突出显示小目标性能提升和高效推理。
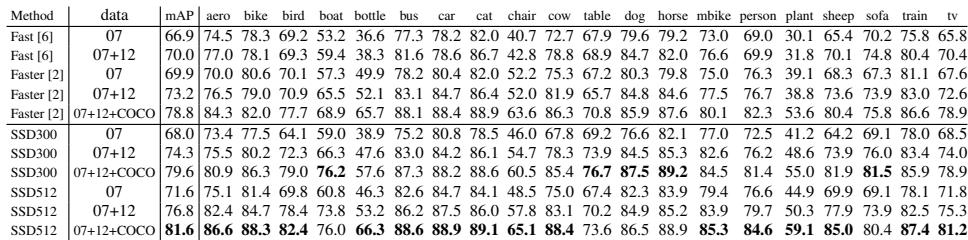
VOC2007 测试结果表明,增加训练数据可提升各种方法的检测准确率,其中 Faster R-CNN 在结合 VOC2012 和基于 COCO 的训练时获得最显著提升。SSD300 从更大训练集中获益明显,并变得与仅在 VOC2007 上训练的 Faster R-CNN 相当。报告结果还表明,更大输入尺寸和额外数据有助于检测质量,尤其对小目标而言。Fast R-CNN 和 Faster R-CNN 在 07+12 上训练而非仅在 VOC2007 上训练时均有提升。添加 COCO 预训练使 Faster R-CNN 获得最强的整体检测准确率。SSD300 在 07+12 训练下显著提升,并接近在 VOC2007 上训练的 Faster R-CNN。
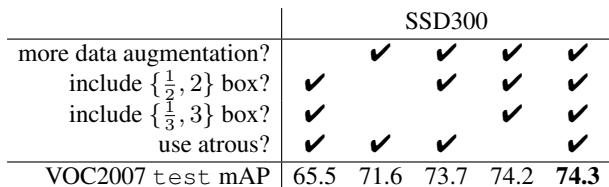
结果表明,更广泛的数据增强、更丰富的默认框形状、空洞卷积以及来自多个输出层的预测都有助于 SSD 性能。移除或减少这些组件会导致准确率更低或推理更慢,其中更少输出层导致检测质量单调下降。更多默认框形状通过使框预测更容易而提升检测准确率。空洞卷积在提供相近准确率的同时,比完整 VGG16 变体推理更快。
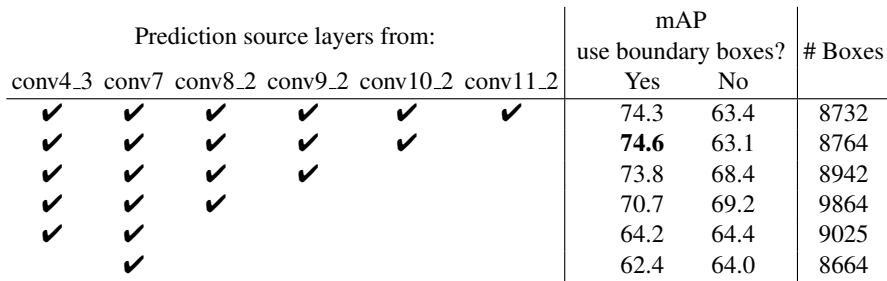
结果表明,即使保持默认框总数大致可比,来自不同分辨率多个输出层的预测源仍比更少层数的配置具有更高检测准确率。随着输出层被移除,准确率逐步下降。使用边界框在完整多层设置中最有帮助,而减少层数的设置带来明显更小的收益。多个预测层相较于仅使用部分层能够提升准确率。完整配置中边界框处理很重要,其效果随使用层数减少而减弱。
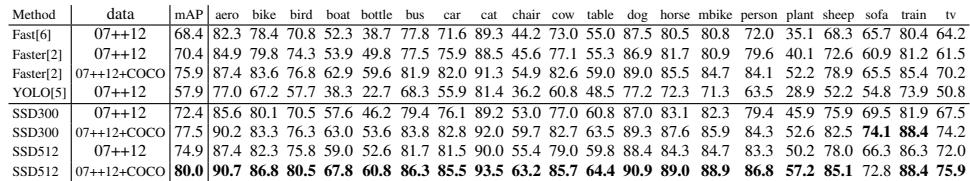
在 PASCAL VOC2012 检测中,SSD300 比在相同 VOC 数据上训练的 Fast R-CNN 和 Faster R-CNN 更准确,而 SSD512 因更大输入分辨率进一步获得准确率提升。SSD 模型明显优于 YOLO,而在 COCO 上预训练并在 VOC 上微调可提升 Faster R-CNN 和 SSD,其中 SSD512 达到最强 mAP。从 SSD300 到 SSD512 的更高输入分辨率提升检测准确率。COCO 预训练和 VOC 微调提升 Faster R-CNN 和 SSD 的 mAP。在 VOC2012 上,SSD 明显比 YOLO 更准确。
在 COCO 检测中,使用调整默认框训练的 SSD300 在 0.5 重叠平均精度和 0.5 到 0.95 重叠范围内均优于 Fast R-CNN。在更严格的 IoU 0.75 上接近 Faster R-CNN 和 ION,但在 IoU 0.5 上落后于二者。在 SSD512 中使用更大输入尺度对大目标带来更大收益,而不是小目标。SSD300 在 0.5 重叠和 0.5 到 0.95 重叠范围均比 Fast R-CNN 提升平均精度。SSD300 在 IoU 0.75 上具有有竞争力的精度,但在 IoU 0.5 上低于 Faster R-CNN 和 ION。SSD512 对比显示,大目标精度和召回率的提升大于小目标指标。
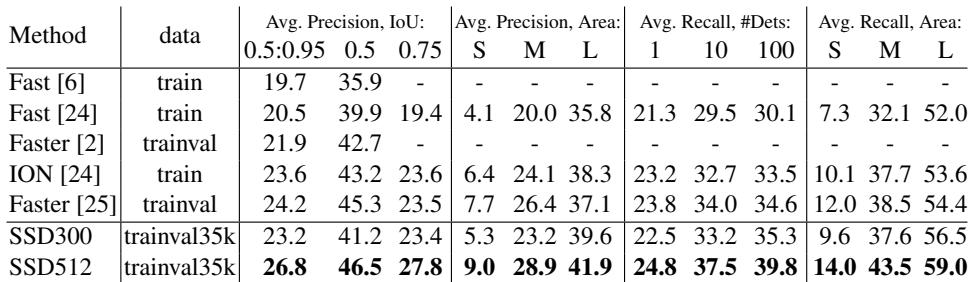
在 PASCAL VOC 和 COCO 上的实验比较了不同训练数据、输入分辨率和架构设置下的检测模型。结果表明,更大的训练集、COCO 预训练、更高输入尺寸、更丰富增强、多样默认框、空洞卷积和多层预测均能提升检测质量,尤其对于小目标和更严格重叠阈值。SSD 比 YOLO 更准确,与 Faster R-CNN 相当,并从多层默认框中获益,而更大输入对大目标帮助更大。