Command Palette
Search for a command to run...
Microsoft COCO:上下文中的常见物体
Microsoft COCO:上下文中的常见物体
Tsung-Yi Lin Michael Maire Serge Belongie Lubomir Bourdev Ross Girshick James Hays Pietro Perona Deva Ramanan C. Lawrence Zitnick Piotr Dollár
摘要
我们提出了一个新数据集,旨在将物体识别问题置于场景理解这一更广泛问题的背景之下,从而推动物体识别的最先进技术。我们通过收集包含自然场景中常见物体的复杂日常场景图像来实现这一目标。物体使用逐实例分割进行标注,以辅助精确的物体定位。我们的数据集包含 91 种物体类型的照片,这些物体是 4 岁儿童都能轻松识别的。在 328k 张图像中总共包含 250 万个标注实例,该数据集的创建依赖于大量众包工作者的参与,通过新颖的用户界面完成类别检测、实例定位和实例分割。我们与 PASCAL、ImageNet 和 SUN 数据集进行了对比,给出了该数据集的详细统计分析。最后,我们使用可变形部件模型(Deformable Parts Model)提供了边界框和分割检测结果的基线性能分析。
一句话总结
Microsoft Research 与学术合作者提出 COCO,这是一个在 32.8 万张图像中包含 250 万个有标注实例的数据集,对复杂日常场景中的常见对象进行实例级分割,将对象识别置于更广泛的场景理解之中,并提供与 PASCAL 和 ImageNet 的对比基线。
核心贡献
-
提出一个用于场景理解中对象识别的大规模数据集,包含 32.8 万张图像和跨越 91 个日常对象类别的 250 万个实例级分割对象标签。这些分割支持超出边界框的精确对象定位与评估。
-
提出将数据集与 PASCAL、ImageNet 和 SUN 进行统计比较分析。该分析刻画了数据集规模、对象类别、实例数量和富含上下文的图像集合。
-
使用 Deformable Parts Model 报告了基线边界框和分割检测结果。这些结果为在新数据集上的检测提供了评估参考。
引言
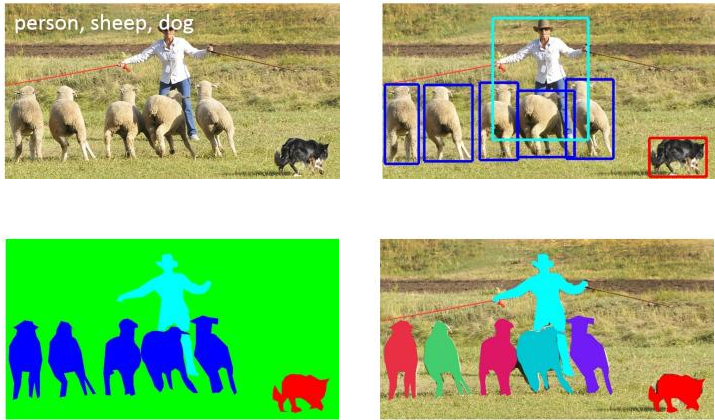
在计算机视觉中,场景理解需要能够识别对象、精确定位对象、推理其上下文并处理真实世界视觉复杂性的模型。现有数据集推动了对象分类与检测的发展,但许多数据集强调标志性对象视图、孤立对象或粗略的边界框标注,这限制了非典型视角、上下文推理以及准确的实例级空间理解的进展。作者通过 Microsoft COCO 数据集应对这一问题,该数据集收集了富含对象交互的日常场景图像,并为 91 个对象类别提供实例级分割掩码,在 32.8 万张图像中标注了超过 250 万个对象实例。这支持在包含杂乱、遮挡、小对象和每图多个对象等真实条件下进行对象检测与分割的训练和评估。
数据集
-
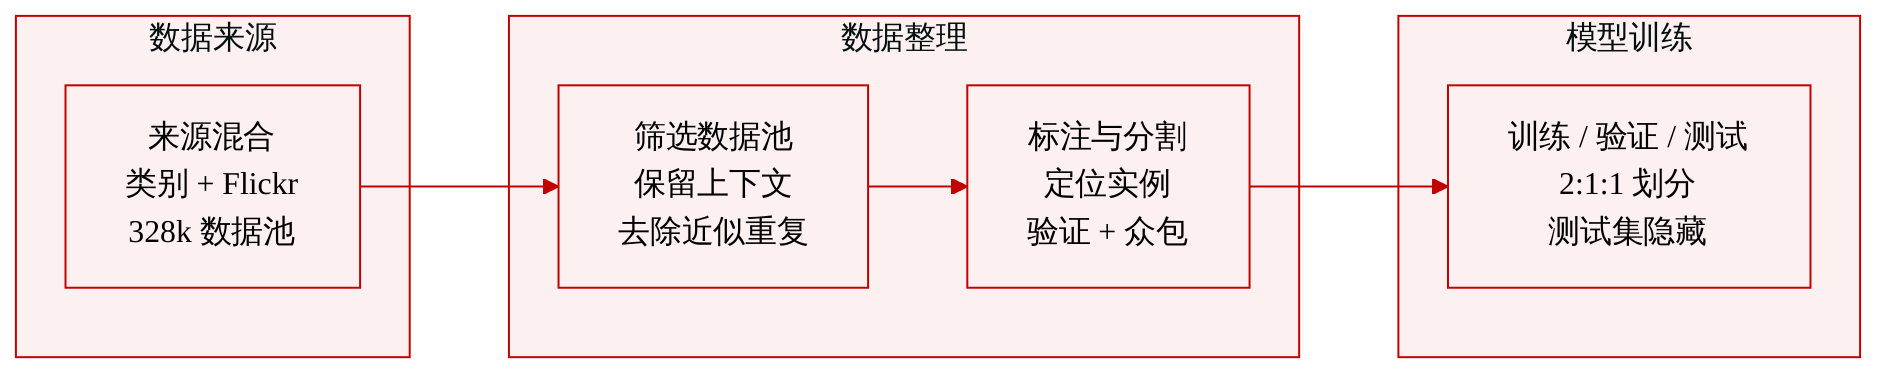
MS COCO 面向自然场景中日常对象实例的检测与分割。作者从一个广泛的可视觉识别对象类别列表开始,目标是为每个类别收集大量实例,并收集具有丰富对象上下文的图像,而不是孤立的标志性对象照片。
-
类别集合始于由 272 个候选类别组成的列表,这些类别来自 PASCAL VOC 类别、常见视觉对象词汇、WordNet、LabelMe 和 SUN 等来源的类别,以及从儿童那里获取的对象名称。合著者按频率、有用性和多样性对候选类别进行投票,然后从动物、车辆和家具等上级类别中均衡选择 91 个最终类别。最终类别是入门级“thing”类别,而不是“stuff”类别,并且难以获得超过 5,000 个实例的类别会被移除。为兼容性保留所有 PASCAL VOC 类别。
-
2014 版仅限于 80 个可分割类别。作者从分割中排除 11 个类别,包括 hat、shoe、eyeglasses、mirror、window、door、street sign、plate、desk、blender 和 hair brush,原因包括实例数量过多、标注歧义、与相关类别混淆或实例数量过少。
-
候选图像主要来自 Flickr,以偏好非标志性、上下文丰富的照片。作者不是搜索单个对象,这通常返回居中且标志性的图像,而是查询成对对象类别,例如 dog 加 car,以及对象与场景类别的组合。他们使用从 SUN 中选出的 40 个室内和室外场景类别来支持场景对象查询。
-
图像过滤关注多样性和上下文。在较短时间窗口内,同一摄影师最多下载五张照片,并明确移除近似重复图像。当使用成对查询找不到稀有类别时,则使用单类别搜索,随后由众包工人明确过滤标志性或无效图像。最终候选池包含约 32.8 万张图像,平均每个图像包含 3.5 个对象类别和 7.7 个对象实例。
-
数据集通过 Amazon Mechanical Turk 分三个阶段进行标注:类别标注、实例标记和实例分割。类别体系被组织为 11 个上级类别,以加速标注。对于每张图像,8 名工人指示某个上级类别中是否存在任一类别;如果存在,则将类别图标放置在该类别的一个实例上。
-
在实例标记阶段,8 名工人为每个已标注类别标记额外实例,每类别每图像最多 10 个实例。类别标注阶段找到的第一个实例会显示给工人,以帮助他们定位更多对象,并提供放大镜界面以支持小对象标注。
-
在分割阶段,每个标记出的实例只分割一次,前提是工人通过类别特定的训练任务。分割随后由多名工人验证,最初为三人,必要时增加至五人。质量较差的分割会被拒绝并重新加入未分割池,且持续表现较差工人的工作会被丢弃。
-
对于包含同一类别超过约 10 个实例的密集群组,作者使用单个可能多部分的分割将剩余对象标记为“crowd”。这些 crowd 区域在评估期间被忽略,不影响检测器分数。
-
MS COCO 数据集包含超过 250 万个对象实例的像素级实例分割,以及每张图像的五条 caption 标注。2014 版包含 82,783 张训练图像、40,504 张验证图像和 40,775 张测试图像。训练和验证图像包含约 88.6 万个分割对象实例,其中近 27 万个为 person。
-
计划中的累计 2015 版总计 165,482 张训练图像、81,208 张验证图像和 81,434 张测试图像。作者通过移除近似重复图像并按摄影师和拍摄日期分组图像来划分数据,以最大限度减少近似重复泄漏。
-
作者发布了训练和验证集标注,但为评估保留测试标注隐藏。本节没有描述具体的图像裁剪配方或训练混合比例;主要处理细节包括类别选择、图像收集与去重、分层标注、实例标记、分割验证、crowd 处理和划分构建。
方法
方法是一个分阶段众包标注流水线,而不是常规端到端模型。作者首先通过查询类别对或类别与场景组合构建非标志性图像池,然后要求工人移除无效和过度标志性的样本。在过滤界面中,指令具体性和视觉示例引导选择,候选图像以网格形式显示,便于高效取消选择。这一早期过滤步骤旨在标注开始前减少标志性偏差。
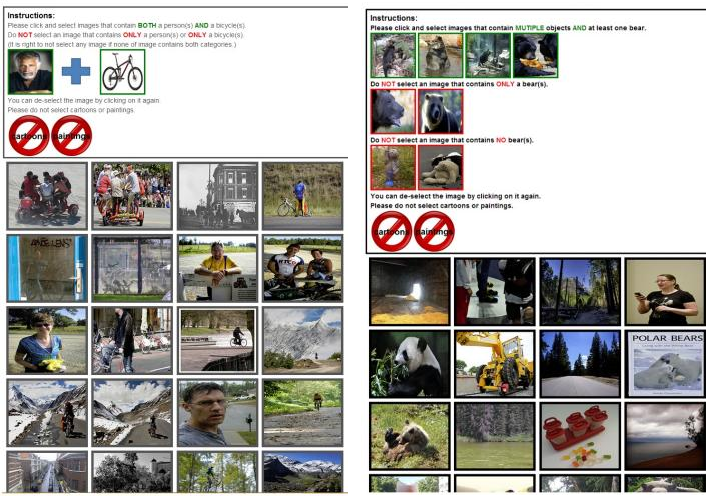
过滤后,每张图像进入类别标注阶段。由于类别空间较大,让工人为每张图像回答大量二选一问题效率很低。相反,作者将类别分组为上级类别。工人首先检查图像中是否出现上级类别的任何成员。如果上级类别存在,工人再将具体下级类别的图标拖放到一个可见实例上来识别具体类别。此阶段每个类别只需要一个示例,并且每张图像由多名工人标注以提高召回。误报随后通过额外阶段进行修正。
下一阶段是实例标记。对于上一步中识别出的每个类别,工人标记该类别的每个可见实例。流水线通过向工人显示类别标注阶段已经找到的实例来提高效率,这有助于工人快速理解图像内容。还提供放大工具,以支持检测小对象或难以看到的对象。工人在每个实例区域内放置十字标记,并在极端情况下限制每类别标注的实例数量。
成本最高的阶段是实例分割。作者修改了用于多边形标注的界面,并提供目标类别的视觉提醒,以及当存在时已完成的掩码。为控制成本,每个实例只分割一次,但流水线通过严格的工人培训和质量控制进行补偿。在执行正式分割之前,工人完成类别特定的训练任务,并且必须生成接近 ground truth 的掩码后才能获批。在分割过程中,工人也可以表明已标注类别不存在,或所有剩余实例都已被分割。
为避免重复分割,系统按顺序处理实例标注,并忽略已被现有掩码覆盖的实例位置。这可以防止不同工人反复分割同一对象。分割后,流水线增加验证。每个掩码由多名工人判断,质量较差的分割会被丢弃。被拒绝的实例返回未分割池以供重新处理。掩码反复未通过验证的工人会被移出已批准池。
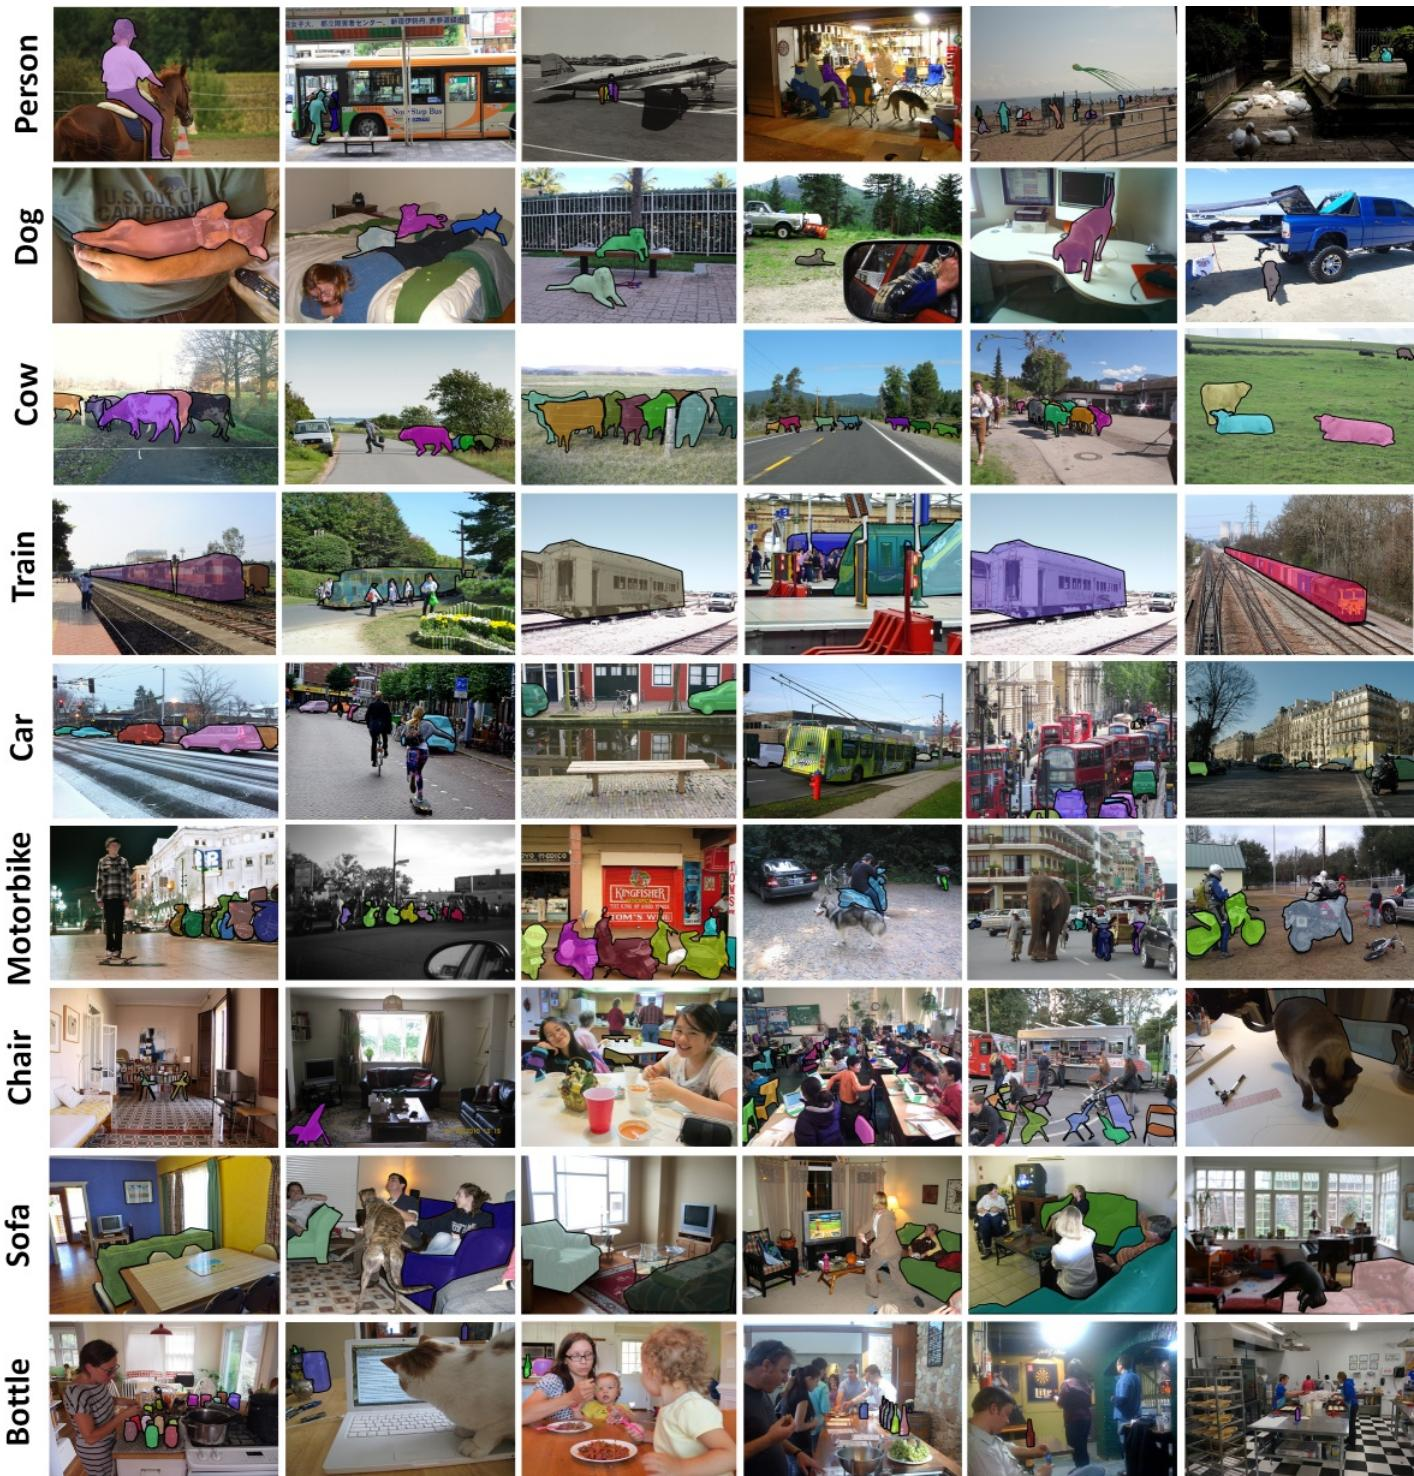
最后一个模块处理密集对象区域。当一张图像中出现同一类别过多实例时,逐个描绘每个对象会变得困难且不一致。在分割有限数量的实例后,剩余紧密排列的对象会被标记为 crowd 区域,而不是精确实例掩码。这些 crowd 区域降低标注成本,并承认高度聚集实例中的歧义,同时评估可以忽略这些区域。由此产生的示例说明了流水线产生的精确性和上下文多样性。
实验
实验使用紧边界框比较在 PASCAL VOC 和 MS COCO 上训练的 DPM 检测器,并且仅在检测正确时单独评估生成的分割掩码。结果显示,在 MS COCO 上性能显著下降,表明其难度更高,而 COCO 训练模型倾向于更好地泛化回 PASCAL,尽管困难、非标志性图像会带来与类别相关的影响。分割分析进一步表明,检测可以与掩码定位解耦,以评估细粒度部分边界,从而为数据集建立简单的掩码质量基线。
对比表明,MS COCO 比 PASCAL VOC 困难得多,无论使用 PASCAL 训练还是 COCO 训练模型,在 MS COCO 上评估时检测分数都会下降。在 MS COCO 数据上训练会在 PASCAL VOC 上产生混合结果,某些类别改善而另一些类别受损,这表明困难图像可以帮助某些对象类别,但对其他类别产生噪声。在 MS COCO 上测试时,COCO 训练模型的平均性能优于 PASCAL 训练模型。MS COCO 评估得到的检测性能低于 PASCAL VOC 评估。在少数 PASCAL 类别中,COCO 训练模型优于 PASCAL 训练模型。当模型在 MS COCO 上训练时,dog、cat 和 person 类别表现更差。bus、tv 和 horse 类别在 PASCAL VOC 上测试时受益于 MS COCO 训练。
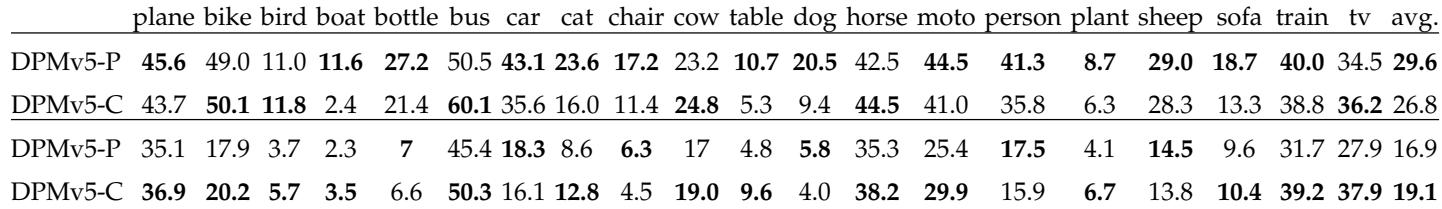
实验比较了在各自数据集上训练的模型在 PASCAL VOC 和 MS COCO 上的检测性能。结果显示,MS COCO 比 PASCAL VOC 困难得多,因为两个训练模型在 MS COCO 上的检测分数都下降,而 COCO 训练模型在 COCO 上取得更好的平均性能。在 MS COCO 上训练对 PASCAL VOC 有混合影响,改善 bus、tv 和 horse 等类别,但损害 dog、cat 和 person 等类别,这表明困难图像有助于某些对象类别,但对其他类别起到噪声作用。