Command Palette
Search for a command to run...
导航世界模型
导航世界模型
Amir Bar Gaoyue Zhou Danny Tran Trevor Darrell Yann LeCun
摘要
导航是具备视觉-运动能力的智能体的一项基本技能。我们提出了导航世界模型(NWM),一种可控视频生成模型,能够根据过去的观测和导航动作预测未来的视觉观测。为了捕捉复杂的环境动态,NWM 采用条件扩散 Transformer(CDiT),在大量人类与机器人智能体的第一人称视角视频上进行训练,并将规模扩展至 10 亿参数。在熟悉环境中,NWM 可以通过模拟导航轨迹并评估其是否达成期望目标来进行轨迹规划。与行为固定的监督导航策略不同,NWM 能够在规划过程中动态引入约束条件。实验表明,NWM 在从零开始规划轨迹以及对来自外部策略采样的轨迹进行排序方面均展现出有效性。此外,NWM 利用其学习到的视觉先验,仅凭单张输入图像即可想象陌生环境中的轨迹,使其成为面向下一代导航系统的灵活而强大的工具。
一句话总结
Meta 旗下的 FAIR、纽约大学和 Berkeley AI Research 提出 Navigation World Model (NWM),这是一个在多样化第一人称视频上训练的 10 亿参数 Conditional Diffusion Transformer,在熟悉环境中通过模拟并排序候选轨迹进行规划,并利用已学习到的视觉先验,在陌生环境中从单张图像想象路径,超越了监督式导航策略的固定行为。
核心贡献
- 该论文提出 Navigation World Model (NWM),这是一种可控视频生成模型,使用在大规模人类与机器人第一人称视频上训练并扩展到 10 亿参数的 Conditional Diffusion Transformer (CDiT),根据过去观察和导航动作预测未来第一人称观察。
- 该论文表明,NWM 支持基于模型的导航规划,通过模拟候选轨迹并评估目标达成,既能从零开始规划,也能对外部策略采样得到的轨迹进行排序,从而提升目标条件视觉导航性能。
- 该论文证明,在 Ego4D 等无动作、无奖励的第一人称视频数据上训练能够提升未见环境中的视频预测与生成能力,使 NWM 能够从单张输入图像想象合理的导航轨迹。
引言
视觉导航是机器人 agent 的核心能力,因为它要求构建可用于到达目标、避开障碍并在真实世界场景中运行的环境表示。以往的视觉导航策略通常是监督式、目标条件模型,在新约束出现时可能难以适配,并且无法轻松地把额外计算量分配给更困难的规划问题。现有世界模型和视图合成方法也往往局限于狭窄设置,或依赖结构化 3D 先验,限制了在多样环境和不同具体实现中的可扩展性。该工作通过引入在机器人视频和导航动作上训练的 Navigation World Model,以及能够高效预测未来视觉状态、支持模型预测规划和策略排序的新 Conditional Diffusion Transformer 架构来弥补这一缺口,同时也能借助无标注视频数据提升泛化能力。

方法
所提出的系统学习一个导航世界模型,作为随机状态转移函数。输入包括第一人称图像和导航指令。每张图像观察被编码为潜状态,每个动作包含平移和偏航控制信号。形式化地,模型从如下形式的序列进行训练
{(x0,a0,…,xT,aT)},其中 xi∈RH×W×3 是图像,ai=(u,ϕ) 是导航指令,u∈R2 控制前进和横向移动,ϕ∈R 控制偏航旋转。使用预训练 VAE 编码器将图像映射到压缩潜状态:
si=encθ(xi).世界模型随后基于当前状态、过去状态的短历史以及动作预测下一个潜状态:
sτ+1∼Fθ(sτ+1∣sτ,aτ),其中 sτ=(sτ,…,sτ−m)。这一表述支持不同环境和动作空间,因为模型在抽象潜状态上运行,而不是环境特定表示。
为了更明确地建模时间动态,动作会扩展一个时间偏移输入 k。动作变为
aτ=(u,ϕ,k),其中 k 指定应跨越多少未来或过去步骤。通过聚合中间动作,计算偏移区间的有效平移和旋转:
uτ→m=t=τ∑mut,ϕτ→m=t=τ∑mϕtmod2π.这使模型能够学习控制效果以及环境中的被动时间变化。在训练过程中,会从同一上下文中采样多个可能目标,以降低时间与动作之间的纠缠。
核心预测器由条件扩散 Transformer 实现,并作为未来潜状态上的去噪模型进行训练。该架构采用时间自回归设计。正在生成的目标帧中的 tokens 通过自注意力相互关注,而过去帧通过交叉注意力提供上下文信息。这使主要自注意力计算限制在目标帧,并将过去潜状态用作键和值以提供上下文。参考架构图:
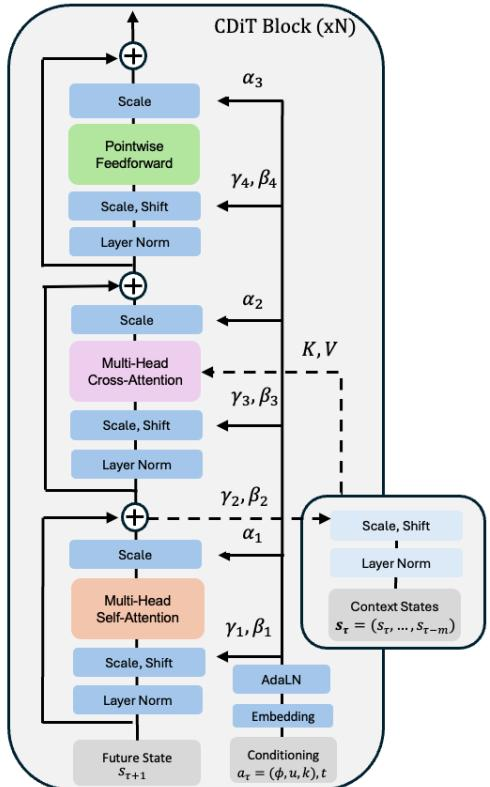
条件信号结合导航动作、时间偏移和扩散时间步。每个标量分量首先通过正弦与余弦特征和小型 MLP 提升维度,然后拼接或投影到模型维度。最终条件向量通过对动作嵌入、时间偏移嵌入和时间步嵌入求和形成:
ξ=ψa+ψk+ψt.该向量输入自适应层归一化模块,产生用于调制 Transformer 子层的缩放和偏移参数。当导航动作不可用时,可以省略动作嵌入,使同一架构能够在无标注视频序列上训练。
这种设计的计算优势来自其注意力结构。在所有帧上运行标准 Transformer 时,注意力开销主要由总上下文长度的平方主导。所提出的块使用目标帧自注意力与面向过去帧的交叉注意力,使开销随上下文帧数线性增长。如果 n 表示每帧的 tokens 数量,m 是帧数,d 是 token 维度,这会将主要开销从完整序列长度的平方降低到帧数的线性关系。
训练遵循标准扩散过程。在前向过程中,根据随机采样的扩散时间步 t,向干净的未来潜状态 sτ+1 添加高斯噪声:
sτ+1(t)=αtsτ+1+1−αtϵ,ϵ∼N(0,I),其中 {αt} 是噪声调度。网络训练目标是从带噪状态恢复干净潜状态,并以上下文、动作和扩散时间步为条件。主要目标是均方预测损失:
Lsimple=Esτ+1,aτ,sτ,ϵ,t[sτ+1−Fθ(sτ+1(t)∣sτ,aτ,t)22].该模型还可以预测扩散噪声的协方差,并可以用变分下界项训练。
训练完成后,世界模型可通过展开候选导航动作并对由此得到的未来状态评分用于规划。给定初始潜状态 s0 和目标潜状态 s∗,目标是寻找最大化到达目标似然的动作序列。这用一个能量函数表达,该函数惩罚与目标相似度低、无效动作或不安全状态:
E(s0,a0,…,aT−1,sT)=−S(sT,s∗)+τ=0∑T−1I(aτ∈/Avalid)+τ=0∑T−1I(sτ∈/Ssafe).目标相似度 S(sT,s∗) 可以通过 VAE 解码器将潜状态解码回像素空间并测量感知相似度来计算。然后可以通过在未来动作序列上最小化该能量,将规划表述为模型预测控制问题。实践中,可以使用交叉熵方法等无导数群体优化在动作空间中搜索。同一能量还可以通过选择能量最低的采样展开来排序现有导航策略提出的轨迹。
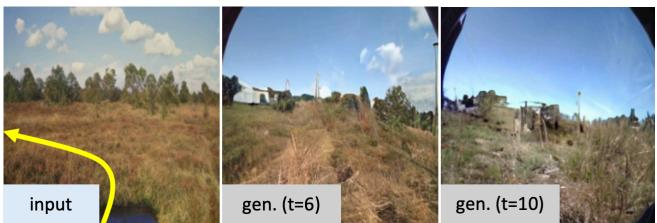
当模型应用于训练分布之外时,长时域想象轨迹可能缓慢偏离真实视觉上下文。生成的未来帧可能逐渐被常见训练模式主导,而不是当前观察。这种行为在生成的未来帧中可见,如定性示例所示:
实验
实验在多个机器人导航数据集上评估导航世界模型,重点评估未来视频预测、生成质量、规划,并通过与以往基线比较来衡量对未见环境的泛化。消融实验表明,使用上下文条件模型、多个目标、充足时间上下文以及时间和动作输入能够提升预测准确性。进一步测试表明,该模型能够实现有效的目标条件和受限规划,能够改进现有导航策略的轨迹排序,并从无标注视频中获得更好的未知场景迁移,尽管这会增加一些幻觉。
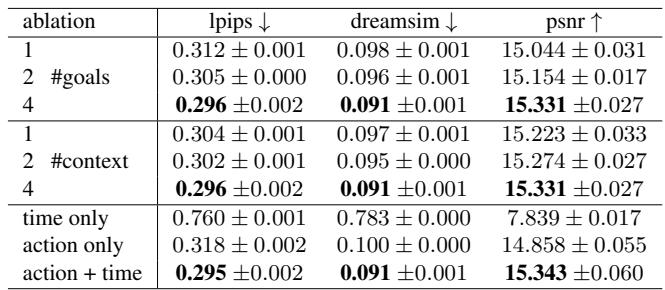
在 RECON 上进行四秒未来预测时,使用更多预测目标和更多条件上下文会持续改善预测帧质量。仅以时间为条件的预测明显差于目标条件设置,凸显视觉目标信息的重要性。在所有报告指标上,四个目标优于一或两个目标。更长上下文有助于预测,而短上下文会导致更差跟踪。
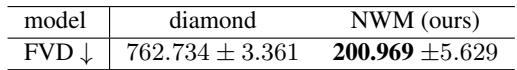
结果比较了导航模型和视频模型在预测未来观察和合成长 rollout 上的表现。所提出的 NWM 的视频合成质量显著优于 diamond 基线;评估在相同计算预算下使用更低感知误差来表示更好的未来预测。相对 diamond 基线,NWM 大幅降低 FVD,表明生成视频更真实。未来预测质量通过感知误差与计算成本衡量,较低 LPIPS 表示更准确预测。
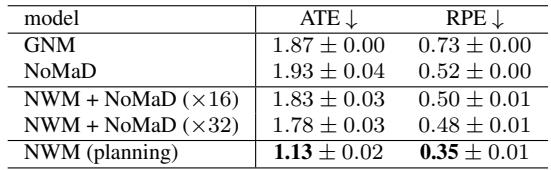
NWM 在目标条件视觉导航的 2 秒轨迹预测上优于 GNM 和 NoMaD,在报告方法中取得最佳 ATE 和 RPE。当使用 NWM 对 NoMaD 轨迹排序时,也改善平移误差和旋转误差,更多采样轨迹带来更好结果。NWM 规划在比较的导航方法中产生最低 ATE 和 RPE。基于 NWM 的轨迹排序在 ATE 和 RPE 上均提升 NoMaD 性能。使用更多经 NWM 排序的轨迹会进一步提升导航准确性。
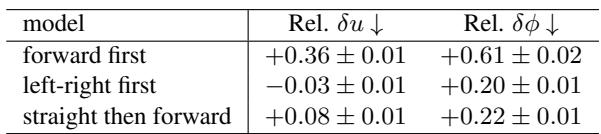
受限规划在最终位置和偏航上都接近无约束基线,表明 Navigation World Model 能够在不显著降低目标导向行为的情况下遵循动作限制。前向优先约束产生最大相对漂移,而左右优先和先直行后前向约束的变化较小。整体结果支持在运动被限制为预定义动作模式时进行有效规划。所有测试的运动约束都得到满足,同时最终位姿变化相对于无约束规划保持较小。前向优先规划在偏航上表现出最大敏感性,而左右优先具有最小位置漂移。与基线相比,先直行后前向规划使最终位置和偏航均产生小幅增加。
在域内数据之外添加无标注 Ego4D 视频能够改善未见环境中的未来预测质量,在 Go Stanford 上具有更低感知误差和更高 PSNR。相同变化会降低已知 RECON 环境中的预测质量,感知指标变差且 PSNR 下降。整体结果说明,无标注数据有助于向新环境泛化,但在熟悉数据上引入权衡。无标注 Ego4D 训练在 LPIPS、DreamSim 和 PSNR 上改善未知环境指标。添加无标注数据后,已知环境性能下降。观察到的增益在未见数据上较小但一致。

在 RECON 和目标条件导航基准上,实验评估未来帧预测、更长视频 rollout、轨迹排序、受限规划和跨环境泛化。目标条件、额外预测目标和更长上下文能够改善预测帧质量,而 NWM 在未来预测上优于基线导航和视频模型,合成更真实 rollout,并改善 NoMaD 轨迹排序。在动作限制下,该模型保持接近无约束的目标导向行为;添加无标注 Ego4D 视频有助于未见环境预测,但会牺牲部分已知环境准确性。