Command Palette
Search for a command to run...
生成式图像动力学
生成式图像动力学
Zhengqi Li Richard Tucker Noah Snavely Aleksander Holynski
摘要
我们提出了一种对场景运动的图像空间先验进行建模的方法。该先验从一组运动轨迹中习得,这些轨迹提取自真实视频序列,描绘了树木、花朵、蜡烛和衣物等在风中摇曳等自然振荡动力学。我们在傅里叶域中将稠密的长期运动建模为频谱体积(spectral volumes),并发现频谱体积非常适合使用扩散模型进行预测。给定单张图像,训练好的模型利用频率协调的扩散采样过程预测频谱体积,该体积可转换为覆盖整个视频的运动纹理。结合基于图像的渲染模块,预测的运动表示可用于多种下游应用,例如将静态图像转换为无缝循环视频,或允许用户与真实图像中的物体进行交互以生成逼真的模拟动力学(通过将频谱体积解释为图像空间模态基)。更多结果请访问我们的项目页面:generative-dynamics.github.io。
一句话总结
谷歌研究院提出在傅里叶域中将稠密长期运动建模为频谱体积,并由从真实视频提取的自然振荡轨迹训练得到的扩散模型预测这些频谱体积,从而将静止图像转换为无缝循环视频,或通过图像空间模态基实现交互式动画。
核心贡献
-
从树木、花朵、蜡烛和服装的真实视频中提取的运动轨迹,得到可学习的图像空间自然振荡场景运动先验,并在傅里叶域中将稠密长期运动表示为频谱体积。
-
频率协调扩散采样模型从单张图像预测频谱体积,并将预测频谱体积转换为跨越视频的运动纹理。使用傅里叶域频谱体积,是因为它们非常适合生成式运动预测。
-
基于图像的渲染使用预测频谱体积生成无缝循环视频、运动编辑和交互式动态图像,这些图像通过将频谱体积解释为图像空间模态基,响应用户施加的力。
引言
自然场景包含细微振荡,重现这种运动对视觉内容合成很重要,因为观众会很快注意到缺失或不真实的运动。现有生成式视频模型常常难以处理连贯的长期运动、时间纹理漂移和物理合理性,而图像动画方法可能需要驱动视频、用户标注或受限的运动表示,许多运动预测方法则聚焦于光流或识别,而非面向合成的可训练运动先验。作者通过以称为频谱体积的频域表示,学习图像空间场景运动的生成先验来处理这一问题。他们从真实视频中提取稠密长程像素运动轨迹,训练扩散模型从单张图像预测频谱体积,并使用共享注意力在不同频率间协调预测。最终模型可将静止图像转换为动画,支持无缝循环和运动编辑,并通过将学习到的运动用作图像空间模态基来实现交互式动态图像。

数据集
-
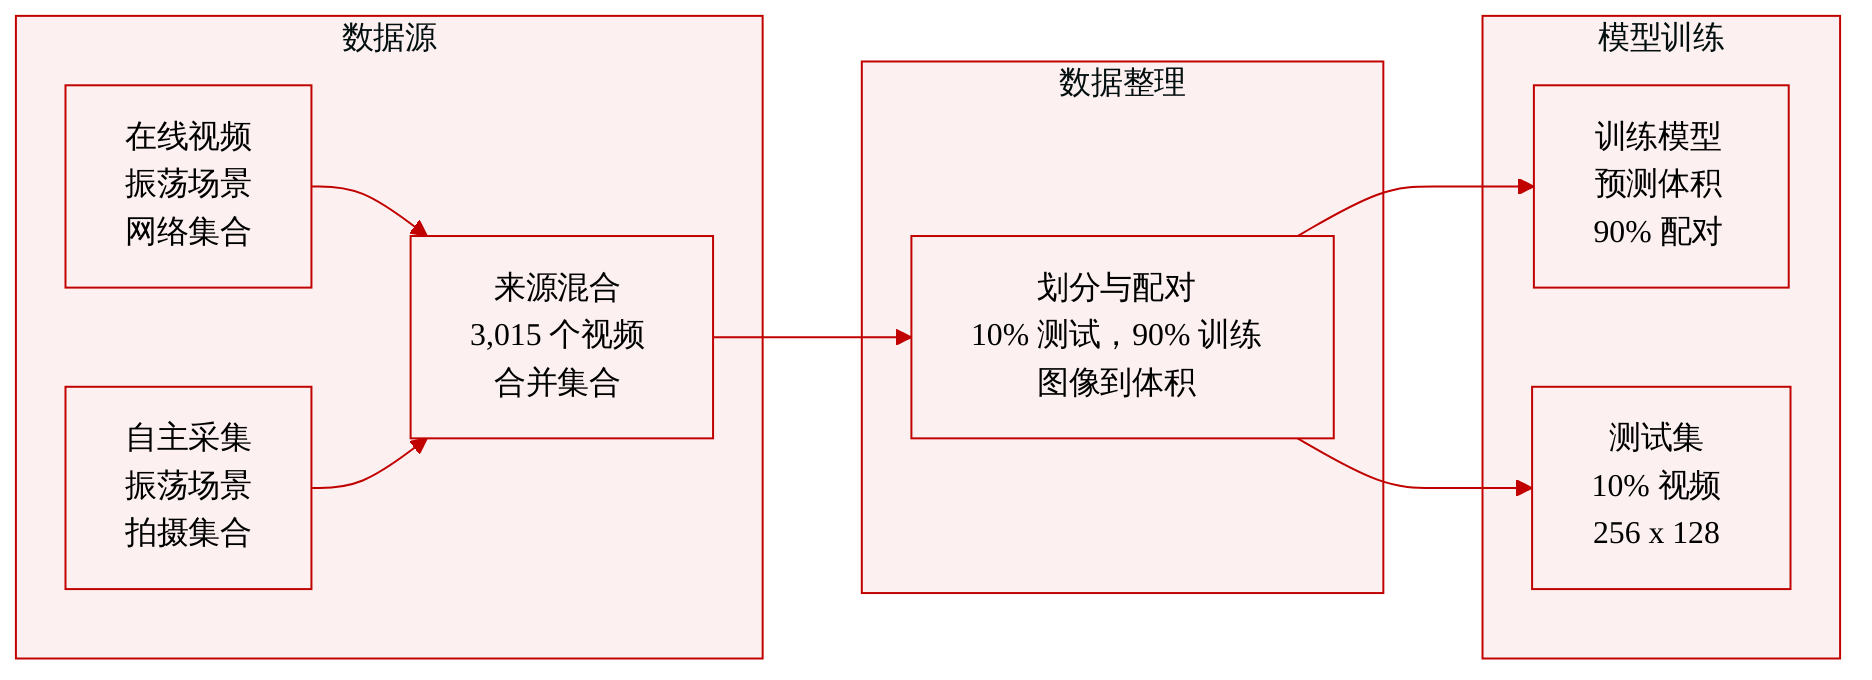
作者使用包含 3,015 段展示振荡运动的自然场景视频的视频数据集,这些视频来自在线来源以及自有采集。
-
数据划分在视频级别进行:保留 10% 的视频用于测试,其余 90% 用于训练。
-
为了监督,作者使用由粗到细的光流方法,在每一个选定起始帧和后续帧之间提取真实运动轨迹。
-
训练样本通过每隔 10 帧选取一个视频帧作为输入图像构造,并根据随后 149 帧上的运动轨迹计算对应的真实频谱体积。
-
由此得到的训练对总数超过 150K 个从图像到频谱体积的示例。
-
对于定量评估,VAE 和潜在扩散模型在 256 × 160 分辨率图像上训练;指标评估使用 256 × 128 的居中裁剪帧。
方法
作者构建一个两模块图像到视频系统。给定单张静止图像 I0,目标是生成一个展示准周期运动的序列 {I^1,I^2,…,I^T},例如植被摇曳或火焰闪烁。第一模块预测未来像素运动的紧凑表示,第二模块使用该运动对输入图像进行动画化。这种分离使模型能够直接在频域中推理运动,同时保留原始照片的外观。
在运动表示层面,作者不预测时间域中完整的稠密位移图序列。运动纹理是二维位移场序列 F={Ft}t=1T,其中每个 Ft(p) 将 I0 中的像素 p 映射到其在时间 t 的未来位置。使用这种场进行正向变形会产生不完整的变化帧,
It′(p+Ft(p))=I0(p).直接预测全部 T 个位移场会使输出表示随视频长度增长,而独立预测的帧往往随时间漂移。相反,作者在时间傅里叶域中将逐像素轨迹表示为频谱体积
S(p)=FFT(F(p)).因此,频谱体积是像素运动的频率空间编码。通过逆傅里叶变换可恢复时间域运动纹理,
F(p)=FFT−1(S(p)).由于许多自然振荡由低频主导,模型不需要表示完整的时间频谱。作者保留少量 K 个频率分量,满足 K≪T,实际使用前 K=16 项。该选择受到观察到的运动能量随频率升高而衰减现象的驱动。使这些系数适合扩散训练所使用的频谱分布和归一化策略如下图所示:
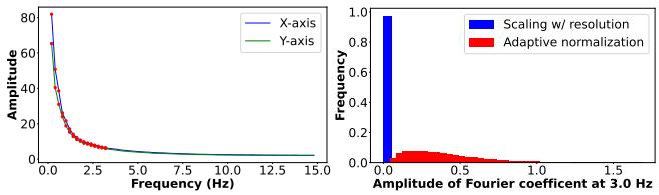
该图说明频率感知归一化为何重要。原始频谱系数可能在低频处具有较大振幅,并在较高频率处呈现快速衰减的量级。如果仅按图像尺寸缩放所有系数,高频项会坍缩到零,并且小的去噪误差会在逆傅里叶变换和反归一化后变得很大。为避免这一点,作者计算每个频率的缩放因子 sfj,将其取为训练数据中系数幅度的第 95 百分位数,然后施加带符号平方根变换,
Sfj′(p)=sign(Sfj(p))sfjSfj(p).这使每个频带保持在更稳定的数值范围内,同时保留频带内的相对变化。
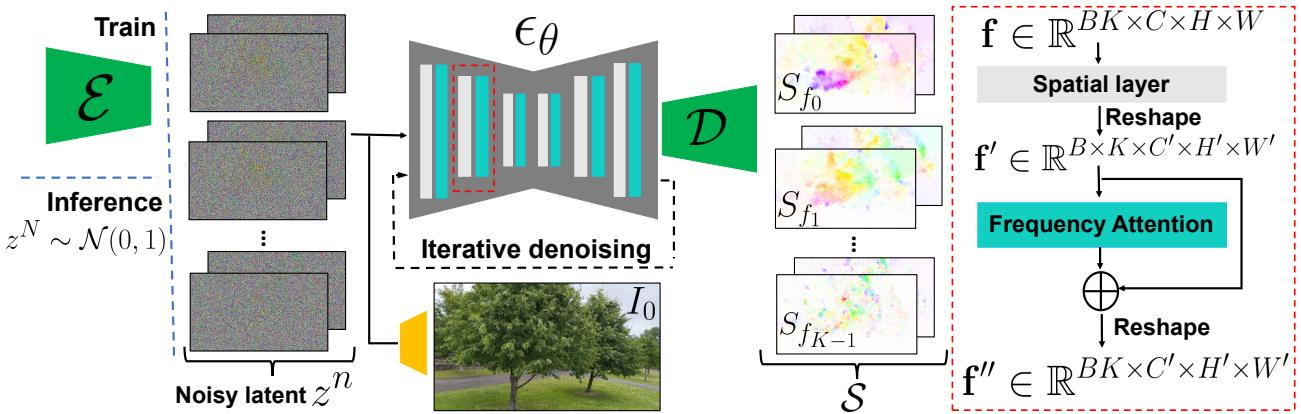
对于运动预测,作者采用潜在扩散模型而非像素空间扩散模型。系统首先通过变分自编码器编码器将频谱体积编码为潜在特征,根据扩散日程添加噪声,并训练 U-Net 去噪器估计注入噪声。在训练期间,模型以首帧 I0 为条件,因此学习到的运动先验依赖于图像。标准潜在扩散训练目标为
LLDM=En∈U[1,N], ϵn∼N(0,1)[∥ϵn−ϵθ(zn;n,c)∥2],其中 zn 是真实频谱体积的含噪潜在表示,n 是扩散时间步,c 是条件信号。在推理时,去噪从高斯噪声开始,去噪后的潜在特征被解码回预测频谱体积 S。
运动预测架构如下图所示:
一个关键设计问题是如何输出多个频带,同时不产生过度平滑或时间上不一致的运动。直接方案是训练一个 U-Net 输出具有 4K 通道的张量,其中每个频率为水平和竖直位移分量贡献复傅里叶系数。然而,一次生成许多通道可能导致过度平滑且不准确的运动。另一种选项是使用频率嵌入独立预测每个频率切片,但这会破坏频率之间的相关性,并产生不真实的轨迹。
为了在表达能力和一致性之间取得平衡,作者使用频率协调去噪模块。他们首先训练一个基础扩散模型,对单个 4 通道频率切片进行去噪,并在时间步嵌入旁边注入频率嵌入。随后冻结该基础模型,并在 U-Net 的空间层之间插入注意力层。这些注意力层在 K 个频带上运行。在它们的中间特征张量中,对应不同频率的 B⋅K 个样本首先被视作独立的空间批次,
R(B⋅K)×C×H×W,然后重新塑形,以便沿频率轴应用注意力,
RB×K×C×H×W.在频率注意力之后,特征被重新塑形回空间批次布局。以这种方式,每个频率切片与其他频率切片联合去噪,使模型能够在低频和较高运动模式之间强制形成一致的频谱结构。去噪后的潜在特征最终被解码为完整频谱体积。
预测出频谱体积后,通过在每个像素处进行逆时间傅里叶变换,将其变换回运动纹理。随后,渲染模块使用该运动纹理将输入图像正向变形到未来帧。由于正向变形会在没有源像素落点的位置产生空洞,也会导致多个源像素碰撞到同一目标位置,作者不依赖简单的像素溅射。相反,他们使用具有特征金字塔 softmax 溅射操作的深度基于图像的渲染架构。
渲染流程如下图所示:

渲染器首先通过特征提取网络将 I0 编码为多个特征尺度。对于每个尺度,运动场 Ft 被调整大小并缩放,以匹配特征分辨率。作者还计算由运动导出的权重,
W(p)=T1t∑∥Ft(p)∥2,这些权重估计每个像素处的平均运动幅度。在单视角设置中,这提供了类似深度的代理:具有大幅运动的像素被视为应主导其目标位置的前景元素,而静止或缓慢移动的像素被视为背景。随后,softmax 溅射使用 Ft 和 W 将多尺度特征投影到目标帧。
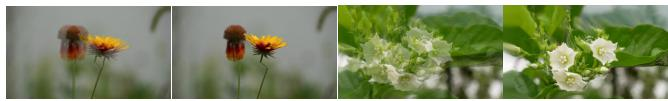
变形的多尺度特征被注入合成网络,该网络填补缺失内容并细化正向变形图像,以生成最终渲染帧 I^t。特征提取网络和合成网络在视频对上进行联合训练。对于一对 (I0,It),网络被训练为使用从 I0 到 It 的真实流场对来自 I0 的编码特征进行变形,并使用 VGG 感知损失对 It 监督预测。由于渲染器依赖于投影特征,其输出天然对细长移动物体、大位移以及需要大量新内容的区域敏感。这些失败案例如下可见:
频域运动表示还支持额外的推理时控制。为了实现无缝循环,作者在去噪过程中添加运动自引导信号。在去噪步骤 n,预测位移场 F1n 和 FTn 在位置和空间梯度两方面被比较,由此得到的引导项鼓励起始状态和结束状态匹配:
ϵ^n=(1+w)ϵθ(zn;n,c)−wϵθ(zn;n,∅)+uσn∇znLgn,其中
Lgn=∥FTn−F1n∥1+∥∇FTn−∇F1n∥1.这里 w 控制无分类器引导,u 控制循环引导强度。这使得在普通非循环片段上训练的模型能够生成满足循环约束的视频,而无需改变学习到的运动先验。
同一频谱体积还可用于交互式动力学。频率切片 Sfj 可作为图像空间运动模态,并通过使用随时间变化的模态坐标 qfj(t) 调制这些模态,生成物理响应,
Ft(p)=fj∑Sfj(p)qfj(t).模态坐标可以在模态空间中用解耦质量弹簧阻尼系统模拟,从而允许用户定义的力从单张静止图像驱动振荡。这将学习到的频谱体积从被动运动预测器转变为可用于下游动画控制的可解释运动基。
实验
实验在收集的振荡视频数据集上评估频谱体积动画,并与单图像动画、视频预测以及大型视频扩散基线进行比较,使用图像和视频质量指标、时间稳定性分析以及定性比较。结果表明,频率协调扩散模型能够生成更真实、时间更连贯的视频,而没有先前方法中随时间退化。消融实验和用户研究进一步验证了关键模型组件的重要性,并显示相较于大型视频模型有强烈偏好,而讨论部分指出对非振荡或高频运动的限制。
定量测试集比较表明,所提出的单图像动画方法在图像和视频合成指标上优于先前基线。对于 FVD 和 DT-FVD 等视频距离,改善尤为明显,表明动画更真实且时间更连贯。质量随时间的稳定性归因于全局频谱体积表示。该方法相较先前单图像动画基线同时改善图像合成和视频合成。FVD 和 DT-FVD 的更大降低指向更好的真实性和时间连贯性。全局频谱体积表示有助于随时间维持视频质量。
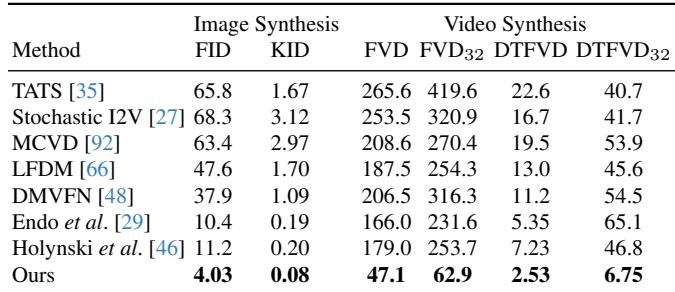
消融结果表明,使用更多频带通常可改善视频合成质量,在较低频带数量时增益更大,而超过 16 个频带后改善更有限。移除自适应归一化或频率协调去噪模块会导致图像和视频合成质量低于完整配置。视频合成质量随频带增加而提升,但在 16 个频带后收益变得边际化。移除自适应归一化或独立频率预测会产生比完整模型更差的视频指标。
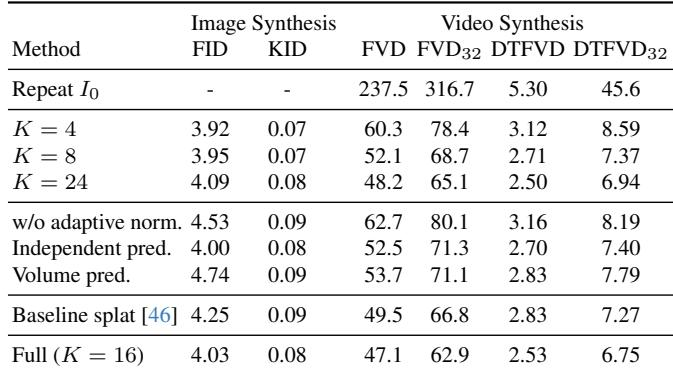
定量测试集比较表明,所提出的单图像动画方法在图像和视频合成上均优于先前基线,在真实性和时间连贯性方面提升尤其强。消融研究表明,增加频带通常能提升视频质量,尽管收益在 16 个频带后趋于平台,并且自适应归一化和频率协调去噪对于保持图像和视频保真度很重要。总体来看,全局频谱体积表示和完整模型有助于形成更稳定、时间上连贯的动画。