Command Palette
Search for a command to run...
你只需看一次:统一、实时的目标检测
你只需看一次:统一、实时的目标检测
Joseph Redmon Santosh Divvala Ross Girshick Ali Farhadi
摘要
我们提出了 YOLO,一种全新的目标检测方法。以往的目标检测工作将分类器改造为检测器。我们将目标检测重新建模为一个回归问题,直接预测空间上分离的边界框及其对应的类别概率。单个神经网络能够在一次前向传播中,从完整图像直接预测边界框和类别概率。由于整个检测流水线仅由一个网络构成,因此可以直接以检测性能为目标进行端到端优化。我们提出的统一架构具有极高的推理速度。基础版 YOLO 模型能够以每秒 45 帧的速度实时处理图像。该网络的一个更小版本 Fast YOLO 更是达到了惊人的每秒 155 帧的处理速度,其 mAP 仍比其他实时检测器高出一倍。与当前最先进的检测系统相比,YOLO 会产生更多的定位误差,但在背景上预测出假阳性的可能性更低。最后,YOLO 能够学习到非常通用的物体表征。在从自然图像泛化到艺术品等其他领域时,其性能优于包括 DPM 和 R-CNN 在内的其他检测方法。
一句话总结
华盛顿大学、Allen Institute for AI 和 Facebook AI Research 提出 YOLO。它将目标检测重新表述为单网络回归问题,直接从整幅图像预测边界框和类别概率,实现 45 FPS 实时运行,并在向艺术作品的跨域泛化方面优于 DPM 和 R-CNN。
核心贡献
-
引入 YOLO,这是一种单一卷积网络,将目标检测重新表述为从全图像像素回归到边界框坐标和类别概率,使端到端优化能够直接针对检测性能。
-
展示实时检测:基础 YOLO 模型在 Titan X GPU 上以每秒 45 帧运行,Fast YOLO 达到每秒 155 帧,同时取得其他实时检测器两倍以上 mAP。
-
表明全图像上下文将背景误报减少到 Fast R-CNN 的一半以下,并且在从自然图像泛化到艺术作品时,YOLO 优于 DPM 和 R-CNN。
引言
作者研究目标检测,这是一个计算机视觉任务,系统必须识别图像中存在什么物体、它们位于何处以及它们如何交互。这对自动驾驶、辅助视觉设备和响应式机器人等应用很重要,这些应用需要快速准确的感知。
先前的检测方法主要通过扫描大量位置和尺度,或先产生候选区域再进行分类,从而复用图像分类器。这些方法通常依赖复杂的多阶段流程,并且需要分别训练,这使它们更慢且更难优化。它们还可能难以处理背景错误和有限的上下文理解。
为应对这些挑战,作者提出 YOLO,将目标检测重新表述为单一回归问题。它使用一个卷积网络,直接从整幅图像预测边界框和类别概率。这种设计支持实时性能,更强地利用全局上下文,并提高对新域的泛化能力,同时在精确定位上牺牲一些准确率,尤其是在小物体上。
方法
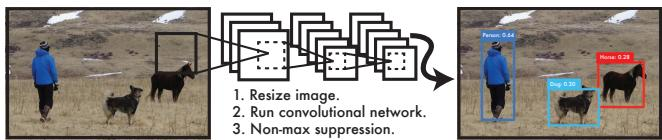
作者利用统一的卷积检测器,用单一神经网络取代多阶段检测流程。模型使用来自整幅输入图像的特征,同时预测边界框和类别概率,这使网络能够推理整个场景,而不是将检测视为一系列独立候选区域和分类器。
图像被划分为 S×S 网格。如果物体中心落入某个网格单元,该网格单元负责检测该物体。每个单元预测 B 个边界框以及置信度分数。置信度分数表示该单元包含物体的概率,以及预测框的预期准确度:
Confidence=Pr(Object)×IOUpredtruth.如果单元不包含物体,期望置信度为零。如果包含物体,置信度应近似于预测框与真实标注之间的交并比。每个框由五个值表示:中心坐标 (x,y)、宽度 w、高度 h 和置信度。中心坐标被参数化为相对于对应网格单元的偏移,而宽度和高度相对于整幅图像归一化。
每个网格单元还预测条件类别概率 Pr(Classi∣Object)。这些概率以该单元中存在物体为条件。在推理时,将条件类别概率乘以框置信度,得到特定类别分数:
Pr(Classi∣Object)×Pr(Object)×IOUpredtruth=Pr(Classi)×IOUpredtruth.该分数同时编码类别出现在框内的可能性,以及预测框与物体的匹配程度。对于标准配置 S=7、B=2 和 C=20,网络输出 7×7×30 预测张量。
检测器本身实现为深度卷积网络。早期卷积层提取视觉特征,后面的全连接层产生预测概率和坐标。架构包含 24 个卷积层,后接 2 个全连接层。它没有使用 inception 风格模块,而是在 1×1 降维层和 3×3 卷积层之间交替,以在保留表示深度的同时控制计算成本。从特征提取到最终预测张量的完整检测器栈如下图所示:
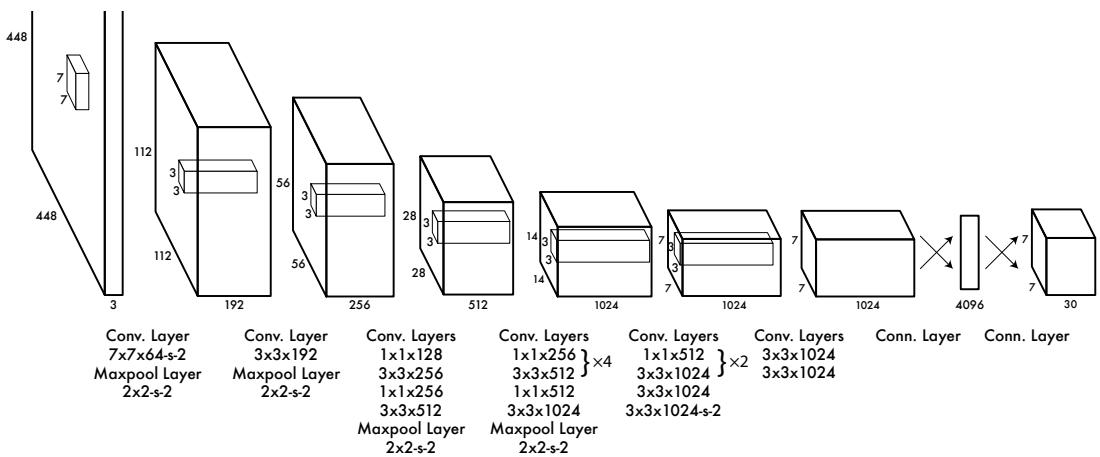
通过减少卷积层数以及这些层中的滤波器数量,得到更快变体。在这个缩减模型中,其余训练和测试过程不变。
训练首先从分类预训练开始。卷积主干网络,通常是检测网络的前 20 个卷积层,在大规模分类数据集上训练,并增加平均池化层和全连接输出层。然后,通过添加随机初始化的卷积层和全连接层,将预训练权重迁移到检测任务。由于检测需要更精细的空间细节,因此在检测训练前提高输入分辨率。最终层使用线性激活,而所有前序层使用 leaky rectified linear activation:
ϕ(x)={x,0.1x,if x>0,otherwise.网络使用多部分平方误差目标优化。直接平方损失易于最小化,但它与检测性能可能对齐较差,因为它对定位误差和分类误差赋予相等权重,并且会过度惩罚空网格单元。为解决这个问题,坐标误差被赋予更高权重,而非物体单元的置信度误差被降权。权重参数设置为 λcoord=5 和 λnoobj=0.5。为减少小框中定位误差的不成比例影响,模型预测框宽和框高的平方根:
L=λcoordi=0∑S2j=0∑B1ijobj[(xi−x^i)2+(yi−y^i)2]+λcoordi=0∑S2j=0∑B1ijobj[(wi−w^i)2+(hi−h^i)2]+i=0∑S2j=0∑B1ijobj(Ci−C^i)2+λnoobji=0∑S2j=0∑B1ijnoobj(Ci−C^i)2+i=0∑S21iobjc∈classes∑(pi(c)−p^i(c))2.这里,1iobj 表示物体出现在单元 i 中,而 1ijobj 表示单元 i 中第 j 个框预测器负责该物体。责任分配给当前与真实标注具有最高 IOU 的框预测器。这鼓励不同框预测器专注于不同物体尺寸、宽高比或类别。
训练使用批量大小 64、动量 0.9 和权重衰减 0.0005。学习率从 10−3 预热到 10−2,以避免早期发散,然后遵循分阶段衰减计划。在第一个全连接层后应用 Dropout,以减少单元间共适应。数据增强通过对原始图像大小进行最大 20% 的随机缩放和平移,并在 HSV 色彩空间中将曝光度和饱和度随机调整至最多 1.5 倍因子来执行。
在测试时,检测只需要通过网络进行一次前向传播。基于网格的预测设计强制空间多样性,因此多个单元有时可能对同一物体预测重叠框,尤其是大物体或靠近网格单元边界的物体。使用非极大值抑制移除重复检测,同时保留最终特定类别置信度分数。
实验
实验在 PASCAL VOC 上评估 YOLO,分析其与 Fast R-CNN 相比的误差,测试向艺术作品的跨域泛化,并验证实时网络摄像头部署。YOLO 被证明提供高效的实时检测框架;Fast R-CNN 仍然准确,但产生更多背景误报,并且互补的误差模式使 YOLO 能够对 Fast R-CNN 检测结果重新评分,并减少这些误报。YOLO 还通过建模物体形状和空间上下文,比基于候选区域的检测器更好地泛化到艺术作品,支持其在交互式实时应用中的实际使用。
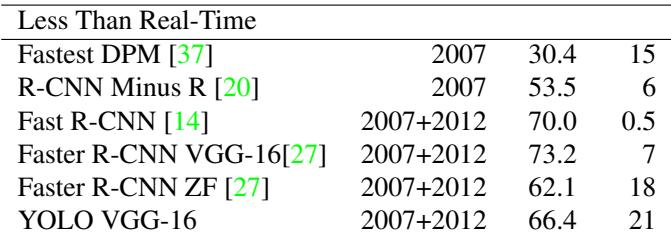
该表格比较 PASCAL VOC 2007 上的快速目标检测器,突出 YOLO 是准确率和速度平衡较好的检测器。Fast YOLO 被描述为最快检测器,同时比其他实时系统显著更准确,标准 YOLO 版本相比快速版本提高准确率,同时仍远高于实时速度。Fast YOLO 被呈现为最快检测器,准确率远高于其他实时检测器。标准 YOLO 以一定速度为代价,相比 Fast YOLO 获得明显准确率提升,同时仍保持快速。YOLO 与 Faster R-CNN 变体保持竞争力,同时比更慢的高准确率检测器提供高得多吞吐量。
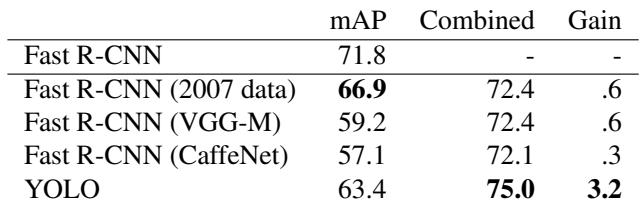
将最强 Fast R-CNN 与 YOLO 结合,在 VOC 2007 上产生比其他 Fast R-CNN 变体组合明显更大的增益。该改进归因于 YOLO 犯不同错误,尤其是更少背景错误,而不是归因于通用模型集成。尽管两个模型分别运行,YOLO 足够快,添加它不会引入显著额外计算。YOLO 为 Fast R-CNN 带来比其他 Fast R-CNN 模型更大的性能提升。Fast R-CNN 集成组合只产生小增益。Fast R-CNN 与 YOLO 组合增加的计算时间很少,因为 YOLO 很快。
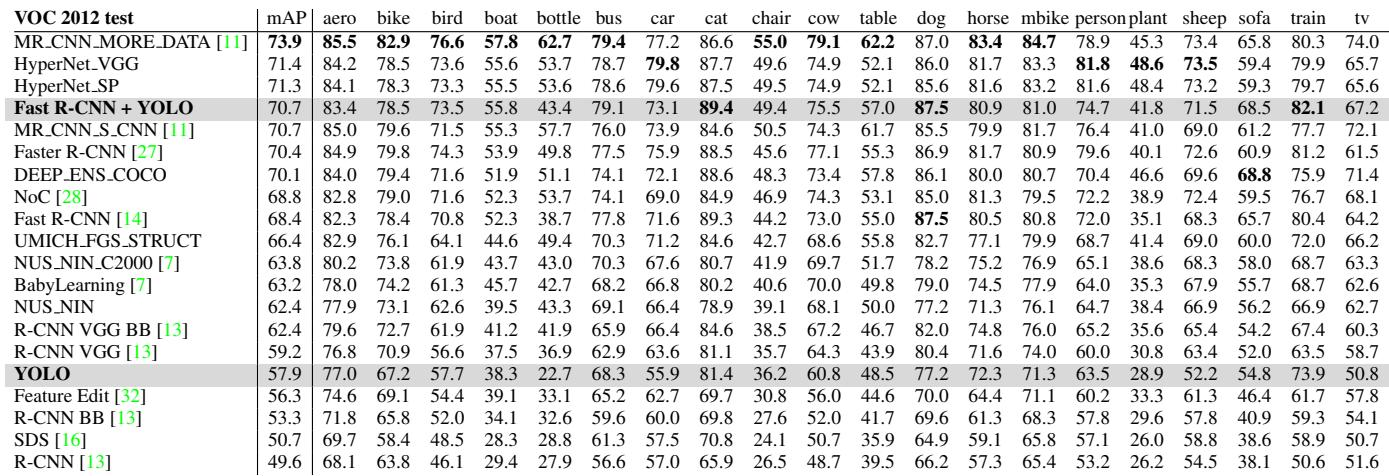
在 PASCAL VOC 2012 上,单独 YOLO 落后于领先检测方法,而 Fast R-CNN + YOLO 组合模型属于得分最高系统。该组合为 Fast R-CNN 带来明显改进,并提升其在公开排行榜上的位置。YOLO 也表现出类别相关优势和劣势,在某些小物体类别上表现较低,在 cat 和 train 等类别上表现更好。Fast R-CNN + YOLO 在排行榜比较中属于表现最好方法之一。该组合使 Fast R-CNN 提升 2.3% mAP,并提升其排行榜排名。YOLO 被描述为这个比较中唯一实时检测器。YOLO 在某些小物体类别上表现相对较差,在 cat 和 train 等类别上表现更好。
YOLO 在列出的方法中,在自然图像和艺术作品数据集上都取得最强行人检测结果。从 VOC 2007 转移到 Picasso 和 People-Art 数据集时,其性能下降少于其他检测器,表明更好的跨域泛化。R-CNN 在 VOC 2007 上有竞争力,但在艺术作品上显著下降,而 DPM 转移更稳定但准确率较低的性能。YOLO 在报告的自然图像和艺术作品行人检测设置中领先比较检测器。R-CNN 在自然图像上表现良好,但在艺术作品数据集上准确率损失大得多。DPM 在艺术作品数据集之间比 R-CNN 保持更稳定性能,但从较低基线开始。
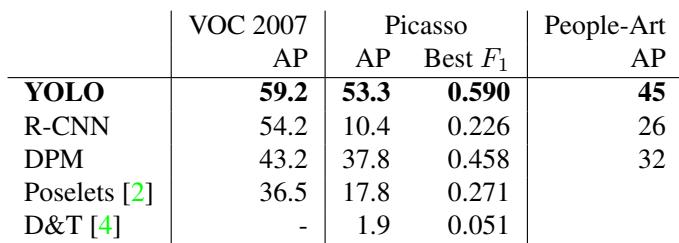
实验在 PASCAL VOC 2007 和 2012 以及跨域行人检测中评估 YOLO,评估实时速度、单独准确率、互补集成以及对域偏移的鲁棒性。在 VOC 上,快速和标准 YOLO 变体表明检测器平衡速度和准确率,而将 YOLO 与 Fast R-CNN 结合比其他快速模型组合产生更大增益,因为检测器犯不同错误。尽管单独 YOLO 在 VOC 2012 上落后于领先方法,组合模型表现强劲,并表现出类别依赖行为,在小物体上结果较弱;行人检测结果进一步表明 YOLO 比若干比较检测器更好地泛化到艺术作品。