Command Palette
Search for a command to run...
用于图像识别的深度残差学习
用于图像识别的深度残差学习
Kaiming He Xiangyu Zhang Shaoqing Ren Jian Sun
摘要
更深的神经网络更难以训练。我们提出了一种残差学习框架,使得训练远深于以往所用网络的网络变得更加容易。我们将网络层显式地重新表述为相对于层输入学习残差函数,而非学习无参照的函数。我们提供了全面的实验证据,表明这些残差网络更易于优化,并且能够从显著增加的深度中获得更高的精度。在 ImageNet 数据集上,我们评估了深度达 152 层的残差网络——其深度为 VGG 网络的 8 倍,但复杂度更低。这些残差网络的集成模型在 ImageNet 测试集上达到了 3.57% 的错误率,获得了 ILSVRC 2015 分类任务的第一名。我们还展示了在 CIFAR-10 上使用 100 层和 1000 层网络的分析。表示的深度对于许多视觉识别任务具有核心重要性。仅凭借我们极深的表示,我们在 COCO 目标检测数据集上获得了 28% 的相对改进。深度残差网络是我们在 ILSVRC 和 COCO 2015 竞赛中提交方案的基础,我们在 ImageNet 检测、ImageNet 定位、COCO 检测和 COCO 分割任务中也均获得了第一名。
一句话总结
残差学习框架将层重新表述为学习相对于输入的残差函数,使网络能够训练深达 152 层,比 VGG 网络深 8×,同时具有更低的复杂度,在 ImageNet 测试集上达到 3.57% 错误率,并在 ILSVRC 和 COCO 2015 任务中获得第一名。
核心贡献
- 残差学习框架将层重新表述为相对于其输入学习残差函数,从而能够使用标准 SGD 和反向传播端到端训练显著更深的网络,且无需修改求解器。
- 在 ImageNet 上的实验表明,残差网络更易优化,并能随着深度增加获得更高准确率;深至 152 层的模型复杂度低于 VGG 网络,集成模型达到 3.57% 的 top-5 错误率,并在 ILSVRC 2015 分类竞赛中获得第一名。
- 在 CIFAR-10 上的进一步验证包括成功训练超过 100 层的模型,并探索超过 1000 层的模型;深度残差表示在 COCO 目标检测上产生 28% 的相对提升,并支持了 ImageNet 检测、ImageNet 定位、COCO 检测和 COCO 分割的第一名提交方案。
引言
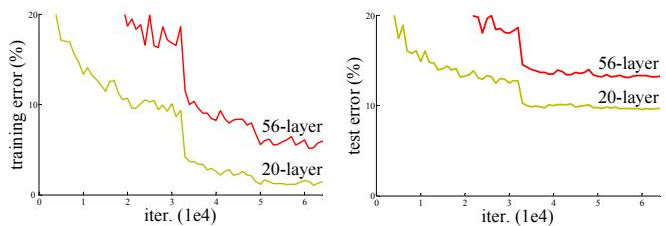
深度卷积神经网络改变了图像分类和视觉识别,因为深度使网络能够整合低层、中层和高层特征,使非常深的模型对强性能变得重要。尽管归一化初始化和中间归一化减少了梯度消失和梯度爆炸问题,作者识别出一个退化问题:即使没有过拟合,更深的普通网络也可能表现出更高的训练错误率,这表明当前求解器难以直接优化非常深的网络。作者通过引入残差学习解决这一问题:堆叠层拟合残差映射,而不是无参照映射,并使用无参数恒等捷径连接,使极深网络更易训练且更准确。
方法
方法
作者利用残差学习使非常深的卷积网络更易优化。一个关键问题是,更深的普通网络可能遭受退化:一旦网络深度足以收敛,添加更多层可能同时增加训练错误率和测试错误率,尽管更深的模型可以通过添加恒等映射来表示更浅的模型。退化并不仅仅是过拟合的结果。这表明,当恒等映射必须通过多个堆叠的非线性层来学习时,优化求解器难以近似恒等映射。
如下图所示:
为解决这一问题,作者重新表述学习目标。设 H(x) 表示若干堆叠层上期望的基础映射,其中 x 是这些层的输入。与其强迫层直接学习 H(x),作者让层学习一个残差函数
F(x):=H(x)−x,因此,原始映射被重构为
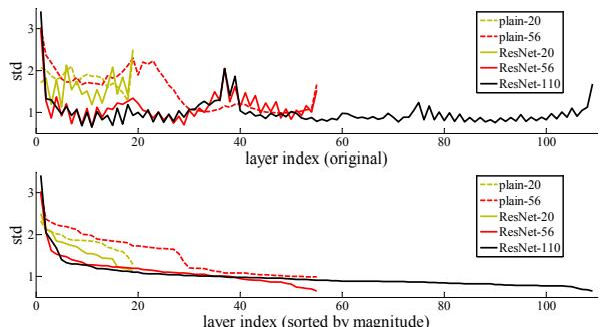
H(x)=F(x)+x.这种重新表述使恒等映射更易逼近:如果最优映射接近恒等,那么残差函数可以简单地接近零,求解器可以驱动权重趋近较小值。实际上,学习到的残差函数往往具有较小的幅度,这支持恒等映射为深度优化提供有用预条件这一观点。
如下图所示:
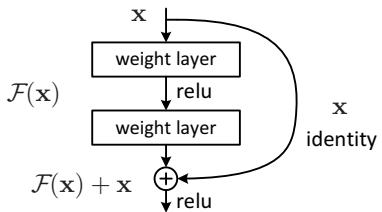
残差公式通过捷径连接实现。一个基本构建块定义为
y=F(x,{Wi})+x,其中 x 和 y 分别是该块的输入和输出,F(x,{Wi}) 是由若干带权重层学习的残差映射。在常见的两层示例中,F 可以写成 W2σ(W1x),其中 σ 是 ReLU 非线性。加上 x 的运算通过恒等捷径完成,随后是另一个非线性。该设计不添加额外参数或显著计算量,允许在相同深度、宽度和计算预算下直接比较普通网络和残差网络。
下图展示该构建块:
当捷径输入和残差输出具有不同维度时,恒等映射不再直接适用。在这种情况下,作者使用线性投影捷径,
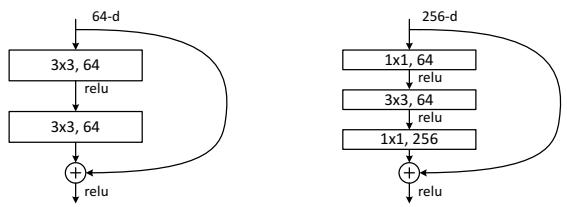
y=F(x,{Wi})+Wsx,通常在使用卷积特征图时以 1×1 卷积实现。作者还表明,恒等捷径通常足以解决退化问题,且更节省,因此投影捷径主要用于维度匹配。F 的形式是灵活的,可以包含两个或更多卷积层。对于更深的网络,瓶颈设计可以在 3×3 卷积之前压缩表示,并在之后再次扩展,从而在保持捷径公式的同时控制计算成本。
下图展示了一个常见的残差函数和瓶颈变体:
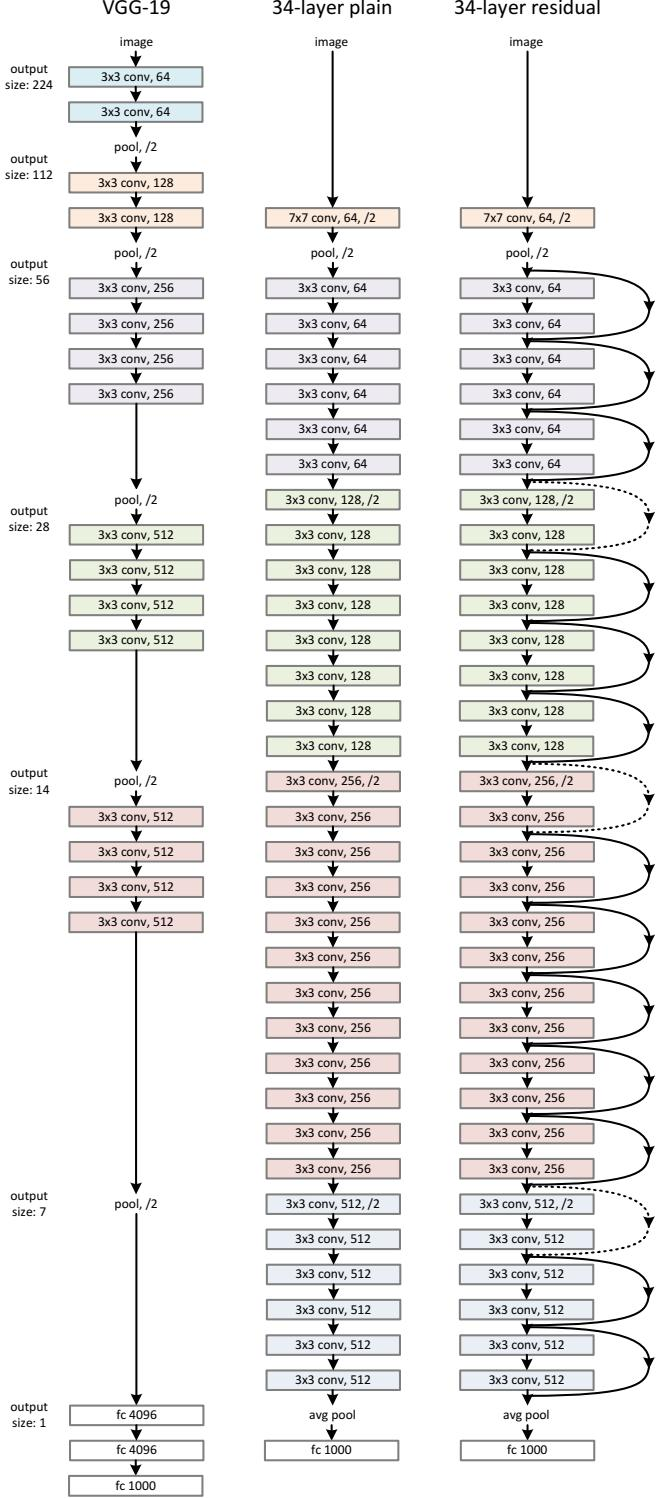
整体架构遵循作为基线的普通深度卷积设计,受 VGG 风格网络理念启发。它主要使用 3×3 卷积,并在固定特征图尺寸时保持滤波器数量恒定。当特征图分辨率减半时,滤波器数量加倍以保持每层复杂度。下采样直接通过跨步卷积完成,网络最后以全局平均池化接一个全连接 softmax 层结束。残差版本保持相同的主层堆栈,并在若干层组周围插入捷径连接。实线捷径表示维度相等时的恒等映射,虚线捷径表示改变维度的路径,例如投影捷径,或在通道数增加时带零填充的恒等映射。
参见下面的框架图:
在训练期间,图像先被随机调整大小以进行尺度增强,然后裁剪以进行训练增强,并应用标准颜色增强。批归一化放置于每次卷积之后、激活函数之前。网络从头开始使用随机梯度下降训练,使用 256 的小批量大小。初始学习率设置为 0.1,并在错误率进入平台期时除以 10。使用权重衰减 0.0001 和动量 0.9,不使用 dropout。在测试时,可以使用标准多裁剪评估;为了获得最佳性能,网络以全卷积形式进行评估,并在多个输入尺度上取平均。
实验
在 ImageNet、CIFAR-10 和检测基准上的实验评估了普通网络和残差网络,以检验残差学习是否能缓解深度模型中的优化退化。结果表明,普通的更深网络更难训练,而残差连接使更深的模型能够收敛并泛化得更好,分析显示残差函数通常具有较小的响应。学习到的表示还具有很强的目标检测迁移能力,展示了超越分类的广泛识别改进。
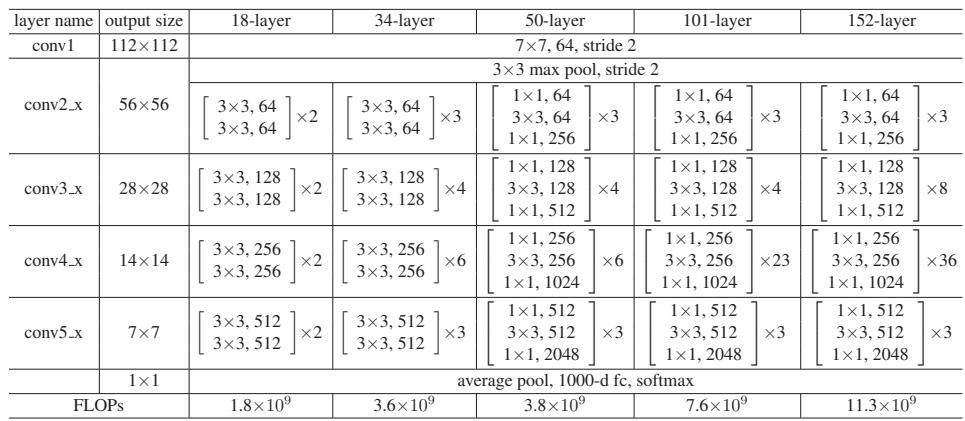
该表格展示了共享公共下采样路径并通过堆叠重复构建块来增加深度的 ImageNet 架构。较浅的普通变体使用成对的 3x3 块,而较深的变体使用瓶颈块,并在高维阶段放置更多重复。所引用实验将这些模型用于 ImageNet 分类,并显示更深的普通网络比更浅的普通基线具有更高的验证错误率。通过重复块来扩展模型深度,同时保持阶段分辨率模式固定。普通架构使用堆叠的 3x3 块对,而更深的架构使用瓶颈块堆。尽管拥有更多容量,更深的普通网络表现比更浅的普通网络更差。
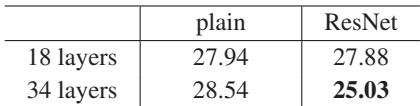
在 ImageNet top-1 验证错误率方面,残差网络在不增加参数的情况下达到或优于普通网络。将深度从 18 层增加到 34 层会使普通网络性能下降,但残差网络明显更好。该结果表明,残差连接减少了更深模型中的退化。34 层普通网络的表现比 18 层普通网络更差。残差网络显著改善了 34 层模型,并与 18 层模型非常接近。
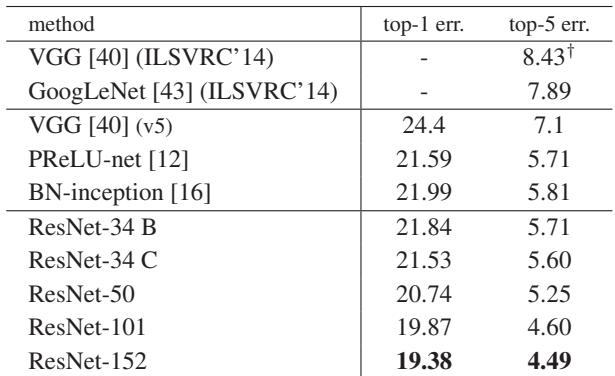
残差网络在 ImageNet 验证集的 top-1 和 top-5 错误率上均优于 34 层普通网络。在 ResNet-34 变体中,选项 C 取得最佳错误率,选项 B 略优于选项 A。普通网络落后于残差变体,且仍不如若干已报告基线准确。与普通 34 层网络相比,残差连接降低了验证错误率。选项 C 是三个 ResNet-34 变体中最强的。所评估的模型与先前 ImageNet 模型相比,具有具有竞争力的 top-5 性能。
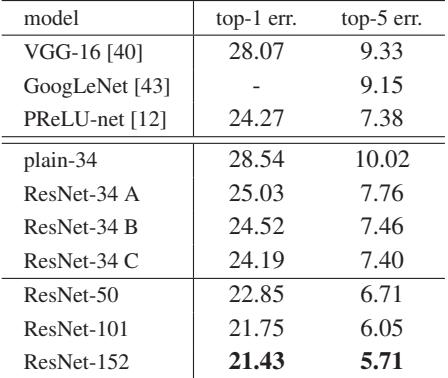
在所示的 ImageNet 结果中,ResNet-34 模型的 top-1 错误率低于所比较的 VGG、PReLU 和 BN inception 基线。在这些行中,ResNet-34 C 配置报告的 top-1 和 top-5 错误率最佳,而所列 VGG 在 top-1 上明显更不具竞争力。其中一个 VGG 结果被注明在测试集上报告,不同于其他列出的验证结果。相对于所列的单模型基线,ResNet-34 提高了 ImageNet 分类准确度。在所报告的行中,ResNet-34 C 变体给出最强的 top-1 和 top-5 性能。
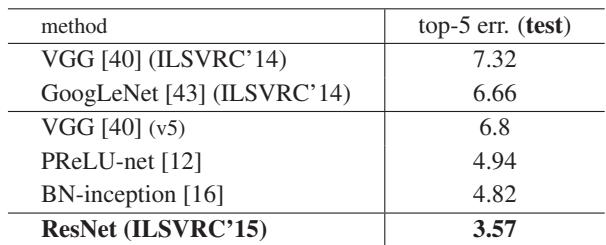
该比较报告了 ImageNet 上集成结果的 top-5 错误率,显示较早的 ILSVRC 2014 模型具有比近期方法更高的错误率。在列出的集成方案中,ResNet 表现出最强的测试性能,而 PReLU-net 和 BN-inception 也相对于早期 VGG 和 GoogLeNet 基线降低了错误率。在比较方法中,ResNet 集成方法达到最低报告的 top-5 错误率。较近期的集成方法优于较早的 ILSVRC 2014 VGG 和 GoogLeNet 基线。
ImageNet 分类实验比较了共享相似下采样路径并通过重复块增加深度的普通架构和残差架构。结果表明,单纯加深普通网络会导致退化,而残差连接使更深的模型能更有效地训练并获得更好的验证性能。与先前基线和集成方法的额外比较表明,残差设计比普通网络更准确,并与代表性深度网络方法相当或更强。