Command Palette
Search for a command to run...
面向语义分割的全卷积网络
面向语义分割的全卷积网络
Jonathan Long Evan Shelhamer Trevor Darrell
摘要
卷积网络是能够产生层次化特征的强力视觉模型。我们证明,仅凭卷积网络本身,经过端到端、逐像素的训练,即可在语义分割任务上超越当时的最优水平。我们的核心思想是构建"全卷积"网络,使其能够接受任意尺寸的输入,并生成相应尺寸的输出,同时实现高效的推理与学习。我们定义并详细阐述了全卷积网络的空间,解释了其在空间稠密预测任务中的应用,并建立了与已有模型之间的联系。我们将当代分类网络(AlexNet [20]、VGG [31] 和 GoogLeNet [32])改造为全卷积网络,并通过微调 [3] 将其学习到的表征迁移至分割任务。随后,我们定义了一种跳跃架构,将来自深层粗粒度层的语义信息与来自浅层细粒度层的外观信息相结合,以产生准确且细节丰富的分割结果。我们的全卷积网络在 PASCAL VOC(相对提升 20%,2012 年平均交并比达到 62.2%)、NYUDv2 和 SIFT Flow 上均取得了最优的分割性能,同时对典型图像的推理时间不到五分之一秒。
一句话总结
由加州大学伯克利分校提出的全卷积网络(FCN)将当代分类架构改造成端到端的像素到像素分割模型,通过跳跃架构将深层粗粒度语义信息与浅层细粒度外观信息相结合,在 PASCAL VOC、NYUDv2 和 SIFT Flow 上取得当前最佳结果,任意输入尺寸下每张图像推理不到五分之一秒。
核心贡献
- 为从整图输入到稠密像素输出的端到端语义分割,全卷积网络被形式化建模,任意输入尺寸会产生对应尺寸的预测,并且预训练的 AlexNet、VGG 和 GoogLeNet 模型可通过全卷积微调加以改造。
- 定义了跳跃架构,用于将深层粗粒度语义信息与浅层细粒度外观信息相结合,从而生成经端到端训练的、局部精确且全局一致的分割表示。
- 所得模型在 PASCAL VOC、NYUDv2 和 SIFT Flow 上取得当前最佳分割性能,其中包括在 PASCAL VOC 2012 上将 mean IU 相对提升 20% 至 62.2%,典型图像可在不到五分之一秒内完成推理。
引言
卷积网络已经推动视觉识别从整图分类走向更局部的结构化任务,使像素级语义分割成为细粒度场景理解的自然下一步。此前方法通常依赖块状训练、未经监督预训练的小型模型,或额外的前后处理,如超像素、候选框、随机场、局部分类器、输入平移、多尺度处理和集成模型。这些选择使学习和推理效率较低,并阻碍许多模型作为简单端到端系统运行。
作者利用这样的认识:分类卷积网络可被重新解释为全卷积网络,并可针对稠密逐像素预测进行微调。他们在整图上进行端到端训练,使用网络内部上采样,以及将深层语义特征与浅层细粒度外观和位置线索相结合的跳跃架构。这种方法能够高效处理任意尺寸输入,并在不使用早期系统额外机制的情况下实现当前最佳语义分割。
方法
作者利用对标准识别网络的全卷积重新解释,将分类模型转化为稠密预测器。在常规卷积网络中,每一层都是大小为 h×w×d 的三维数组,其中 h 和 w 是空间维度,d 是通道维度。卷积、池化和激活操作具有局部性与平移不变性,因此某层在位置 (i,j) 处的输出可写为
yij=fks({xsi+δi,sj+δj}0≤δi,δj≤k),其中 k 是卷积核大小,s 是步幅,fks 表示层类型。此类层的组合保留了这种局部且考虑步幅的结构,从而得到深层滤波器,而非固定尺寸分类器。组合规则为
fks∘gk′s′=(f∘g)k′+(k−1)s′,ss′.该性质允许网络处理任意空间尺寸输入,同时产生的输出其空间尺寸由网络步幅决定。可参见变换示意图。
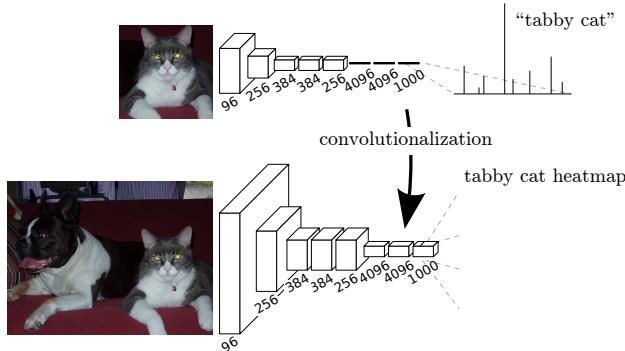
该方法首先将现有分类主干卷积化。全连接层被重新解释为卷积,其卷积核覆盖整个输入区域。移除末端分类器后,网络不再产生单一图像级标签;相反,它产生类别分数的空间图。随后作者附加一个 1×1 卷积,以在每个粗粒度输出位置预测类别分数,接着是一条上采样路径,将粗粒度预测连接回像素网格。原始分类权重被保留,并针对稠密预测进行端到端微调。
由于分割需要在每个输出单元处提供监督,损失函数被表述为对最终层所有空间位置求和:
ℓ(x;θ)=i,j∑ℓ′(xij;θ).在该空间损失下,对完整图像计算梯度等价于对最后一层感受野集合进行优化。当这些感受野大量重叠时,逐层处理整幅图像远比独立计算每个图像块高效。因此,作者以逐像素损失端到端训练整幅图像,同时忽略被标记为模糊或被掩膜覆盖的真值像素。作者指出,块状训练可视为损失采样,但整幅图像的全卷积训练既高效又有效。
该架构中的一个关键模块是可学习的上采样。由于分类网络通常包含池化和带步幅卷积以保持计算可管理,粗粒度输出会以降低的空间分辨率产生。作者使用反卷积将粗粒度预测连接到稠密像素,反卷积可被解释为带步幅卷积的逆向过程。上采样因子 f 对应于输入步幅为 1/f 的分数步幅卷积。反卷积滤波器不固定插值规则,而是允许通过反向传播学习,并可通过激活函数在需要时实现非线性上采样。实际中,上采样层可初始化为双线性插值,再在训练过程中进行精调。
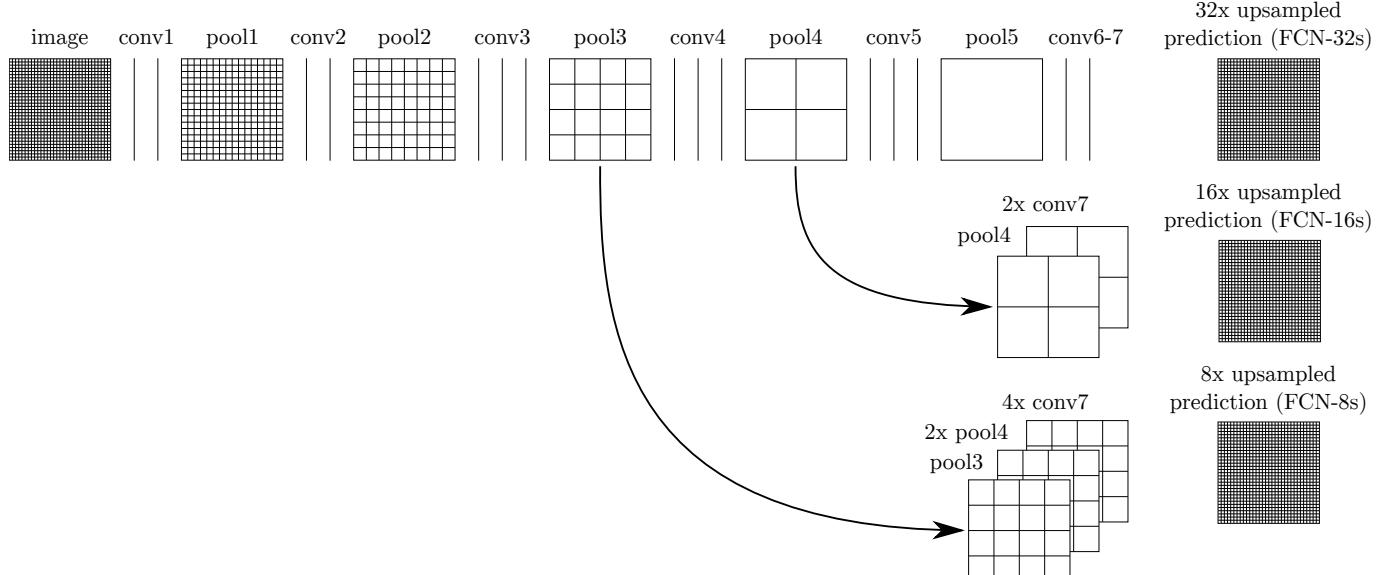
虽然基线全卷积分类器可以改造成分割模型,但其最终预测较为粗糙。在常见的 stride-32 版本中,通常称为 FCN-32s,输出预测具有 32 像素的感受野步幅,限制了上采样后可恢复的空间细节。为了精调输出,作者组合特征层级中不同深度的预测。所得架构是有向无环图,而不是严格的线性堆叠。它保留单条主干以提取语义信息,同时加入来自较早层的跳跃路径,以保留更细的空间细节。下图所示。
第一种精调创建了 FCN-16s。网络已经能够在 stride 32 处从最深的卷积特征层产生预测。作者在 stride 为 16 的 pool4 层之上添加一个 1×1 卷积,以产生额外类别预测。该 stride-16 预测与 stride-32 预测通过上采样后者 2 倍并将两个分数图求和进行融合。网络随后再进行一次上采样,以达到像素分辨率。新的跳跃层参数初始化方式使融合预测接近原始 FCN-32s 行为,而上采样参数可初始化为双线性插值。新增权重以更小学习率进行学习。
随后的精调创建了 FCN-8s。网络从 pool3 层在 stride 8 处添加另一预测。在额外 2× 上采样后,该 stride-8 预测与已组合的 stride-16 预测融合。随后将合并后的分数图上采样至完整像素分辨率。这种层级融合使模型能够利用粗粒度高层语义判断应存在什么内容,同时利用较浅的高分辨率特征判断物体边界和局部结构位于何处。作者称这种非线性特征层级为 deep jet,因为它跨层组合尺度信息。
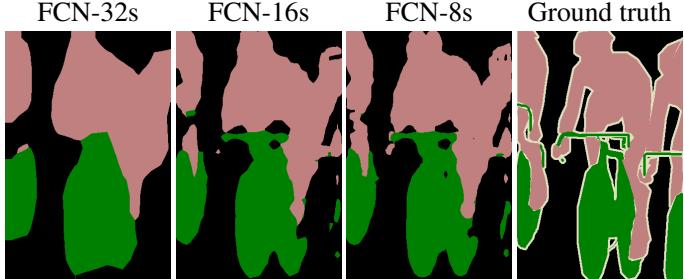
这种多尺度融合的效果是在不放弃深层主干语义鲁棒性的同时提升分割精度。FCN-32s 提供全局一致但粗糙的预测,FCN-16s 恢复更细结构,FCN-8s 进一步改善局部边界质量。下图将逐步精调后的输出与真值进行对比。
因此,整体方法通过四项相互关联的思想将面向分类的表示迁移到稠密预测:分类器卷积化、带逐像素损失的整图训练、可学习的网络内上采样、层级特征图的跳跃融合。所得设计支持从任意尺寸输入到像素级输出的端到端学习,同时保留卷积特征提取的计算效率。
实验
实验评估了通过微调 ILSVRC 分类器并用网络内上采样和跳跃连接进行增强得到的全卷积分割模型,在 PASCAL VOC 上进行分割,并扩展到 NYUDv2 场景解析和 SIFT Flow 联合语义与几何预测。实验框架中的消融实验表明,整图训练已足够,随机图像块采样不会显著改善收敛,轻度标签不平衡无需类别平衡,简单增强和四通道早期融合收益有限,而扩展标注可提升验证性能。总体而言,跳跃架构和稠密预测方法在多个数据集上取得较强性能,晚期融合与多任务头能有效处理 RGB-D 和联合标签预测,同时保持高效推理。
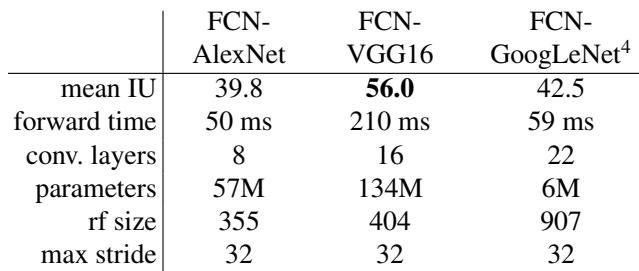
将预训练分类网络转换为稠密全卷积模型可得到可用的语义分割,其中改造后的 VGG 具有最高准确率,AlexNet 具有最快推理速度。GoogLeNet 使用少得多参数和更大得多的感受野,却未达到 VGG 级别分割准确率,表明分类成功不会自动迁移到稠密预测。所有比较模型共享相同最粗步幅,而不同架构的感受野大小和参数数量差异很大。FCN-VGG16 在 mean intersection over union 上领先比较架构,并被描述为在验证集上接近当前最佳水平。FCN-AlexNet 是三者中最快的,但 mean intersection over union 最低;FCN-GoogLeNet 参数效率更高,但仍落后于 FCN-VGG16。
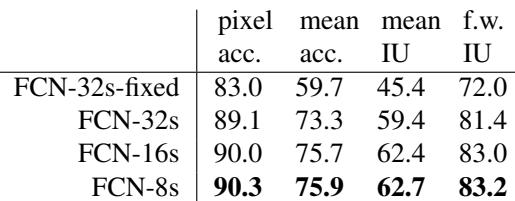
端到端训练明显优于仅微调最后一层,最大差距出现在基于区域的指标上。通过把最终步幅从 32 降到 16,再降到 8 来提高模型分辨率,可在所有指标上获得稳定但较小的改进。最佳整体结果来自最精细步幅设置,而固定层训练仍明显较弱。与端到端微调相比,仅训练最后一层表现较差。较低步幅能改善分割质量,但从 16 到 8 的增益较小。
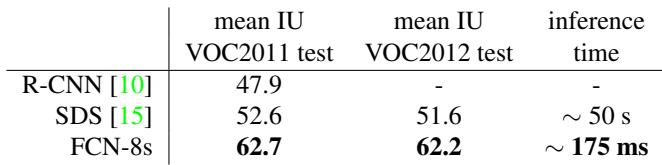
全卷积网络在 PASCAL VOC 2011 和 2012 测试集上取得最佳 mean IU,相较此前当前最佳结果约相对提升 20%。它也比比较方法使用少得多的推理时间,使稠密像素预测快得多。在两个 VOC 测试集上取得最高 mean IU,相较 SDS 约相对提升 20%,推理时间从数十秒降至亚秒级延迟。
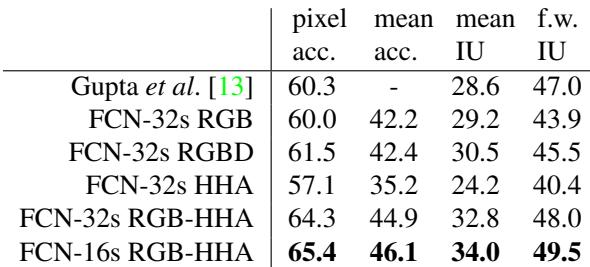
在 NYUDv2 上,仅使用 RGB 的模型与先前结果表现相当,而早期融合的 RGB-D 输入带来的额外收益很小。RGB 与 HHA 深度嵌入的晚期融合更明显改善性能,改进后的晚期融合变体进一步提升准确率和 IU 类指标。RGB 与深度通道的早期融合相较仅使用 RGB 训练收益很小。RGB 与 HHA 预测的晚期融合在 mean accuracy 和 mean IU 上带来最强改进。更精细的晚期融合模型相较更粗粒度的 RGB-HHA 设置进一步改善结果。
结果在 SIFT Flow 像素分割上比较了多种基线方法,显示它们在不同类别分割指标上各有优势。一些方法更注重总体像素准确率,另一些则提升 mean per-class accuracy,并且一个迁移方法在几何准确率上被比较。所描述的全卷积模型将语义预测与几何预测结合在一个联合模型中,并被报告在两项任务上均达到当前最佳性能。基线结果显示出总体像素准确率与 mean per-class accuracy 之间的权衡。据报道,该联合模型在保持当前最佳任务性能的同时处理语义和几何预测。
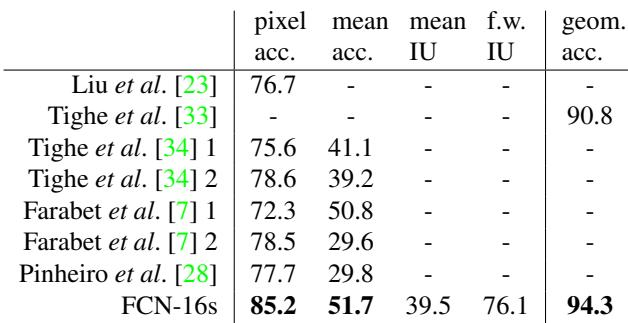
实验将预训练分类网络转换为全卷积模型,并比较其稠密预测行为,结果表明 VGG 改造版本取得最强分割性能,AlexNet 更快,GoogLeNet 更紧凑但准确率较低。进一步研究验证,端到端训练和更精细输出分辨率能持续改善分割质量,所得模型在标准分割基准上提供强劲性能,且推理远快于先前方法。针对深度和像素分割任务的额外评估表明,深度信息的晚期融合以及联合语义与几何建模可进一步提升鲁棒性和总体准确率。