Command Palette
Search for a command to run...
在关键之处最大化局部熵:前缀感知的局部化大语言模型遗忘
在关键之处最大化局部熵:前缀感知的局部化大语言模型遗忘
Naixin Zhai Pengyang Shao Binbin Zheng Yonghui Yang Fei Shen Long Bai Xun Yang
摘要
机器遗忘旨在从大语言模型(LLM)中遗忘敏感知识,同时保持通用效用。然而,现有方法通常不加区分地对待回复中的所有词元,并在整个词汇表上强制施加不确定性。这种全局处理方式导致了不必要的效用退化,并将优化扩展到与内容无关的区域。为解决上述局限性,我们提出了 PALU(前缀感知局部化遗忘)框架,其核心驱动目标是在时间维度和词汇维度上实现局部熵最大化。PALU 揭示了两个关键发现:(i)仅抑制敏感前缀即可切断因果生成链路;(ii)仅对前 K 个 logits 进行平坦化便足以最大化关键子空间中的不确定性。这些发现使 PALU 能够在避免全词汇表和参数空间上冗余优化的同时,将对模型通用性能的附带损害降至最低。全面的实验评估验证了 PALU 在遗忘效果和效用保持方面均优于最先进的基线方法。代码已发布于 https://github.com/nxZhai/PALU。
一句话总结
来自中国科学院科技大学和新加坡国立大学的研究人员提出 PALU(前缀感知局部化遗忘),该框架仅抑制敏感前缀并展平 top-K logits,通过最大化局部熵,从而减少全词汇表和全参数空间中的冗余优化,在最小化对模型一般性能附带损害的同时实现更强的遗忘效果。
核心贡献
- PALU 被提出为面向大语言模型的前缀感知局部化遗忘框架,使用针对敏感前缀和 top-K logits 的局部熵最大化目标。
- 通过仅抑制敏感前缀并仅展平 top-K logits,PALU 切断敏感生成链路,同时避免在整个词汇表和整个参数空间上进行优化,降低对模型一般性能的附带损害。
- 全面评估表明,PALU 在遗忘效果与效用保持之间实现了比当前最先进梯度式遗忘基线更强的权衡。
引言
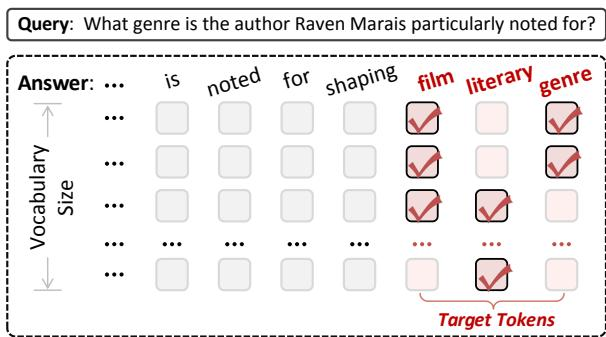
大语言模型可能记住隐私或受版权保护的内容,这使得机器遗忘对于安全部署以及遵守 GDPR 和 CCPA 等隐私法规很重要。现有方法大多依赖负交叉熵目标,它们在整个响应位置和词汇表上全局抑制目标 token,常常导致过度校正、连贯性下降、效用降低和较高计算开销。该工作利用一个观察:敏感生成通常由较短前缀触发,并主要由少量高概率 logits 主导。该工作提出 PALU,对敏感前缀和 top-K logits 应用局部熵最大化,以最小扰动破坏不期望的生成路径,在强遗忘的同时更好保持一般效用。
方法
该工作将 PALU 呈现为面向大语言模型的低开销机器遗忘框架。该设计从两个互补视角降低干预成本:token 层面和词汇表层面。在 token 层面,它避免将遗忘目标统一应用于每个输出 token。相反,它区分敏感触发 token、内容无关 token 和冗余敏感 token,并为每组分配不同训练信号。在词汇表层面,它将朴素的负交叉熵和全词汇表熵最大化替换为局部熵目标,仅针对解码过程中涉及的主导 logits。如下框架所示,token 选择模块决定在哪里施加梯度,而词汇表级目标决定每个被选中的目标应如何变换。
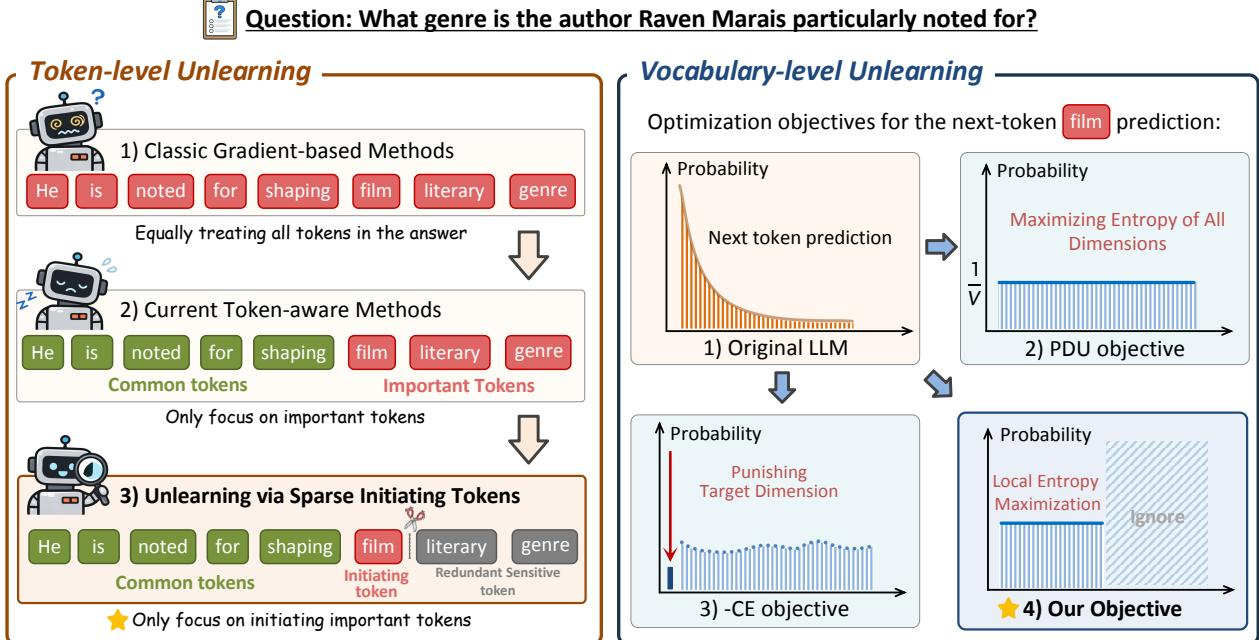
第一个模块构建 token 层面的角色划分。对于长度为 T 的输出序列,该方法识别敏感片段并定义二值掩码 mt∈{0,1},其中 mt=1 表示 token yt 携带敏感语义,而 mt=0 表示普通 token。令
Tsens={t∣mt=1}为敏感 token 索引的集合。作者进一步利用时间稀疏性,假设每个敏感片段中仅开头几个 token 对触发敏感行为起关键作用。因此定义一个触发目标子集
Tinit⊂Tsens通过选择每个片段中的前 N 个敏感 token。
基于该划分,输出 token 被分配三种优化角色。Tinit 中的 token 接收主要遗忘信号,因为它们负责启动敏感轨迹。位于 Tsens 之外的 token 被视为普通 token,并使用 KL 散度约束加以保护,以保持整体流畅性和效用。其余敏感 token,即 Tsens∖Tinit 中的 token,在最小干预原则下被排除在梯度计算之外。
第二个模块处理词汇表层面的优化目标。负交叉熵能够抑制目标 token 的概率,但并不保证分布变得真正不确定。被抑制的概率质量可能转移到相关的同义词或另一个主导 token,从而产生不稳定且尖峰化的分布。全局熵最大化提供了更强的理论目标,因为它鼓励预测分布在完整词汇表上变得均匀,但在所有 ∣V∣ 个维度上优化熵计算开销很大,且通常不必要,因为长尾低概率 token 对生成影响很小。
为了平衡稳健性和效率,作者引入局部熵最大化。对于目标 token t∈Tinit,令 zt∈R∣V∣ 表示 logits 向量。它们定义 top-K 集合 Vtop,使用冻结参考模型 Pθref 识别并在整个训练过程中保持固定。局部目标如下
Llocal(zt)=K1i∈Vtop∑(zt,i−c)2.该目标通过把主导 logits 推向共同目标值 c 来降低它们之间的方差。当 top-K logits 彼此更接近时,softmax 归一化会在对解码至关重要的候选项上产生更均匀的分布。锚定值 c 还控制抑制强度:选择较小的 c 可以减少相对于词汇表其余部分分配给 top-K 候选项的总概率质量。
整体遗忘损失将稀疏 token 选择与局部熵最大化结合。其写作
Lf=Et∈Tinit[Llocal(zt)]+λEt∈/Tsens[KL(Pθref(⋅∣x,y<t)∥Pθ(⋅∣x,y<t))].第一项仅在 top-K logits 空间中优化稀疏触发 token。第二项通过惩罚普通 token 相对于参考模型的偏离来保持一般行为。冗余敏感 token 不获得直接梯度,因为它们未被包含在任何一项期望中。
从计算角度看,这一设计将反向传播的依赖关系从完整词汇表改变为较小的解码子空间。稠密负交叉熵的成本与 T∣V∣ 成正比,而 PALU 在最多 T 个触发 token 位置和仅 K 个词汇表维度上产生稀疏梯度。因此,该遗忘操作的上界为 O(TK),当 K≪∣V∣ 时显著低于 O(T∣V∣)。
实验
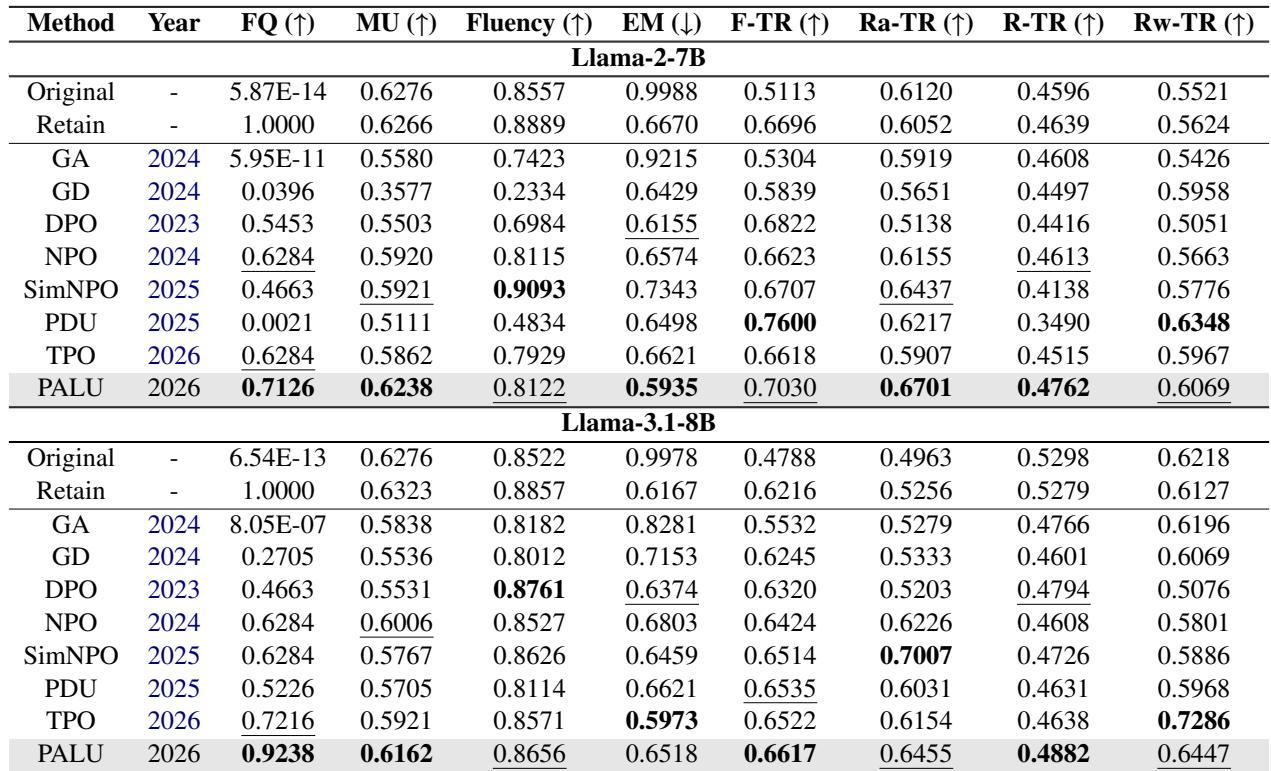
在 TOFU 和 MUSE 上以 Llama 为主干网络,并与多种遗忘基线进行比较的实验表明,PALU 在遗忘与效用之间提供了较强的平衡,随模型能力提升而良好扩展,并且在整体行为上非常接近理想的 retain 模型。消融实验验证了双重稀疏设计,表明有限的词汇表截断和较早的前缀截断足以实现有效遗忘,而全局均值展平在保持模型分布方面提供了最佳稳定性。额外分析显示快速收敛、在基于似然的分离指标下较低的目标记忆,以及在不同遗忘设置中令人信服的稳健性。
在 forget 5% 设置下,PALU 在比较方法之间提供了最强的遗忘与效用总体平衡,并且在能力更强的 Llama 模型上优势更明显。它避免了 GA 和 GD 中观察到的严重效用崩塌,同时仍接近保留参考性能曲线。PALU 相比强基线实现了更大的遗忘质量提升,且在更强模型上改善更显著。GA 和 GD 明显降低模型效用,而 PALU 保持流畅性和答案质量。双重局部化方法支持遗忘,同时相比竞争方法不会牺牲过多保留能力。
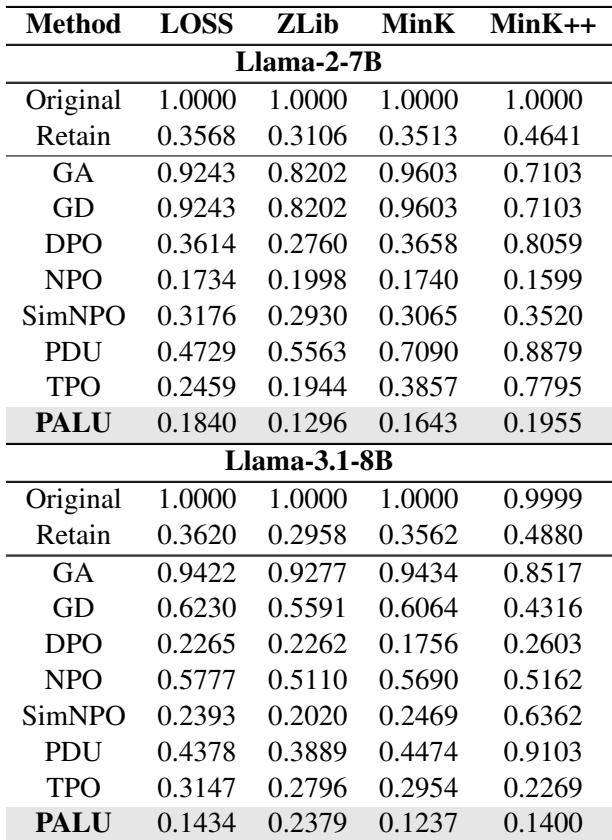
扩展似然指标表明,若干方法使 forget 样本和 holdout 样本比 retain 模型更可分离,而 PALU 在 Llama-2-7B 上持续产生较低的可分离性。在 Llama-3.1-8B 上,PALU 也比 TPO 更强地抑制与目标相关的似然,甚至可能低于 retain 模型,这表明被遗忘内容获得的目标似然可能低于普通未见数据。PALU 在 Llama-2-7B 上对 LOSS、ZLib、MinK 和 MinK++ 均实现强目标抑制。GA 和 GD 保留更高的似然可分离性,比 PALU 更接近原始模型。在 Llama-3.1-8B 上,与 TPO 相比 PALU 降低 MinK++ 可分离性,并可产生低于 Retain 的 LOSS 可分离性。
该比较在 TOFU 的 5% forget split 上评估 Llama-2-7B 的固定前缀截断比例和 PALU。25% 截断比例导致遗忘质量明显下降,而 50% 和 100% 比例表现好得多,并保持合理效用。PALU 给出最佳总体平衡,略优于最接近的固定比例,同时保持比较设置中的最高效用。50% 比例接近 PALU,表明适度的长度感知预算可以近似对因果上占主导地位的 token 进行定向移除。25% 处非常激进的截断会显著削弱遗忘,显示过少前缀会限制有效遗忘。动态截断看起来有前景,但稳定增益需要更好的预算选择和更精细的超参数调优。
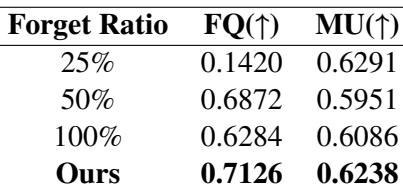
这些实验使用较小和较强的 Llama 模型,在 forget 5% 设置下评估遗忘方法,并包含额外的扩展似然分析和与固定前缀截断策略的比较。PALU 显示最强的遗忘与效用总体平衡,避免 GA 和 GD 中出现的严重效用崩塌,同时保持流畅性和答案质量。它还对目标相关似然实现强抑制,表明遗忘稳健,且不会过度损害保留能力。