Command Palette
Search for a command to run...
MediEval:面向大规模语言模型中患者情境化与知识 grounded 推理的统一医学基准
MediEval:面向大规模语言模型中患者情境化与知识 grounded 推理的统一医学基准
Zhan Qu Michael Färber
摘要
大规模语言模型(LLMs)在医学领域的应用日益增多,但其推广受限于对可靠性和安全性的担忧。现有评估要么单独测试事实性医学知识,要么评估患者层面的推理而不验证正确性,存在关键空白。我们引入了 MediEval,一个将 MIMIC-IV 电子健康记录(EHRs)与由 UMLS 及其他生物医学词汇表构建的统一知识库相连接的基准。MediEval 在真实患者情境中生成多样化的事实性和反事实性医学陈述,从而能够在同时考虑知识 grounded 和情境一致性的 4 象限框架内进行系统性评估。利用该框架,我们识别出当前专有、开源及领域特定 LLMs 频繁表现出的关键故障模式,包括幻觉支持和真相反转。为应对这些风险,我们提出了反事实风险感知微调(CoRFu),一种基于 DPO 的方法,采用不对称惩罚机制针对不安全混淆。CoRFu 在基础模型上提升了 +16.4 个宏平均 F1 分数,并消除了真相反转错误,展示了更高的准确性和显著更强的安全性。
一句话总结
来自德累斯顿工业大学(TU Dresden)和ScaDS.AI的研究人员提出了MediEval,这是一个将MIMIC-IV电子健康记录与基于UMLS的知识库连接起来的基准,用于在4-quadrant框架中共同评估事实与反事实推理,并引入了反事实风险感知微调(CoRFu),一种DPO-based方法,通过不对称惩罚消除真相反转,使macro-F1比基础模型提高+16.4个百分点。
核心贡献
-
提出了MediEval,一个将MIMIC-IV电子健康记录与来自UMLS和其他生物医学词表的统一知识库连接起来的基准,在真实患者情境中生成事实性和反事实性陈述,用于在一个同时考虑知识基础和上下文一致性的4象限框架中进行评估。
-
在相同设置下对专有、开源和生物医学大型语言模型(LLM)的跨模型评估揭示了系统性的象限级弱点和安全关键错误模式,包括幻觉支持和真相反转,这些是聚合准确率指标无法捕获的。
-
提出了反事实风险感知微调(CoRFu),一种基于DPO的方法,针对不安全的混淆采用不对称惩罚,使宏F1分数比基础模型提高+16.4个百分点,并消除了真相反转错误,展现出更高的准确性和显著更高的安全性。
引言
大型语言模型越来越多地应用于高风险临床任务,包括总结电子健康记录、生成出院指导和提供决策支持,在这些任务中,错误可能直接导致患者伤害。然而,一个关键缺口仍然存在:模型能够回忆起孤立的医学事实(例如,二甲双胍在严重肾功能损害中是禁忌的),但当该事实出现在真实患者记录的嘈杂、异质背景中时,却无法应用该知识。先前的评估工作仅部分解决了这个问题。基于电子健康记录的基准通常将任务简化为检索或序列化,而不验证医学合理性;而基于知识的评估测试事实的逻辑转换,但不将推理与真实患者情境联系起来。
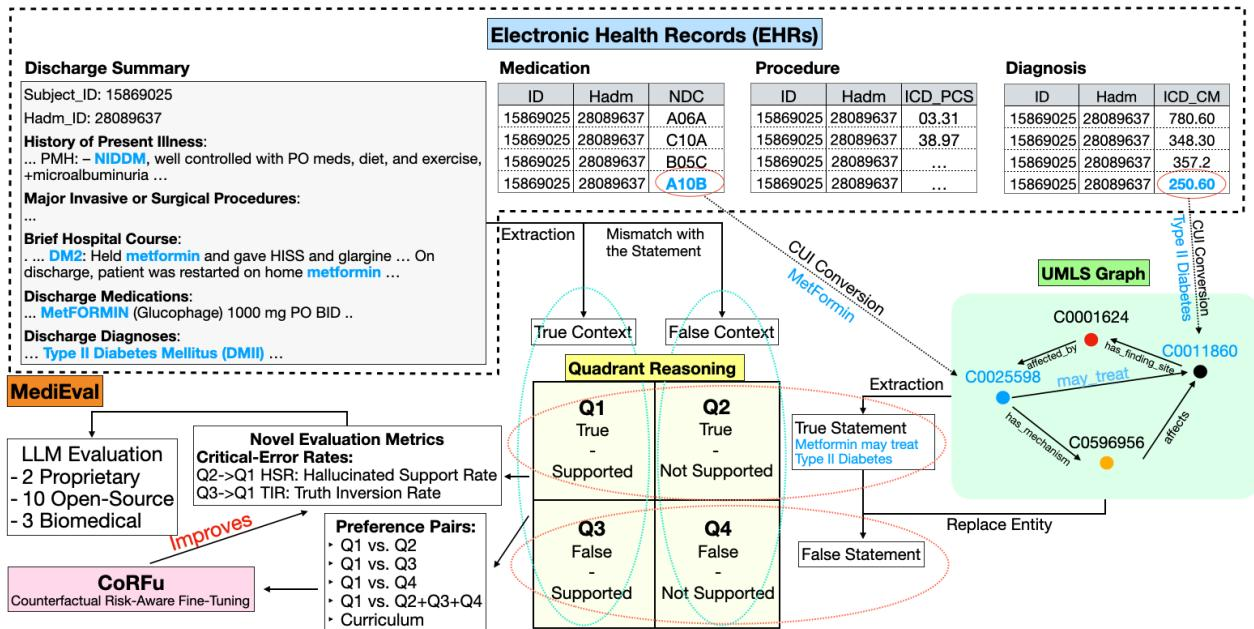
为弥补这一缺口,作者引入了MediEval,这是一个基准和评估框架,将MIMIC-IV的真实患者记录与基于UMLS、SNOMED CT和RxNorm构建的统一生物医学知识库连接起来。MediEval通过图表引导的替换和重组在ontologies中构建评估陈述,并通过合理性检查确保真实案例保持临床有效性,同时虚假案例具有现实性。每个陈述都嵌入真实患者情境,使得能够进行象限级推理,定义为相对于医学知识的真或假,以及相对于患者记录的支持或不支持。作者还提出了两个新的以安全为中心的指标:幻觉支持率(HSR)和真相反转率(TIR),揭示出专有、开源和生物医学LLM之间的一致弱点。为了减轻这些风险,他们引入了反事实风险感知微调(CoRFu),一种基于DPO的方法,利用象限结构的偏好对和不对称惩罚,引导模型倾向于真和支持的响应,同时惩罚安全关键的混淆,如假和支持。
数据集
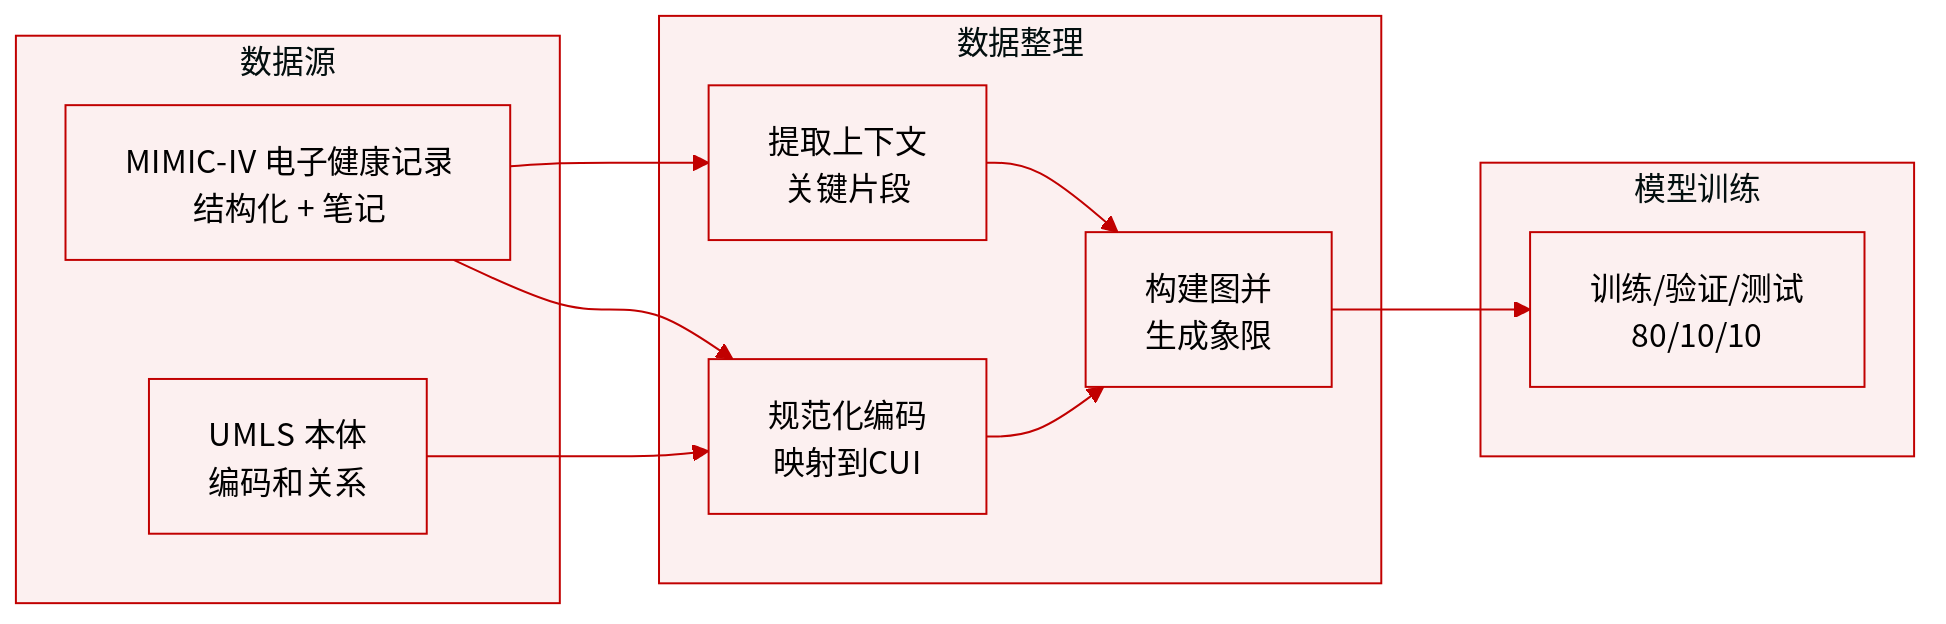
作者从两个主要来源构建MediEval,一个用于临床推理的基准:MIMIC-IV数据库(v3.1)和UMLS生物医学本体论。
-
数据集组成与来源:MediEval整合了结构化电子健康记录数据(使用ICD和NDC编码的诊断、程序、药物)与非结构化出院摘要(每个包含约22个部分)。它还利用UMLS映射跨系统的代码和关系。
-
构建流程:
- 情境提取:对于每次入院,选择出院摘要部分的子集,涵盖诊断、程序、治疗、病史和住院过程。这构成评估情境。
- 语义规范化:原始医学代码(ICD、NDC)被映射到UMLS概念唯一标识符(CUI),将诊断、程序和药物对齐到统一的语义空间中。
- 本体图:构建一个图,其中顶点是CUI,边是UMLS关系(例如,treated_by、has_associated_procedure、is_a)。允许长度最多为3的多跳路径,以捕获间接临床关联。
- 陈述生成:对于每个事实 (h, r, t),创建四个象限样本:Q1(真-支持)、Q2(真-不支持)、Q3(假-支持)和Q4(假-不支持)。这些样本通过本体引导的替换、重组和合理性检查生成。
-
最终数据集统计:数据集包含2,015次独立入院(每位患者一次入院以防止泄漏)、8,350条医学陈述和37,144个样本。情境长度范围为340到2,827个token。
-
论文中的用途:数据集按80/10/10的比例划分为训练集、验证集和测试集,并在四个象限之间保持平衡。作者使用训练部分在情境-陈述对(context-statement pairs)上训练LLM,并使用测试集(包含200个人工标注样本)来评估事实可靠性和上下文遵循度。
方法
作者提出了MediEval,一个旨在评估大型语言模型(LLM)临床推理能力的综合框架。该框架整合结构化电子健康记录(EHR)、非结构化临床笔记和生物医学本体论,以创建一个统一数据集,用于评估事实正确性和上下文基础。
MediEval框架:数据构建
数据构建流程始于MIMIC-IV数据库,利用两种不同的模态:结构化表格数据(使用ICD和NDC标准编码的诊断、程序和药物)和非结构化出院摘要,包含约22个临床部分。对于每次患者入院 a,框架定义结构化事件集 Sa 和出院摘要部分集 DSa。
该过程涉及几个关键步骤,将原始EHR数据转换为推理基准。首先,情境提取选择最能捕捉患者轨迹的特定出院摘要部分,如简要住院过程和现病史,以形成评估情境 Ca。其次,语义规范化使用统一医学语言系统(UMLS)将异质医学代码映射到统一的语义空间。原始代码 z 通过函数 f 转换为概念唯一标识符(CUI),得到规范化集合 Ua={f(z)∣z∈Sa}。
有关数据处理流程的概述,请参阅框架图。
第三,本体图构建步骤构建语义图 G=(V,E),其中节点是CUI,边代表来自UMLS元词表的关系(例如,treated_by、has_associated_procedure)。该图支持多跳推理,允许系统遍历长度最多为三的路径以捕获间接临床关联。对于概念 h 和 t,关系定义为 R(h,t)={r∣(h,r,t)∈G,d(h,t)≤3}。
最后,基于象限的陈述构建基于图中找到的事实关系 (h,r,t) 生成样本。该框架创建四个不同的象限以测试不同的失效模式:
- Q1(真-支持):在患者情境中直接证实的事实。
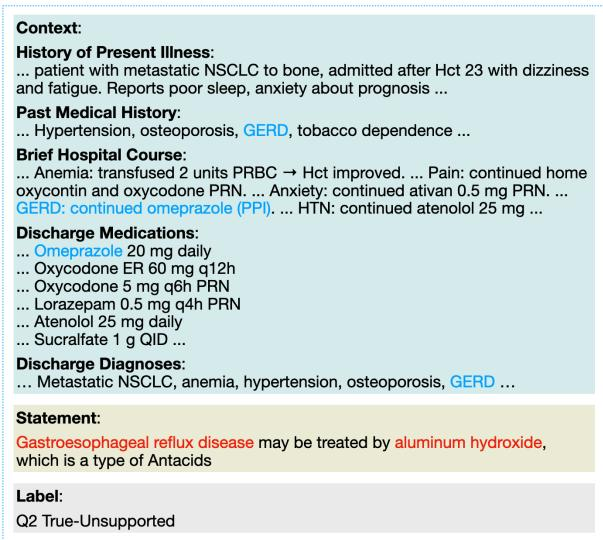
- Q2(真-不支持):医学上正确的陈述,但将实体替换为来自本体图的、患者情境中不存在的相关替代物。
- Q3(假-支持):通过重新组合情境中全部存在的实体而创建的虚假关系。
- Q4(假-不支持):涉及语义上遥远的干扰实体的陈述,使其既假又不被支持。
下面提供了Q2陈述的示例。
LLM评估与训练
评估任务被形式化为一个四路自然语言推理(NLI)问题,其中模型必须将陈述分类到四个象限之一。为了衡量临床安全性,作者引入了关键错误率,特别是幻觉支持率(HSR)和真相反转率(TIR),用于量化模型为真实陈述幻觉证据或将虚假陈述提升为有效证据的倾向。
为了在这些安全关键任务上提高模型性能,作者提出了CoRFu(反事实风险感知微调)。与标准监督微调不同,CoRFu采用对比偏好学习方法。训练在偏好三元组 (c,yw,yl) 上进行,其中 c 是临床情境,yw 是偏好(支持)的陈述,yl 是来自反事实象限的不偏好陈述。
CoRFu损失函数通过不对称惩罚增强了标准直接偏好优化(DPO)目标。令 S(c;yw,yl) 为DPO偏好边际。损失定义为:
LCoRFu=−E[logσ(S)]+λ⋅E[I(S<0)⋅S2].第一项鼓励模型偏好支持的陈述。第二项引入二次惩罚,仅在模型错误地排名不偏好陈述更高时激活(S<0)。这种缩放不成比例地惩罚高置信度错误,使优化压力与临床安全要求对齐。
实验
MediEval框架在四路NLI任务上评估LLM,该任务联合判断事实正确性和患者基础,使用准确率、宏F1以及安全关键错误率(HSR和TIR)指标,在一个从MIMIC-IV导出的37,144个样本数据集上进行。对15个LLM的基准测试显示总体性能有限(准确率59.3%至73.9%),领域特定模型表现不佳,安全指标通常与聚合F1不一致,例如Llama-3.3-70B取得了最佳宏F1但并非最低错误率。对比偏好优化(CoRFu)持续优于SFT和DPO基线,其中Q1 vs. Q2配对在准确率、宏F1和幻觉支持减少方面带来最大提升,而针对性配对则选择性减轻特定风险。消融实验确认适度的 λ 值在性能提升和安全增益之间取得平衡,强调了将准确率与安全关键错误分离对于临床可靠推理至关重要。
MediEval上的总体性能有限,最强的模型实现了最高的聚合指标,但不一定是最安全的。CoRFu相对于基线和DPO模型有所改进,其中支持与不支持真相的对比配对在不同骨干网上产生了最一致的增益。安全指标显示,更高的宏F1并不保证更低的关键错误率,不同的对比目标选择性减轻风险。Llama-3.3-70B-Instruct在总体准确率和F1方面领先,但Mixtral-8x7B在宏F1较低的情况下显示出最低的关键错误率。CoRFu与Q1 vs. Q2对比配对实现了最大的聚合改进,并在Llama-3.1-8B上将TIR降至零。对比配对在每象限上产生针对性增益,准确率的提升并不会自动转化为安全关键错误的减少。
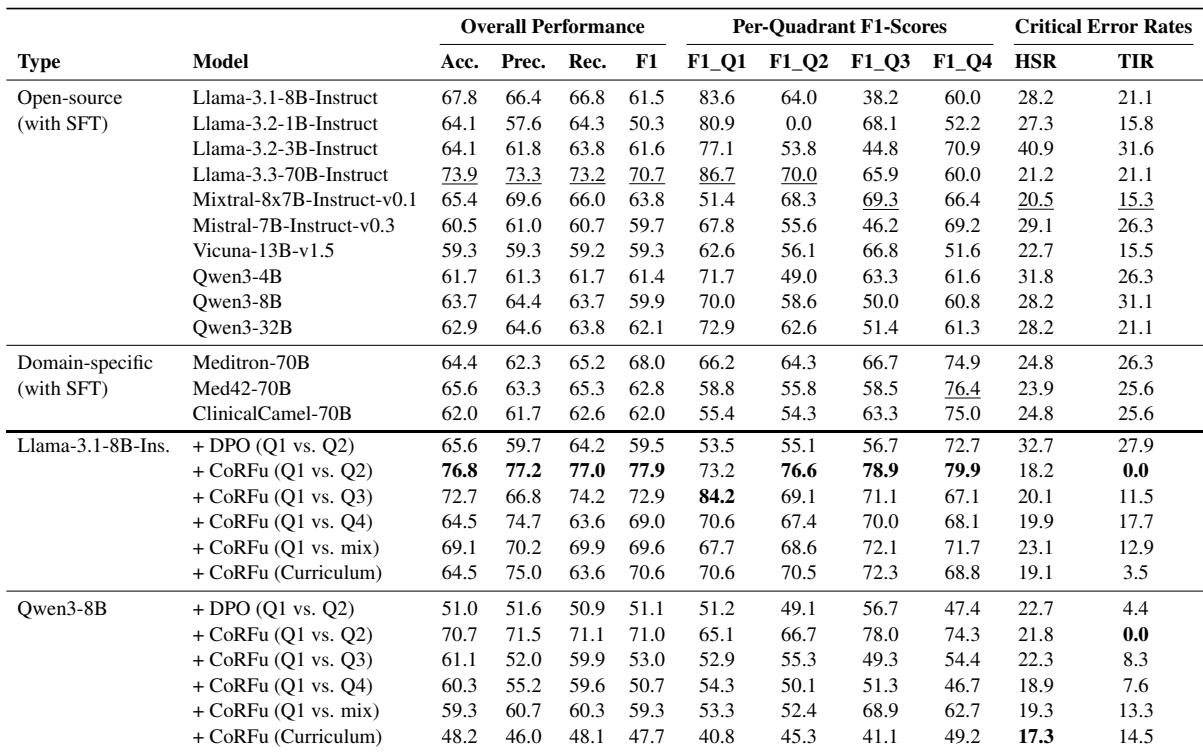
在MediEval上的实验表明,聚合指标最强的模型不一定是最安全的,因为更高的宏F1并不保证更低的关键错误率。CoRFu持续优于基线和DPO模型,其中支持与不支持真相的对比配对产生最稳定的增益,而不同的对比目标选择性减轻特定风险。尽管Llama-3.3-70B-Instruct在准确率和F1上领先,Mixtral-8x7B实现了最低的关键错误率,而Llama-3.1-8B上的Q1 vs. Q2配对在消除TIR的同时实现了最大的聚合改进。总体而言,对比配对产生有针对性的每象限增益,准确率的提升不会自动转化为安全关键错误的减少。