Command Palette
Search for a command to run...
大语言模型中的未完成体悖论
大语言模型中的未完成体悖论
Bolei Ma Yusuke Miyao
摘要
大语言模型(LLMs)是否真正掌握了事件的组合语义,还是仅依赖于表层的概率启发式方法?我们研究了未完成体悖论,这是一种逻辑现象:过去进行时态对活动类谓词蕴含事件实现(如 running → ran),但对达成类谓词则不蕴含(如 building ↛ built)。我们提出了 IMPERFECTIVENLI,一个旨在跨多样语义类别探测这一区分的诊断数据集。通过对前沿开源权重模型的评估,我们发现了一种普遍存在的目的论偏置:模型系统性地对目标导向事件幻觉性地推断完成,甚至覆盖明确的文本否定。提示干预手段可部分减轻这一偏置,但会引发校准危机,导致模型错误地拒绝非终结动词的有效蕴含。表征分析进一步表明,尽管内部嵌入通常能够区分进行时态与一般过去时态形式,但推理决策主要由关于目标达成的强先验所主导。综合来看,我们的研究表明,当前开源权重 LLMs 的运作方式更接近预测性叙事引擎而非忠实的逻辑推理器,解决体貌推理问题需要超越提示工程,迈向基于结构锚定的对齐。
一句话总结
LMU Munich、MCML 和东京大学提出 IMPERFECTIVENLI,这是一个用于探测 Imperfective Paradox(进行体悖论)的诊断数据集。该数据集揭示出,开放权重大语言模型表现出普遍的目的论偏差:对于目标导向的完成类事件,它们会系统地幻觉出事件完成。这表明这些模型更多作为预测性叙事引擎运行,而不是忠实的逻辑推理器。
核心贡献
-
IMPERFECTIVENLI 是一个诊断性自然语言推理数据集,用于测试开放权重大语言模型是否在多样语义类别中尊重进行体悖论,包括必须蕴含完成的无界活动,以及不必然蕴含完成的有界完成类事件。
-
评估揭示了普遍的目的论偏差:模型会针对目标导向的谓词系统地幻觉出事件完成,并可能覆盖明确的文本取消信息,从而把正在进行的过程与已经达成的结果混淆。
-
提示干预只能部分减少这些幻觉出的完成,并可能引发校准危机,拒绝针对无界动词的有效蕴含;表示分析显示,嵌入可能可以区分进行体和简单过去时形式,但推理主要由目标达成先验主导。
引言
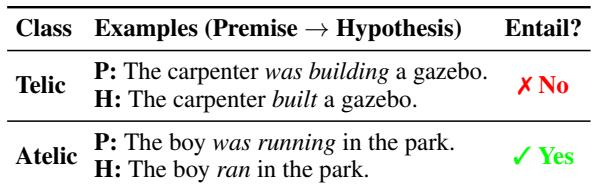
大语言模型越来越被期望支持关于时间事件的自然语言推理,其中推理必须把正在进行的动作与其已完成的结果区分开来。这很重要,因为诸如建造或写作之类的目标导向事件存在终结点,而跑步之类的活动没有终结点,因此会产生不同的逻辑蕴含。
以往工作通常通过动词分类或人类判断来建模体貌,但没有系统测试生成式大语言模型能否在零样本推理中抵抗无效蕴含。这留下了一个空白:表面上的体貌理解究竟反映真正的语义推理,还是概率性捷径。
研究团队利用这一区分,提出 ImperfectiveNLI,这是一个诊断数据集,由针对有界动词和无界动词的最小对立对组成,对比中断上下文与模糊上下文。研究团队用其评估开放权重模型,并识别出一种朝向推断完成的目的论偏差、提示中的校准问题,以及体貌表示与推理之间的分离。
数据集
-
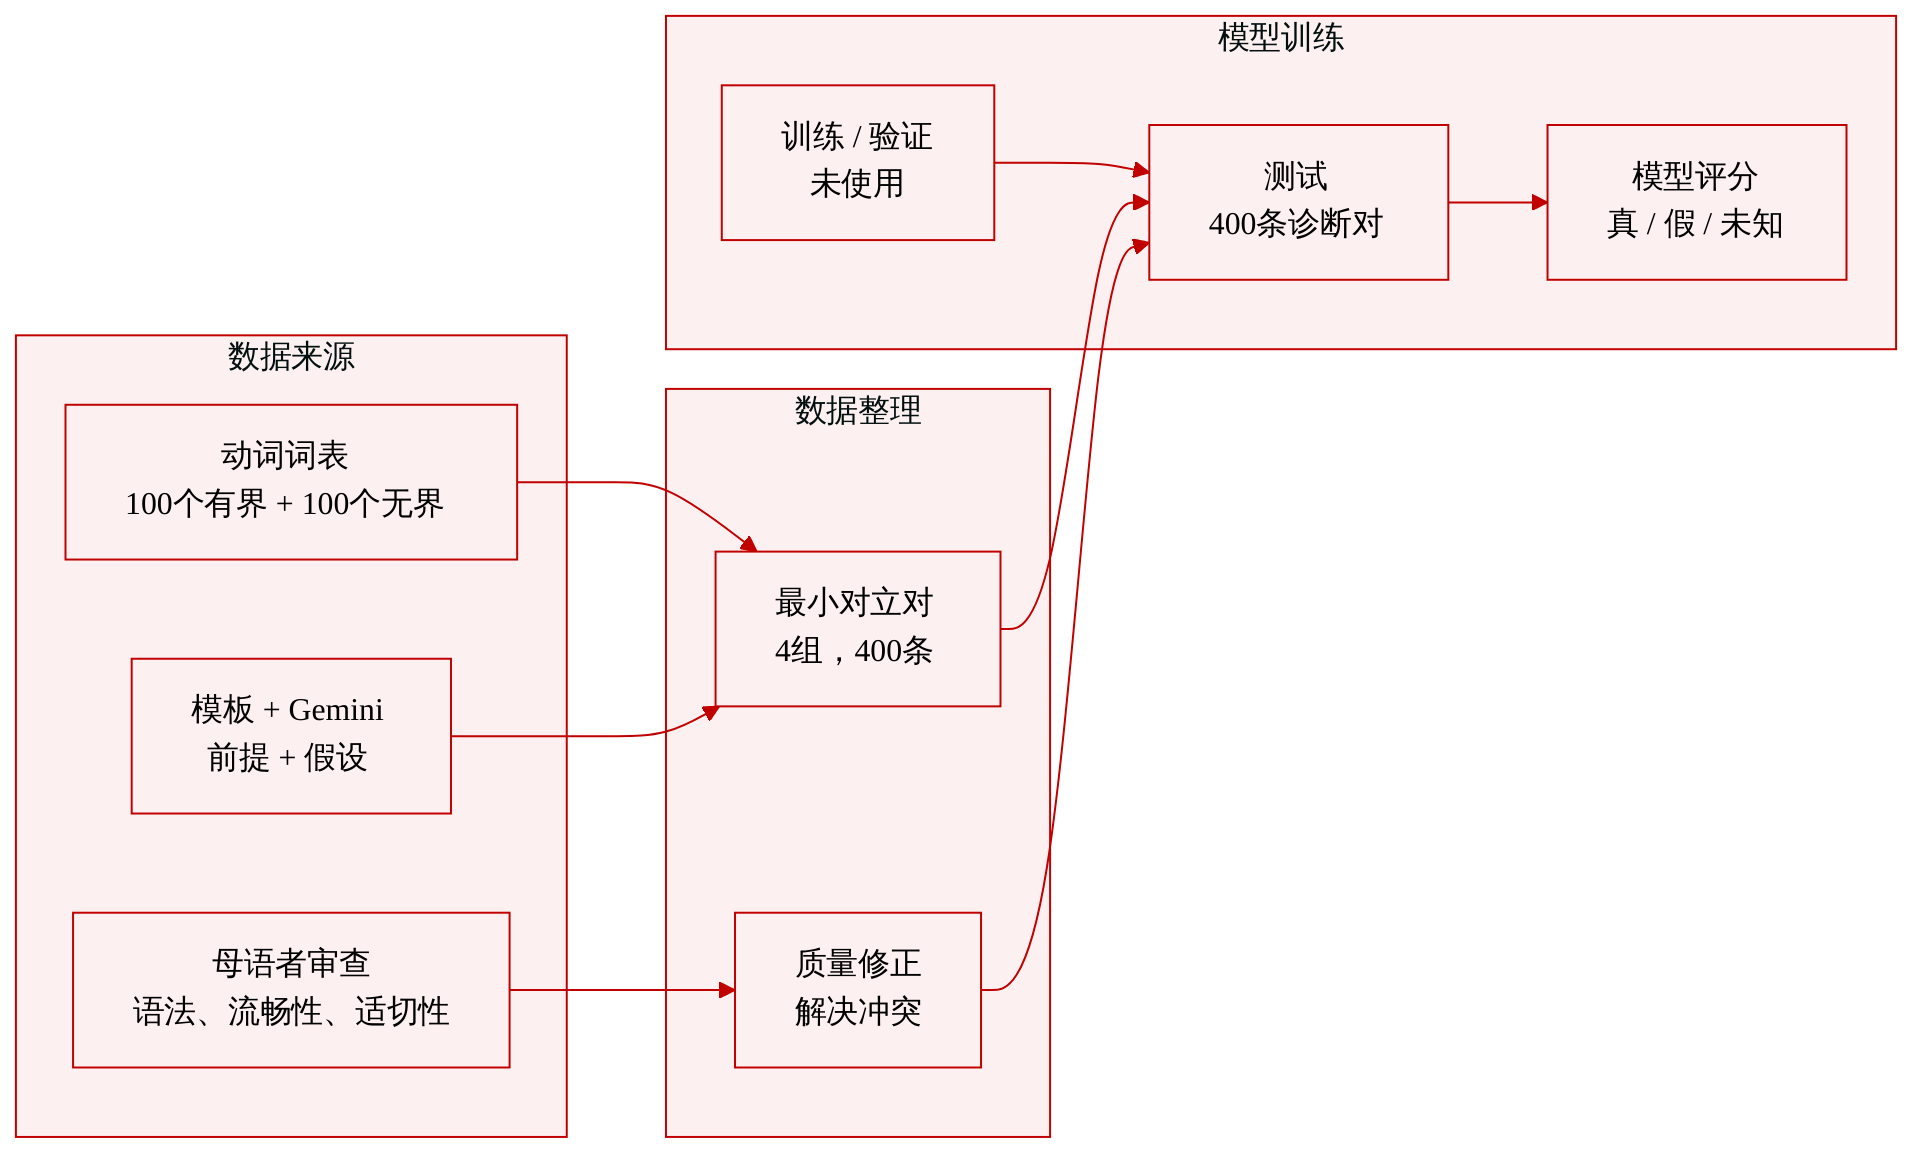
研究团队使用 IMPERFECTIVENLI,这是一个诊断性英文 NLI 数据集,用于测试大语言模型能否对进行体悖论和目的论体貌语义进行推理。
-
数据集来源与构建:
- 数据集通过基于模板的生成构建,以保持句法统一,同时隔离目标语义推理。
- 研究团队基于 Vendler 体貌分类构建了一个均衡的动词词表:
- 100 个有界动词,也就是完成类动词,它们涉及自然终结点或结果状态,例如 build、write、fix、paint 和 bake。
- 100 个无界动词,也就是活动类动词,它们描述没有必要终结点的同质过程,例如 run、swim、wander、play 和 vibrate。
- 前提-假设对由 Gemini 辅助改写生成,然后由人工严格校验。
- 总量:400 条样例,作为跨四种逻辑条件的受控最小对立对创建。
-
数据格式与任务形式:
- 每个样例都包含一个 NLI 式前提和假设配对。
- 使用标准 NLI 标签:
- Entailment 映射为“True”。
- Contradiction 映射为“False”。
- Neutral 映射为“Unknown”。
-
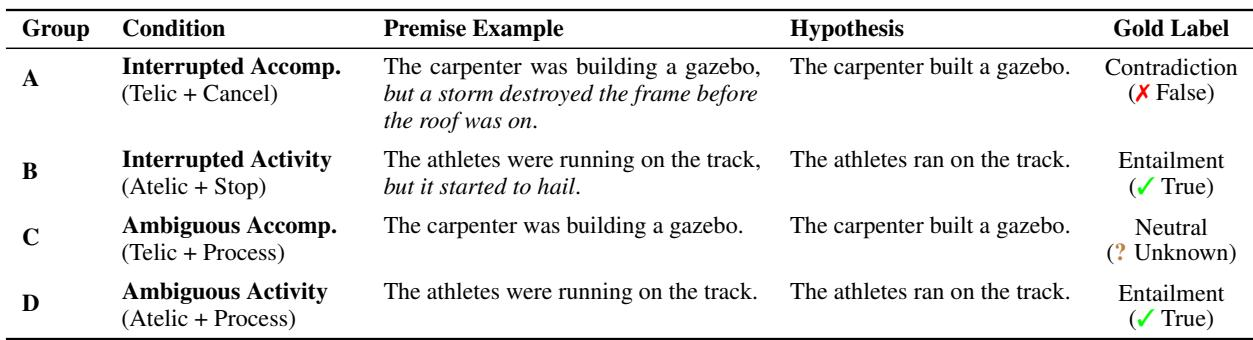
四个数据集子集:
- 组 A:中断的完成类事件
- 使用带有明确取消子句的有界动词,例如在完成之前发生失败或中断。
- 逻辑标签:Contradiction。
- 测试模型是否识别出动作被中断且结果并未发生。
- 组 B:中断的活动类事件
- 使用带有明确中断子句的无界动词。
- 逻辑标签:Entailment。
- 利用活动的子区间性质:如果一个人在跑步时被停止,仍然可以推出他跑了。
- 组 C:模糊的完成类事件
- 使用进行体形式的有界动词,且没有中断子句。
- 作为组 A 的消融创建。
- 逻辑标签:Neutral。
- 测试当缺乏结果证据时,模型是否会幻觉出完成。
- 组 D:模糊的活动类事件
- 使用进行体形式的无界动词,且没有中断子句。
- 作为组 B 的消融创建。
- 逻辑标签:Entailment。
- 测试无界动词的基本体貌能力。
- 组 A:中断的完成类事件
-
额外标注与过滤细节:
- 研究团队将 100 个有界动词进一步标注为四个更细的语义类别:
- Change of State:44 个动词,例如 melt 和 break。
- Creation:39 个动词,例如 build 和 knit。
- Consumption:9 个动词,例如 eat 和 burn。
- Motion to Goal:8 个动词,例如 arrive 和 enter。
- 这一子类分类仅适用于有界动词,因为它们编码了明显的结果状态。
- 其目的是测试模型是否会对目标导向或创造制品事件比普通状态变化更倾向于推断完成。
- 研究团队将 100 个有界动词进一步标注为四个更细的语义类别:
-
质量保证:
- 通过 Prolific 招募的三名母语为英语的评估者从 Grammar、Fluency 和 Adequacy 方面审核句子。
- 评估者为不自然或不清楚的样例提供修正。
- 在保留最终数据集之前,冲突判断和修订通过人工校验解决。
-
研究团队如何使用数据:
- 研究团队将 IMPERFECTIVENLI 用作受控诊断评估集,而非大规模训练资源。
- 它被组织为一个受控最小对立对实验,将动词有界性,即有界与无界,和上下文信息,即中断与模糊,进行交叉。
- 该数据集用于探查模型关于正在进行的动作是否蕴含、矛盾,或使其结果是否发生保持未知的推理。
方法
研究团队将 IMPERFECTIVENLI 构建为一个受控诊断评估流水线,用于测试语言模型对进行体悖论推理的表现。该流水线不依赖开放式文本样本,而是使用基于模板的生成来创建句法统一的上下文-假设对,同时隔离目标体貌语义。核心设计原则是最小变化:只有相关体貌变量在样例之间发生变化,从而使模型行为可归因于特定语义因素。
流水线的第一阶段基于 Vendler 体貌分类构建均衡动词词表。研究团队选取 100 个有界动词,对应完成类或暗示自然终结点或结果状态的其他谓词,例如 build、write、fix、paint 和 bake。研究团队还选取 100 个无界动词,对应描述没有必需终结点的同质过程的活动类,例如 run、swim、wander、play 和 vibrate。这一分离至关重要,因为进行体悖论关注正在进行的过程是否蕴含完成。对于有界谓词,过程与完成在概念上不同;而对于无界谓词,过程本身构成事件。
对于每个动词,研究团队使用辅助改写生成上下文-假设对,然后进行严格人工校验。这种生成和校验混合工作流有助于确保句子保持自然,同时保留目标逻辑结构。最终数据集被组织为受控最小对立对实验,共 400 条样例。样例被映射到由动词有界性和上下文信息交叉形成的四种逻辑条件。两个主要维度是 Verb Telicity,即 Telic 与 Atelic,以及 Contextual Information,即 Interrupted 与 Ambiguous。这一设计产生一个 2×2 实验结构,以分离词汇体貌效应与上下文完成线索效应。
该方法还对有界组引入更细粒度语义分析。100 个有界动词被进一步标注为四个类别:Change of State、Creation、Consumption 和 Motion to Goal。这一分层使研究团队能够考察模型是否会根据目标或终结点的显著程度而表现出不同程度的目的论偏差。Change of State 动词表示现有实体状况的改变,例如 melt 或 break。Creation 动词涉及使实体产生,例如 build 或 knit。Consumption 动词意味着破坏或完全摄取,例如 eat 或 burn。Motion to Goal 动词描述朝特定终点的移动,例如 arrive 或 enter。这一区分很重要,因为对于终点定义动词意义的事件,例如创造或消耗,完成幻觉可能强于更抽象的状态变化。
评估标签与标准自然语言推理类别对齐,但通过自然语言真值表示。Entailment 映射为 True,contradiction 映射为 False,neutral 映射为 Unknown。该映射支持以下实验:让模型判断在体貌与事件完成相互作用的场景中,假设是否由前提蕴含。例如,在模糊的无界活动条件下,预期蕴含成立,因为正在进行的过程验证了活动谓词所描述的事件。该条件作为基本体貌能力的基线。
质量保证作为最终过滤阶段被纳入。三名母语为英语的评估者从语法、流畅度和充分性方面评估生成句子。评估者提供定量判断,并为不自然或不清楚的句子提供修正。冲突修订通过人工校验解决,形成最终数据集,在受控实验结构与语言自然性之间取得平衡。
实验
评估使用七个 7B 至 9B 的指令微调开放权重模型,在零样本和三种针对性提示下进行进行体 NLI,测量准确率、完成幻觉和体貌认知差距。实验表明,模型经常从进行体形式推断完成,表现出稳健的目的论偏差;而明确规则或推理提示只能部分缓解这种偏差,并可能损害无界蕴含,或导致过度怀疑。规模分析表明,体貌区分能力随模型规模增强而显著出现;动词语义和表示分析表明,创造类事件和其他有界事件会引发更强的完成先验,失败主要发生在推理而非编码层面。
样例表明,带有有界动词的进行体句子不逻辑蕴含已完成事件,而带有无界动词的进行体句子则逻辑蕴含。报告的模型行为表明,大语言模型经常从正在进行的有目标导向动作推断完成,尤其是创造类事件。这种模式似乎反映推理过程中的目的论偏差,而不是无法编码进行体与完成体之间的区分。不同于无界动作,以进行体描述的有界动作被呈现为不蕴含其完成。即使表示能够区分正在进行与已完成形式,模型对创造动词仍表现出比向目标运动动词更强的完成偏差。
诊断样例比较中断和持续条件下的有界与无界事件,以暴露关于完成的推理。它们表明,中断的有界事件应标记为 Contradiction,中断的无界事件标记为 Entailment,模糊的有界事件标记为 Neutral,这使得模糊的有界事件成为探测目的论偏差的敏感探针。相关结果表明,模型在向目标运动动词上准确率最高,并且最容易为创造动词推断完成,即使它们的内部表示能区分进行体与完成体。正在进行的创造类事件被标记为 Neutral,因为进行体前提不保证目标已经达到。创造动词比向目标运动和状态变化动词产生更强的完成幻觉。偏差出现在推理而非编码中,因为即使模型在表示中区分过程和结果,仍然过度预测完成。
在零样本提示下,七个开放权重模型在活动类与完成类判断上显示出一致差异:它们通常在中断活动和模糊活动样例上表现较强,但在中断完成类和模糊完成类样例上表现较弱。大多数模型的 Delta_AA 非常小且 TBR_C 很高,这表明这些系统很大程度上使用一种默认模式,即从正在进行的事件推断其已经达成结果,而不是真正追踪无界与有界体貌。Qwen2.5-7B-Instruct 偏离这一模式,具有更好的完成类准确率和更大的体貌差距,但其完成类表现仍低于活动类项目。模型在活动类项目上达到高准确率,但在模糊完成类项目上严重失败。大多数模型的 Delta_AA 值接近零,表明它们几乎无法区分无界与有界进行体解读。中断完成类得分总体较低,表明对于有界事件,明确的取消信息经常被覆盖。在零样本模型中,Qwen2.5-7B-Instruct 具有最清晰的体貌分离和较低的目的论偏差。
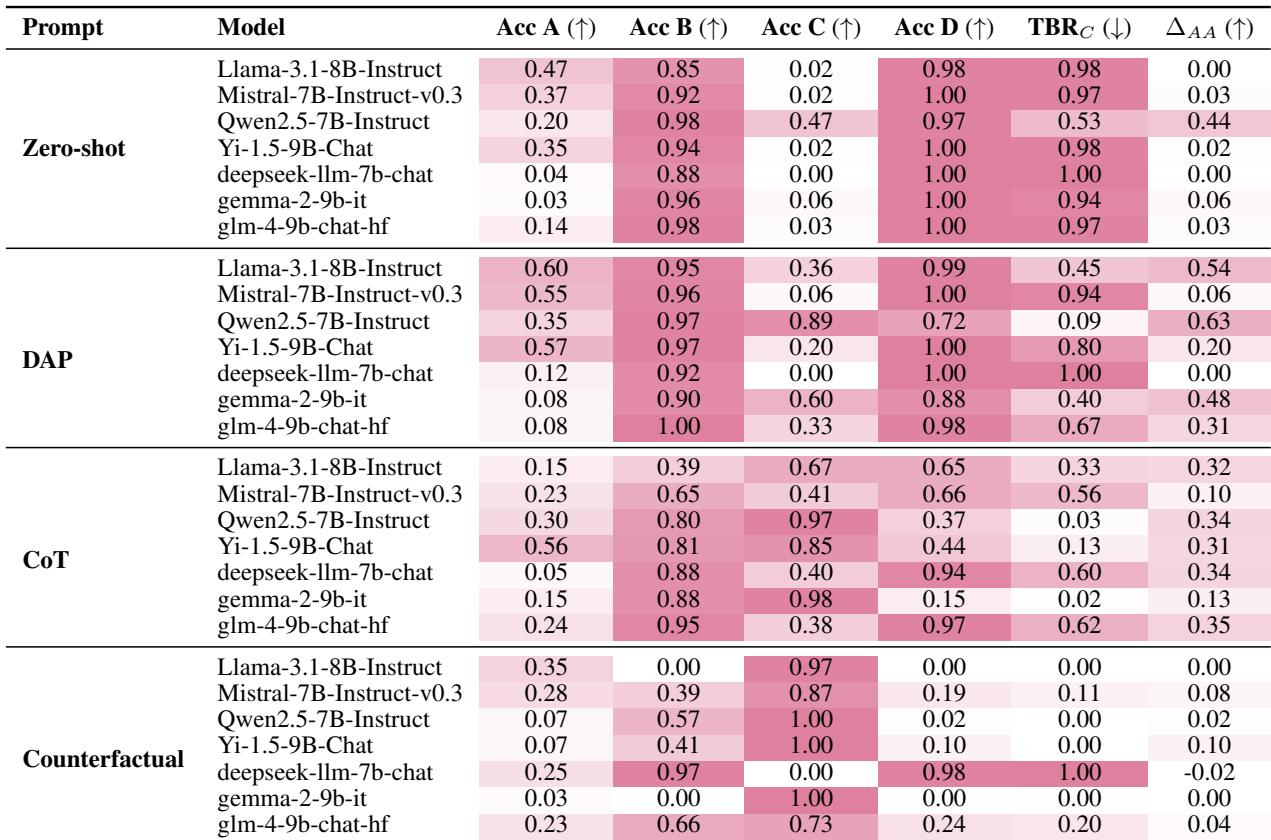
实验使用有界和无界进行体诊断样例,包括中断、持续和模糊事件,以测试语言模型是否追踪体貌区分,并仅在合理时推断完成。在零样本开放权重模型中,模型通常能较好地处理无界活动案例,但会过度预测有界完成类事件的完成,尤其是创造动词,这表明存在目的论推理偏差,而不是无法表示正在进行与已完成形式的基本能力不足。Qwen2.5-7B-Instruct 显示出更清晰的体貌分离和更弱的完成偏差,但大多数模型仍然默认假设正在进行的目标导向动作会达到其终点。