Command Palette
Search for a command to run...
注意(DH)差距!推理型与对话型大语言模型在风险决策中的对比
注意(DH)差距!推理型与对话型大语言模型在风险决策中的对比
Luise Ge Yongyan Zhang Yevgeniy Vorobeychik
摘要
大语言模型作为决策支持系统或应用于智能体工作流中,正在迅速改变数字生态系统。然而,学界对大语言模型在不确定环境下的决策行为的理解仍然有限。我们从两个维度研究大语言模型的风险决策:(1)前景表征(基于显式表征或结果历史)和(2)决策理由(解释)。我们的研究涉及 20 个前沿和开源大语言模型,并辅以一项匹配的人类被试实验作为参考基准,同时以期望收益最大化的理性智能体模型作为另一参照。研究发现大语言模型可分为两类:推理模型(RM)和对话模型(CM)。推理模型趋向理性行为,对前景顺序、收益/损失框架及解释均不敏感,且无论前景以显式形式还是通过结果历史呈现,其行为表现相似。对话模型的理性程度显著更低,略更接近人类行为,对前景顺序、框架及解释敏感,并表现出较大的描述-历史差距。对开源大语言模型的配对比较表明,区分推理模型与对话模型的关键因素在于是否经过数学推理训练。
一句话总结
圣路易斯华盛顿大学的研究人员在一项与人类被试实验相匹配的对照实验中,评估了 20 个前沿与开源 LLM 的风险决策,发现推理模型表现理性,而对话模型表现出类人偏差和显著的描述-历史差距,并认为数学推理训练是区分二者的关键因素。
核心贡献
-
一个受控的双选项风险选择基准将 20 个前沿与开源 LLM 与匹配的人类选择以及一个追求期望收益最大化的理性 agent 参考基准进行比较。该基准改变前景呈现形式,例如显式描述或结果历史,也改变解释提示、选项顺序和收益/损失框架。
-
LLM 的风险选择行为分为推理模型和对话模型:推理模型近似追求期望收益最大化,对前景顺序、收益/损失框架、解释以及呈现形式相对不敏感;对话模型则较少理性、更依赖语境,并且有时更接近人类偏差。
-
所有被评估模型都表现出描述-历史差距,且对话模型的差距大于推理模型。解释提示会改变选择,通常在简短解释下使对话模型更接近理性 agent;对开源 LLM 的配对比较表明,面向数学推理的微调使两类模型相互区分。
引言
大语言模型越来越多地用于决策支持和 agent 工作流,使它们在不确定性下的行为与经济和实践应用相关。传统决策模型假设 agent 追求期望收益最大化,但 LLM 可能不会遵循这一模式,因为它们的能力来自多种训练方法,例如下一词预测、指令微调、人类偏好对齐和数学推理。
既有关于 LLM 决策的研究对理性以及是否符合人类行为模型得出了相互矛盾的结论。这些研究也大多只关注单一理论,模型覆盖有限,忽略风险选项的呈现方式,或缺少在匹配条件下与人类选择进行直接比较。
作者通过在一项受控的双选项风险选择基准中研究 20 个前沿与开源 LLM 以及人类被试来弥补这些空缺。他们将显式前景描述与结果历史呈现进行比较,并检验请求解释是否会改变选择。该工作更清晰地说明了模型系列、任务呈现方式和解释提示如何塑造 LLM 的经济行为。
数据集
-
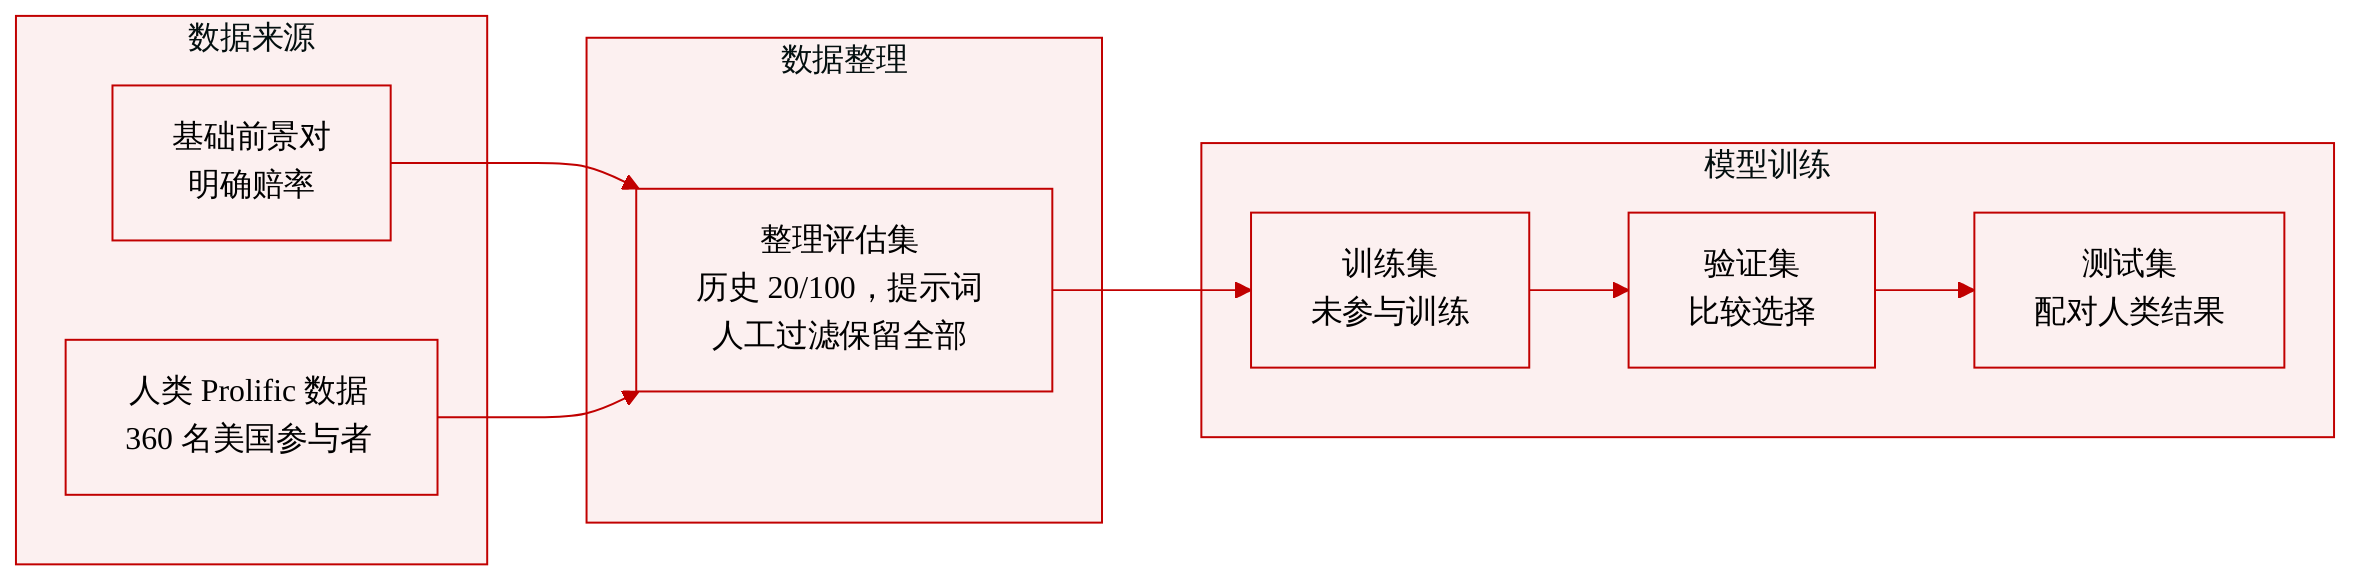
该数据集是一个用于比较 LLM 和人类在不同前景之间选择的受控评估集合。核心刺激包含三组基础前景对。这些前景对被设计为覆盖不同结果量级,并有意与经典行为经济学任务相似但不重复,从而有助于降低 LLM 的记忆效应。
-
前景对以两种互补形式呈现:
- 显式前景:每个选项直接以收益-概率对呈现,例如 100的700 的 30% 概率。
- 隐式前景:相同的底层分布被转换为模拟历史,即重复选择后得到的实际收益序列。历史使用 20 和 100 个收益样本。
-
历史呈现被视为一个数据子集条件。结果在 20 次试验和 100 次试验的历史长度上进行汇总。因此,数据集同时包含显式描述和采样历史呈现下的相同决策问题。
-
每个决策实例还包含一个提示风格条件:
- 未请求解释:模型仅输出选择。
- 请求简短解释:模型给出一句话理由。
- 请求数学或推理风格解释:模型给出简短的定量或推理式理由。
-
研究还收集了一个独立的人类被试数据集,用于对模型行为进行基准比较。它包含通过 Prolific 招募的 360 名美国参与者的回答。参与者在与模型相同的前景对之间选择,并按平均每小时 $24 的报酬获得补偿。
-
人类数据被视为选择上的一个总体分布。该研究获得机构 IRB 批准。一项初始注意力筛选排除了平均每题少于 8 秒的参与者,但主要结果仍包含所有参与者,因为排除并不实质性改变结果。
-
在使用中,数据集不被描述为训练语料。它被用作模型决策与人类决策的评估和比较资源。主要处理步骤包括将显式分布转换为模拟历史、在历史样本长度上进行汇总、改变解释提示,以及将模型选择与人类选择分布配对。
方法
方法被组织为一个受控行为评估框架,用于测量大语言模型中的决策模式。作者没有将模型输出视为二元答案,而是将每个决策语境视为响应分布中的一个样本,然后使用可解释的选择行为模型分析该分布。
该框架的第一个组成部分是一个结构化前景选择测试床。每个试验都呈现一对具有明确收益和概率特征的选项。这些前景用于测试模型在信息以不同格式呈现时如何响应。作者在构建新刺激时有意借鉴经典行为决策场景,同时降低记忆的可能性。
一个核心设计元素是前景显式与隐式呈现之间的区分。在显式条件下,每个前景直接以一组收益-概率对表示,例如获得收益的指定概率和获得零收益的指定概率。在隐式条件下,相同的底层分布通过模拟历史表示,即决策者在反复选择该前景后会观察到的一系列采样结果。作者比较这些呈现模式下的行为,以捕捉描述-历史差距,其中相同底层前景可能因证据被符号化描述还是被顺序体验而诱发不同选择。模拟历史在多种长度下评估,使方法能够测试对收益模式的重复接触是否以可测量方式改变模型行为。
第二个设计元素是解释提示。对于每个选择,框架支持多种响应风格:仅输出所选前景、提供一句话简短理由,或提供简短数学或推理风格解释。这允许流程评估要求给出理由是否改变模型的选择分布,而不只是改变其生成文本。
为解释观察到的选择,作者拟合基于前景理论的参数模型。这些模型将语境中的选择转化为风险偏好和概率加权模式。一种设定使用风险偏好、损失厌恶、概率加权以及决断度参数。然而,由于损失厌恶和决断度在纯损失语境中可能难以区分,作者使用另一种参数化设定作为主模型。该设定保留风险偏好和概率加权参数,同时用收益和损失各自的决断度参数替换损失厌恶和一般决断度参数。由此得到的解释如下:更大的风险偏好参数表示风险寻求,概率加权参数表示小概率被过度加权还是低度加权,特定框架的决断度参数表示效用差异在收益或损失领域中影响选择的强度。损失领域决断度与收益领域决断度之比作为损失厌恶的代理指标。为避免估计问题,所有参数都被限制在有限范围内;高度确定性的期望效用行为对应于较大的决断度值和中性的风险与概率处理。
行为通过在固定条件下反复查询每个模型来量化。每个语境使用相同输入评估多次,有效的输出被转换为经验选择率。无效输出从选择率计算中排除,但作为原始样本保留。作者还指出,将采样响应数量增加到中等数量以上会最小化定性变化并增加成本,因此该流程使用实际可行的重复查询数量来估计稳定响应分布。
设 x 表示一个完整决策语境,包括一对前景、呈现形式、前景顺序、收益或损失框架,以及解释风格。设 pm(x) 表示模型 m 在语境 x 中选择参照前景的概率。该概率对语言模型和人类被试通过经验估计得到,也可以由拟合的参数模型计算。模型相似度和拟合优度在许多这样的语境上测量。其中一个度量是两个模型响应分布之间的均方误差:
MSE(pm,pm′)=∣X∣1x∈X∑(pm(x)−pm′(x))2.该度量衡量绝对误差,但不能完全反映模型在不同语境中是否一致地响应。为了捕捉这一点,作者还将响应概率视为语境上的分布,并计算两个模型响应向量之间的皮尔逊相关性:
Cor(pm(X),pm′(X)).相关性被用作主要相似度和拟合优度度量,因为它反映一个模型在不同语境中选择倾向的变化是否对应于另一个模型行为中的相似变化。在评估拟合参数模型时,这些度量在留出数据上计算,以评估泛化而非样本内拟合。
该框架还测量行为稳定性。决断度捕捉模型选择一个前景而非另一个前景的确信程度。对于模型 m,其定义为
Dm=∣X∣1x∈X∑max{pm(x),1−pm(x)}.较高值表示更确定的选择,更接近机会水平的值表示更大的不确定性或随机性。
一致性以三种形式测量:顺序一致性、提示一致性和框架一致性。顺序一致性测试改变前景呈现顺序是否改变选择概率。提示一致性测试所请求的解释类型是否改变选择概率。框架一致性测试对于其他方面等价的前景,收益与损失框架是否改变行为。对于顺序一致性和提示一致性,设 S(x) 表示语境 x 的控制变体集合。一致性度量为
Cm(S)=1−∣X∣1x∈X∑x′∈S(x)maxpm(x′)−x′∈S(x)minpm(x′).接近 1 的值表示行为在变化的提示条件下保持稳定,较低的值表示对表面化语境变化的敏感性。框架一致性通过比较相同决策的收益框架和损失框架版本来定义:
Cmframe=1−∣X∣1x∈X∑∣pm(xgain)−(1−pm(xloss))∣.这些模块共同形成一个流程,将原始模型输出转换为稳定决策分布,将这些分布拟合到可解释的行为模型,并不仅根据平均误差评估模型,还评估模型是否表现出连贯、果断和框架稳定的选择行为。
实验
评估比较 20 个语言模型在不确定性下作出的选择、人类样本,以及一个风险中性且追求期望收益最大化的参考模型,并同时使用显式和隐式前景呈现。实验确立了推理模型与对话模型之间的行为分界:推理模型更一致、更果断,并且更接近理性的期望收益最大化;对话模型则更多变,对顺序、框架和提示细节更敏感。更多实验和模型拟合验证,隐式历史会使许多模型转向更接近人类、更不理性的行为,尤其是对对话型和小模型;而推理训练和更大规模提升可预测性以及与经济人模型的对齐程度。
拟合的 dual-beta 参数表明,前沿推理模型在显式前景中的决策接近理性且非常可预测,取值接近 1,并且收益和损失决断度都很高。对话模型通常显示出类似的概率加权,但决断度较低且模型拟合较弱,有些模型在损失决策中一致性明显更低。前沿推理模型表现出非常高的决断度,并且与简单前景理论模型的相关性接近完美。对话模型不如推理模型果断和可预测,其中一个模型显示出极端的损失决断度值。
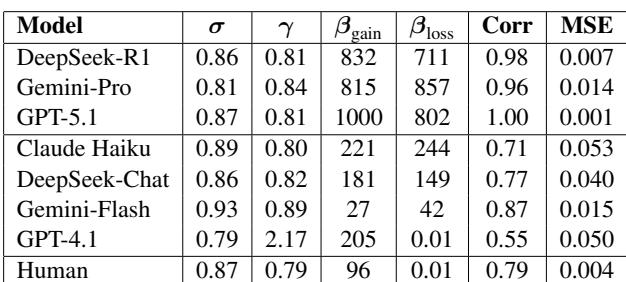
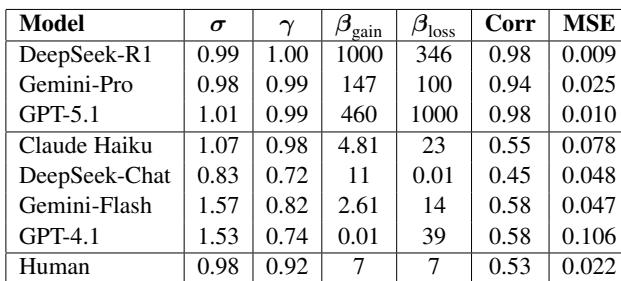
在隐式前景中,推理模型显示出接近理性基准的参数,价值和概率加权接近中性,并且在收益和损失领域中都有非常高的决断度。这些模型也非常容易被 dual-beta 前景理论模型预测,显示出强相关和低拟合误差。对话模型较少确定且拟合较弱,往往具有低得多的决断度、概率过度加权的证据,以及具有更高误差的更弱预测相关性。在隐式前景下,推理模型仍接近理性行为。对话模型表现出低得多的决断度和更弱的可预测性。多个对话模型出现概率过度加权,而一个对话模型在概率加权上仍接近中性。
该表显示,经过推理训练的模型通常比经过指令微调的变体表现出更强且更一致的决策参数。推理型变体具有显著更高的决断度值和低得多的误差,表明其更符合模型并更易于预测。经过推理训练的变体相比可比的指令微调模型具有显著更高的收益和损失决断度。若干指令微调模型显示出接近于零的损失决断度,同时收益决断度高得多。推理型变体相比指令微调变体实现低得多的 MSE 和接近完美相关性。
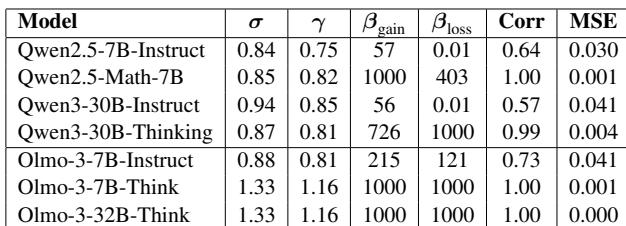
经过推理训练的开源模型往往比指令微调变体更好地拟合隐式前景行为,尤其体现在更高相关性和更低误差上。它们更大的决断度参数将推理型变体与对话型变体区分开来,尽管该效应不如显式前景场景那样均匀。推理型变体通常比指令微调变体显示出高得多的决策决断度。推理型变体与模型预测的相关性更强,表明行为更易于预测。
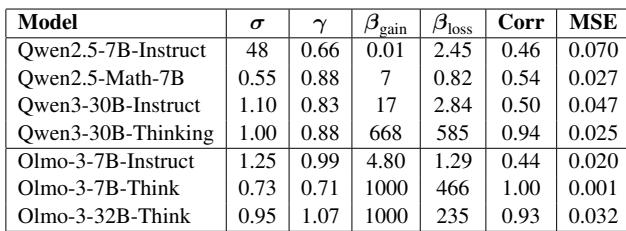
实验使用 dual-beta 前景理论拟合来评估模型在显式和隐式前景下的决策是否理性、果断和可预测,比较前沿推理模型与对话模型,以及经过推理训练的变体与经过指令微调的变体。前沿推理模型接近理性、高度果断,并且被前景理论强烈预测,而对话模型较少果断、较少可预测,并且有时表现出概率过度加权或一致性较弱。比较进一步显示,经过推理训练的变体比指令微调变体表现出更连贯的行为,该效应在显式前景场景中最强,在隐式前景场景下仍然存在但不够均匀。