Command Palette
Search for a command to run...
分层智能声学与语义建模:面向全双工 SLMs 的模态分离与对齐
分层智能声学与语义建模:面向全双工 SLMs 的模态分离与对齐
摘要
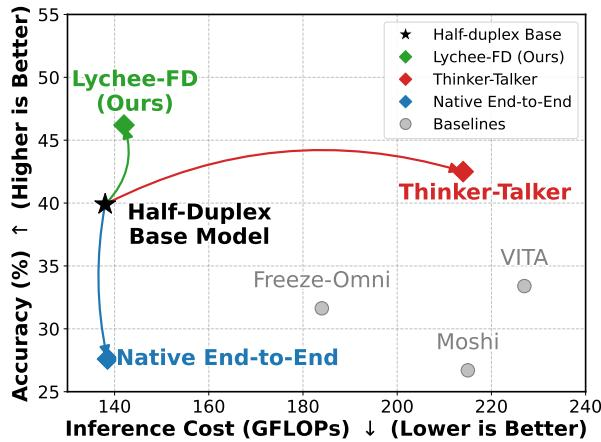
开发流畅、高性能、原生智能的全双工语音语言模型(SLMs)仍是语音与自然语言处理社区面临的关键挑战和长期目标。尽管已取得显著进展,但近期研究从根本上受制于严重的模态干扰问题,该问题导致严重的知识退化并损害语义完整性。本文通过对优化动态的全面细粒度分析,揭示了性能退化的根本原因,发现当声学与语义建模两项任务被迫共享深层参数空间时,二者之间固有的梯度冲突是模态干扰的根源。基于这一关键发现,我们提出了 Lychee-FD,一种旨在缓解模态干扰的原生端到端全双工框架。重要的是,我们提出了一种分层参数分离策略,在深层中解耦存在冲突的模态,同时通过专用的语义对齐通道保持跨模态一致性。在多个全双工基准上的大量实验表明,我们的方法显著推进了最先进水平,在语音智能(Spoken QA 上提升 +7.4%)和全双工交互流畅度(FullDuplexBench 1.5 上提升 +28.5%)两方面均取得了实质性改进。据我们所知,本工作不仅首次识别并严格解释了全双工 SLMs 中模态干扰的根本原因,还提出了兼顾交互效率与鲁棒知识保持的开创性蓝图。
一句话总结
来自哈尔滨工业大学、深圳 Loop Area 研究院和香港中文大学的研究人员提出 Lychee-FD,这是一个全双工 SLM 框架,它将模态干扰归因于声学与语义建模之间的梯度冲突,并通过层级参数分离以及专用语义对齐通道解决这些冲突,在全双工基准上取得了最先进结果。
核心贡献
-
对全双工语音语言模型优化动态的分析表明,模态干扰源于共享深层参数空间中声学与语义建模之间的梯度冲突,表现为优化分歧和语义稀释。
-
提出 Lychee-FD 作为原生端到端全双工框架,通过层级参数分离缓解这种干扰,在深层解耦冲突模态,同时通过专用语义对齐通道保持跨模态一致性。
-
在多个全双工基准上的实验显示出最先进改进,包括 Spoken QA 提升 +7.4%,FullDuplexBench 1.5 提升 +28.5%,表明语音智能与全双工交互流畅度均有提升。
引言
作者将这项研究置于语音语言模型背景下,从文本聊天转向原生语音交互可以让助手更自然,但当前系统通常局限于僵化的话轮转换,而不是人类典型流畅的全双工会话。已有方法在模型必须同时处理语音并保留语义知识时难以应对模态干扰;这导致推理性能下降,而替代设计往往增加训练复杂性或延迟。作者分析了声学与语义目标之间的梯度冲突,然后提出 Lychee-FD,这是一个原生端到端全双工框架,分离深层的声学与语义参数,同时利用语义对齐通道保持稳健推理。
数据集
-
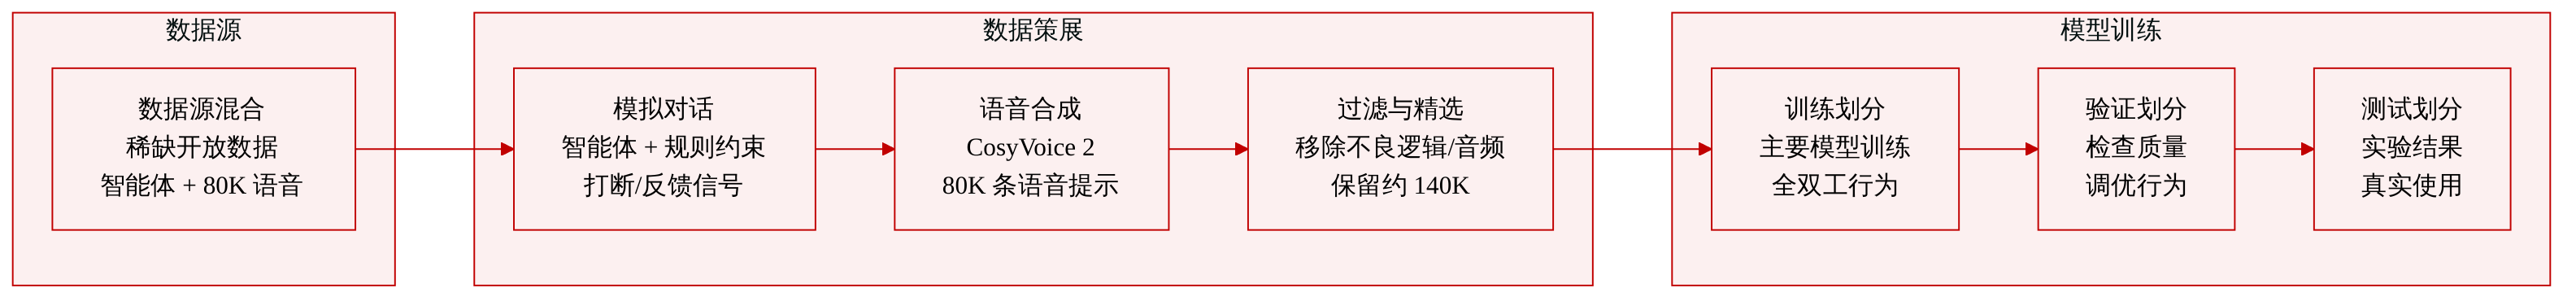
作者构建合成全双工对话数据集,因为开源全双工数据稀缺。
-
数据集包含约 140K 全双工对话实例,覆盖三种交互行为:打断、用户附和以及 AI 附和。
-
对话数据由多个 agents 生成,以模拟真实 User-Assistant 对话。
-
注入基于规则的约束,以触发多样化打断类型,例如话题切换和后续查询,以及自然附和。
-
使用 CosyVoice 2 以 80K 预定义 voice prompts 进行零样本克隆,将转写合成为语音,提供声学多样性与鲁棒性。
-
对样本进行过滤,移除逻辑不一致和低音频质量,得到精选且可靠的训练集。
-
最终数据集用作建模全双工对话行为的主要训练与实验数据。
方法
方法与架构
作者利用优化诊断识别原生全双工模型中模态干扰的根本原因。他们的分析始于使用 StepAudio-2-mini 权重初始化的原生连续对话模型。对于一部分训练样本,他们执行前向传播,并累积 text token 生成损失 Ltext 与 speech token 生成损失 Lspeech 的梯度,但不更新模型参数。对于层 l,通过将相对于层参数 θ(l) 的梯度展平来获得梯度向量:
gtext(l)=∇θ(l)Ltext, gspeech(l)=∇θ(l)Lspeech.使用这些向量,作者用余弦相似度量化两个学习目标之间的对齐程度:
S(l)=cos(gtext(l),gspeech(l)),并通过梯度幅度比检查语义监督的相对强度:
R(l)=gspeech(l)gtext(l).如下所示的优化动态可视化所示:
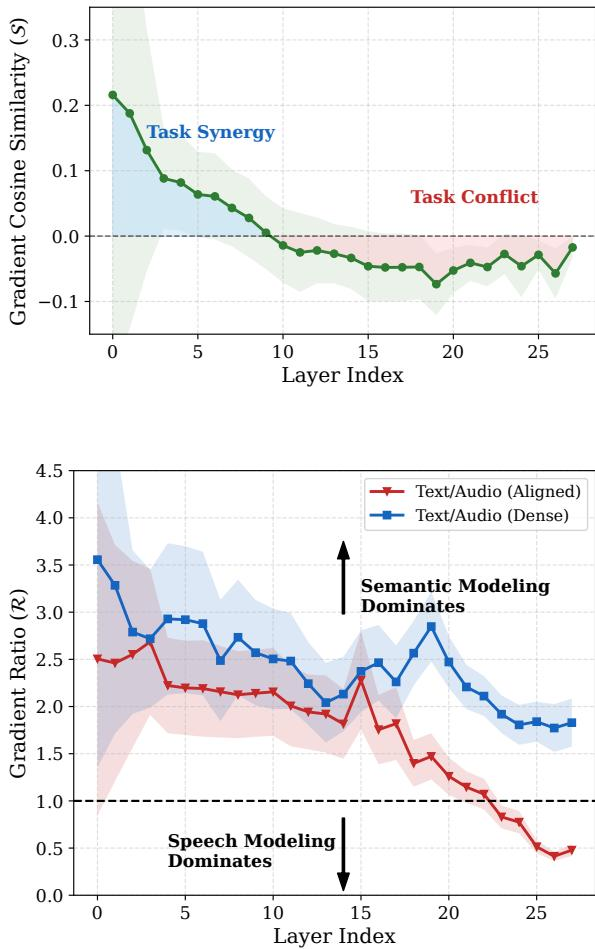
分析揭示了模态之间依赖深度的交互。在浅层,余弦相似度为正,意味着文本与语音梯度指向大致相容的方向。这支持了早期层可从共享低层特征处理中获益的观点。然而,在更深层,相似度变为负值且不稳定,表明声学建模与语义建模开始将共享参数拉向相反方向。梯度比分析进一步表明,使用 padding tokens 强制执行时间对齐会降低文本梯度的相对幅度。因此,稀疏文本监督会削弱语言建模信号,使声学重建主导优化,并导致知识退化。
所提出的 Lychee-FD 框架通过层级参数分离和语义对齐通道直接解决这两个问题。它被设计为原生端到端系统,同时避免 Thinker-Talker 流水线的延迟与冗余,以及完全共享架构中的优化冲突。比较系统架构设计如下:
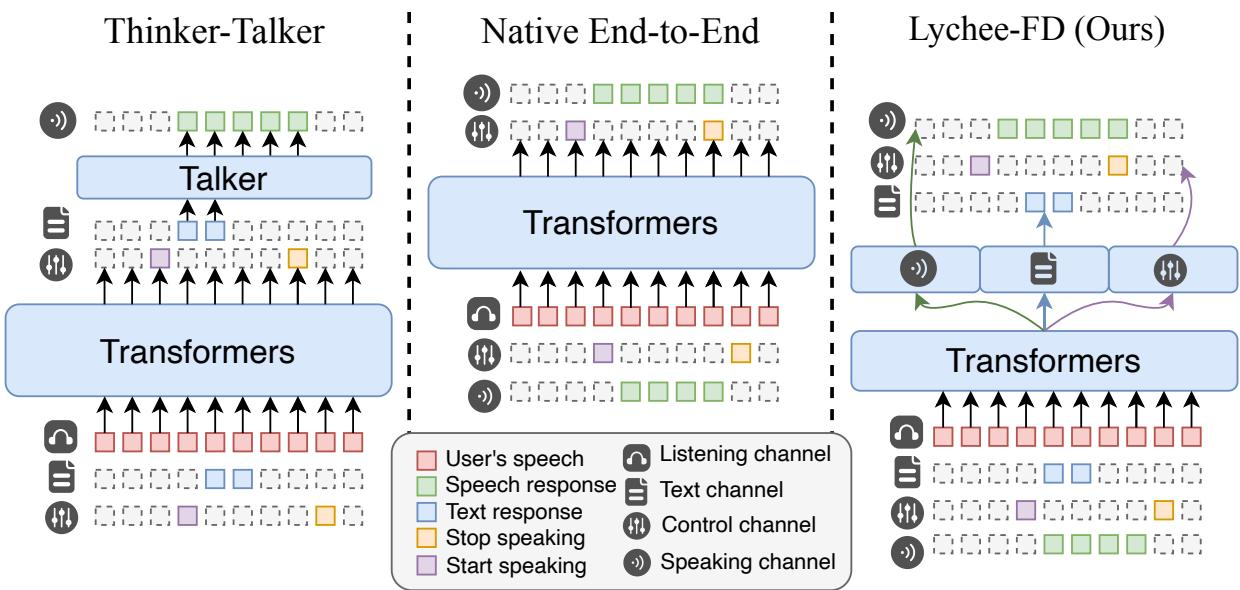
骨干网络始于 Step Audio-2,选择它是因为其公开可用且具有强大的半双工基础。输入语音由 Whisper-v3-large 编码器处理,并使用 CosyVoice 2 tokenizer 以 25 Hz 帧率表示声学输出。这一固定 25 Hz 帧率的声学流对全双工时序很重要,尤其当模型必须持续倾听、回应并管理话轮转换时。
核心架构创新是层级 Transformer,在模态相容处保留共享计算,在梯度冲突处分离参数。令 E∈RN×d 为输入嵌入序列。模型首先经过共享 Transformer 层:
Hshared=Fshared(E;θshared).在更深层,网络分支为三个专门 head:用于文本生成的 Semantic Head、用于语音合成的 Acoustic Head,以及用于交互管理的 Control Head,例如启动与停止行为。对于每个 head m∈{T,A,C},输出 logits 计算为:
Om=Fheadm(Hshared;θm),其中 T、A 与 C 分别表示文本、声学与控制输出。模型使用求和的 next-token prediction loss 进行优化:
L=−m∈{T,A,C}∑t∑logP(ytm∣y<t,E;θ),其中 ytm 是步骤 t 中模态 m 的真实 token。该结构在深层隔离相互冲突的目标,同时仍允许共享低层表示学习。
第二个关键模块是语义对齐通道。模型不只依赖插入的稀疏 text tokens 来与音频帧对齐,而是学习生成内部独白,以提供密集语义监督。并行生成流组织如下:
YT=[t1,t2,…,tn,⟨EOT⟩,⟨pad⟩,…,⟨pad⟩], YA=[a1,a2,…,an,an+1,an+2,…,⟨EOS⟩], YC=[⟨Start⟩,c1,…,ck,⟨Stop⟩].这里,text 流承载独白,acoustic 流承载 speech tokens,control 流管理说话开始与结束。通过使 text 通道显式化,系统为语言建模维持更强的梯度流,并减少由大量填充式对齐方案造成的语义稀释。
为评估观察到的梯度冲突是否特定于某个架构,作者在不同原生端到端全双工模型上重复相同几何分析。每层趋势如下:
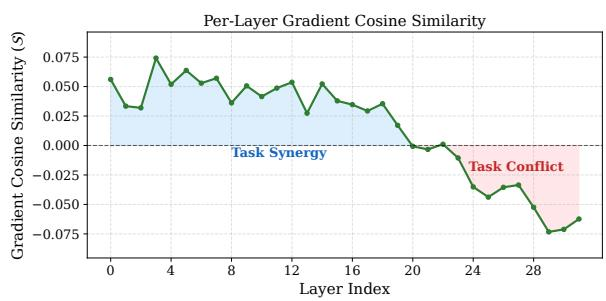
在比较中,浅层与中间层仍显示正向梯度相似度,而深层转为负相似度。这种模式表明,语义与声学目标之间的深层分歧是完全共享端到端语音语言模型的一般瓶颈,而非某个特定设计造成的假象。这些证据强化了在高阶层分离声学参数与语义参数的合理性。
训练流程通过合成全双工对话管线支持该架构。由于原生全双工监督稀缺,作者使用多个 agents 模拟真实 user-assistant 对话。注入基于规则的约束,以触发打断、后续查询、话题切换和附和等行为。生成转写随后通过 CosyVoice 2 使用零样本 voice cloning 转换为语音,生成覆盖多样声学风格的音频。合成后,语料经过过滤,移除逻辑不一致、低质量音频和不可用对齐情况。所得对话数据用于模型在单 epoch regime 下训练。
对于优化,系统使用 AdamW 和余弦学习率调度训练,warmup ratio 为 0.1。实现使用全局 batch size 32,学习率为 3×10⁻⁶。架构配置包括 24 个共享 Transformer 层、text head 4 层、speech head 4 层和 control head 2 层。推理时,text tokens 与 speech tokens 均使用 greedy sampling 生成,并在多个随机种子上平均评估性能。
实验
实验将所提出的全双工语音-语言模型与系统级和原生基线进行比较,使用合成全双工训练数据以及用于口语问答、交互对话和语音生成的基准。结果表明,与共享或流水线式方法相比,显式语义建模和层级参数分离能提升知识保留、话轮转换、打断处理和自然语音质量。消融与梯度分析进一步支持如下结论:分离文本与语音优化可减少模态干扰,并解决完全共享全双工架构中的常见瓶颈。
所评估模型在 speech-to-text 与 speech-to-speech 准确率平均值上均领先,相较原生和系统级比较有所提升。其优势在答案以语音形式产生时最强,同时保持稳定完整接管行为。消融表明,用稀疏时间对齐 text 替代语义监督并共享参数会降低语音答案准确率。全双工准确率优势在未牺牲话轮转换的情况下得以保持。语义对齐通道比稀疏时间对齐 text 更有效地保持知识。层级参数分离在 speech-to-speech 回答中减少模态干扰。
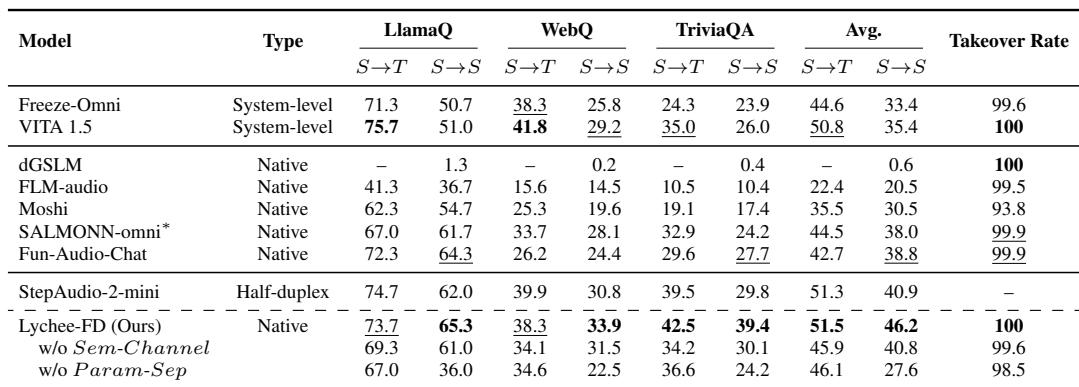
所提出模型在大多数全双工交互与效率指标上领先,在打断响应、附和、话轮转换和停顿处理方面尤其表现突出。它也表现出较低首次响应和打断响应延迟,支持高效实时交互。在困难打断处理上的提升表明,其原生全双工决策优于依赖外部 VAD 的基线。它在多数交互指标上取得最佳结果,而基线通常以过度频繁或延迟响应为代价换取准确率。较低首次响应延迟和较短停止延迟表明该架构避免了明显的实时计算开销。更高的打断响应率和更低的附和接管率表明,相比激进的接管行为,它更具选择性的话轮控制。在困难打断基准上的显著提升显示出相较依赖外部 VAD 系统的明显优势。
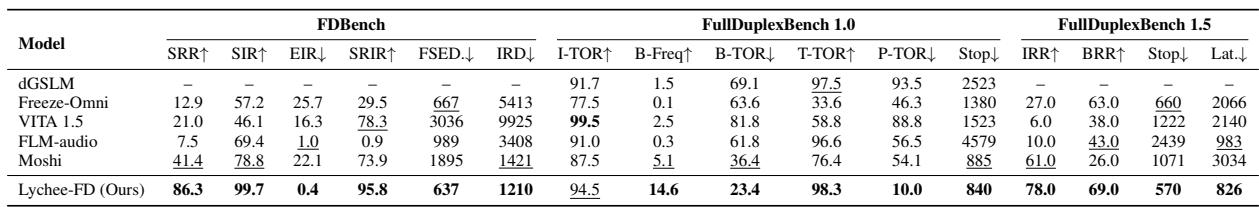
实验在 speech-to-text 与 speech-to-speech 回答准确率,以及全双工交互与效率方面评估模型。结果表明一致的准确率提升,尤其语音答案,同时保持稳定接管行为,并改善对打断、附和、话轮与停顿的选择性控制。消融研究验证了语义对齐监督与层级参数分离的价值,而稀疏时间对齐监督和共享参数会损害语音回答性能。