Command Palette
Search for a command to run...
MAUBERT:面向少样本声学单元发现的通用语音归纳偏置
MAUBERT:面向少样本声学单元发现的通用语音归纳偏置
Angelo Ortiz Tandazo Manel Khentout Youssef Benchekroun Thomas Hueber Emmanuel Dupoux
摘要
本文提出 MAUBERT,它是 HuBERT 的多语言扩展,利用发音动作特征实现鲁棒的跨语言语音表示学习。我们在 55 种语言中基于音素到发音动作特征的映射继续进行 Hu-BERT 预训练。模型从多语言数据中学习预测发音动作特征或音素,从而获得捕捉多语言语音特性的语言无关表示。通过全面的 ABX 可区分性测试,我们证明 MAUBERT 模型产生的表示比最先进的多语言自监督学习模型更具上下文不变性。此外,模型仅需最少的自监督微调(10 小时语音数据)即可有效适应未见过的语言和随意语音。这为在自监督语音模型中注入语言学归纳偏置提供了一种有效方法。
一句话总结
Meta AI Research 等团队提出 MAUBERT,这是 HuBERT 的多语言扩展。它将音素映射到发音特征,覆盖 55 种语言,学习语言无关的音系表征,并在上下文不变的 ABX 判别性上优于自监督基线;只需 10 小时微调即可对未见语言实现有效的少样本适配。
核心贡献
-
MAUBERT 扩展了 HuBERT,通过在 55 种语言上继续预训练,并采用音素到发音特征映射的监督信号,使模型能够预测发音特征或音素。该训练产生能够捕捉多语言音系特性的语言无关表征。
-
ABX 判别性测试表明,MAUBERT 产生了比先进多语言自监督模型更上下文不变的表征。评估还比较了朗读语音和口语,展示了仅需 10 小时自监督微调即可适配口语。
-
模型能够有效适配未见语言和低资源语言,包括仅有不到 2 小时数据的沃洛夫语。这些结果表明,监督发音特征预测能够向自监督语音模型注入语言归纳偏置。
引言
从原始音频中自动发现语言单元对低资源语言的语音技术和早期语言习得建模具有重要意义。自监督语音模型相比传统特征提升了音位判别性,但其发现的单元通常比音素更短、数量更多,仍然对说话人和上下文敏感,并且通常需要大量干净训练数据。论文提出 MAUBERT,在 55 种语言的 IPA 音素和发音特征上微调 HuBERT,以注入显式音系归纳偏置。该方法产生鲁棒的多语言音素表征,仅需约 10 小时无标注语音即可适配新语言,并能够给出候选音素和特征清单。
数据集
-
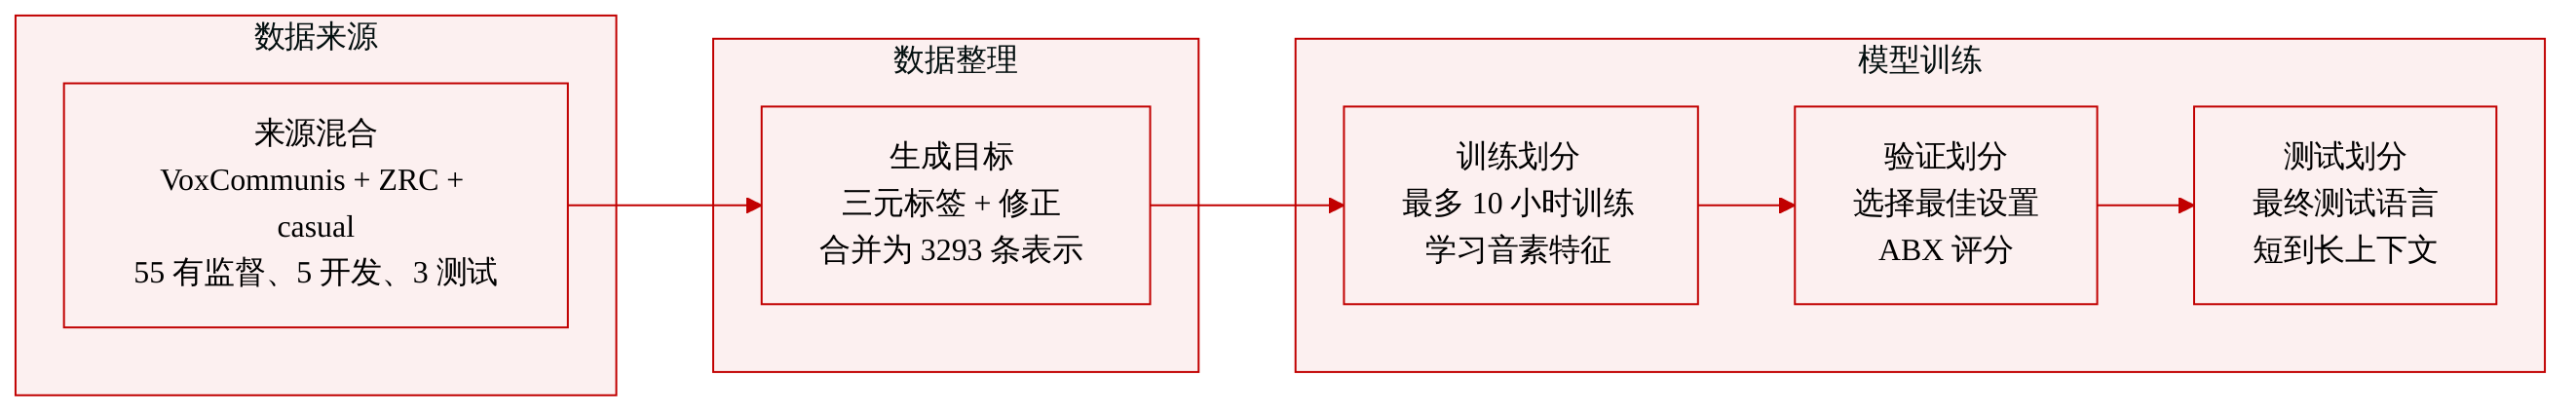
论文作者将数据集基于 VoxCommunis Corpus,该语料库使用 Montreal Forced Aligner 对 Common Voice 子集进行音素级标注。
-
在 63 个 VoxCommunis 语言中,55 种用于监督发音特征预测,共计 788.4 小时;5 种作为开发语言;3 种因作为测试语言而被排除在监督训练之外。
-
音素级标注使用 PanPhon 的特征表转换为三元发音特征标签。与 PanPhon 不兼容的音段经过人工校正,IPA 音段清单被折叠为不同特征向量,使代表音段数量从 6367 个减少到 3293 个。
-
这些折叠后的代表音段同时作为音素识别和底层特征值识别的目标。
-
对于少样本语言评估,论文作者为五种开发语言整理了可用于 ABX 测试的数据集:斯瓦希里语、泰米尔语、泰语、土耳其语和乌克兰语。每种语言包含三个划分:10 小时训练集、验证集和测试集。
-
对于 Zero Resource Speech Challenge 2017 的测试语言,即英语、法语、普通话、德语和沃洛夫语,论文作者从原始语料库中提取最多 10 小时的训练和验证划分。原始测试子集保持现有长度,即 1 秒、10 秒和 120 秒,以评估上下文长度影响。
-
另外,使用英语和法语的高质量口语对话构建了另一个可用于 ABX 测试的数据集,并采用与开发语言数据集相同的三划分结构。
方法
论文提出 MAUBERT,这是一种面向从原始音频识别发音特征和音素的多语言语音模型。该方法将自监督语音编码器的持续预训练与监督特征识别或音素识别相结合,然后通过伪标注和掩码语言建模对新语言进行自监督适配。参见框架图。
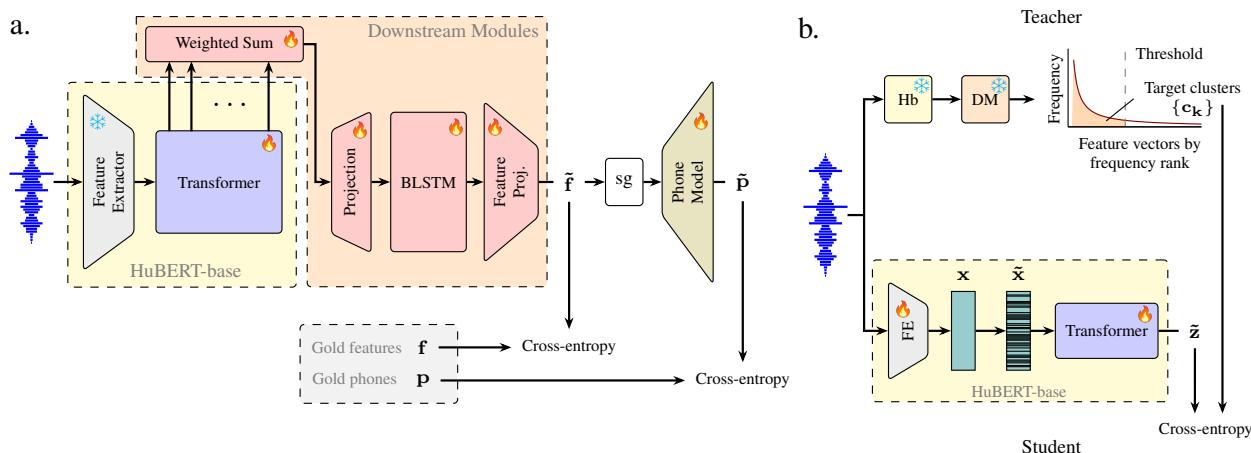
编码器主干从 HuBERT-base 初始化。卷积特征提取器保持冻结,而 Transformer 编码器在多语言持续预训练期间保持可训练。此阶段禁用输入掩码,采用下游语音处理中使用的配置。模型接收特征提取器经过层归一化和 dropout 后的输出,以及十二个 Transformer 编码器层各自产生的隐藏状态。引入多层级表征旨在提供互补信息,因为不同 Transformer 深度可能编码不同的声学和语言规律。
在编码器之上,论文作者使用下游模块而不是单个线性分类头。编码器中间表征先通过可学习加权和进行组合。该加权表征再向上投影到 1024 维空间,并经过一个双向两层 LSTM。双向 LSTM 使系统能够获取左侧和右侧的上下文信息。前向和后向 LSTM 状态被拼接,再向下投影到目标输出空间。对于发音特征识别,该输出空间维度为 22;对于直接音素识别,其维度为 3293。
基于该架构构建了两个模型变体。MAUBERT-FEAT 使用发音特征瓶颈,网络先预测发音特征的紧凑表征。MAUBERT-PHONE 跳过中间特征层并直接预测音素。基于特征的变体源于一个假设:具有语言结构的表征可能在不同语言之间迁移得更好。由于从发音特征到音素的映射不是单射,MAUBERT-FEAT 还包含一个音素模型。该音素模型实现为两层感知器,并与特征预测器联合训练。为确保主表征主要由发音特征目标塑造,使用 stop-gradient 算子阻止音素识别损失反向传播到特征隐藏状态。
训练在帧级执行。对于 MAUBERT-FEAT,发音特征识别目标使用二元交叉熵,因为发音特征以三元值表示。对于音素识别,目标使用覆盖音素清单的多类交叉熵。模型使用 Adam 和分阶段学习率调度进行优化。由于训练数据是多语言的,论文作者在监督预训练期间还使用语言上采样来平衡低资源语言和高资源语言的贡献。
自监督适配阶段面向标注数据有限或没有标注数据的语言。该阶段采用教师-学生框架。教师网络是预训练的 MAUBERT 模型,为目标语言语音产生表征。这些表征在离线阶段进行聚类以创建伪标签。少量目标语言帧被掩码,基于 HuBERT 编码器的学生网络被训练来预测被掩码位置的簇身份。该掩码预测目标使模型能够在不需要转写、音素标注或特征标注的情况下适配新的声学模式。
伪标签生成可以使用不同来源。一种选择是 K-means 聚类,将其应用于从 Transformer 编码器或下游模块提取的表征。聚类使用 K=100 个簇,产生形式为 {ck}k=1K 的目标簇标签。对于 MAUBERT-FEAT,另一种选择是使用高频发音特征向量,即选择模型产生的最常见特征表征。对于两个 MAUBERT 变体,伪标签还可以来自目标数据上预测的高频音素,或者来自多语言预训练期间得到的音素清单。这些变体让适配过程能够在连续聚类学习表征和来自离散音素或发音特征的监督之间进行选择。
实验
实验使用多语言音素识别指标和 ABX 音系不变性测试评估 MAUBERT 模型,并在训练语言、开发语言以及零样本或少样本语言适配设置下比较基于特征和基于音素的变体。结果表明,基于特征的模型更能预测发音特征,而基于音素的模型在音素识别和零样本音系不变性方面表现更强。监督微调,尤其是掩码音素预测,带来最大提升;使用音素频率聚类的自监督微调也提高了跨语言和跨说话风格的鲁棒性;频率阈值方法则有助于在音素清单发现中平衡精确率和召回率。
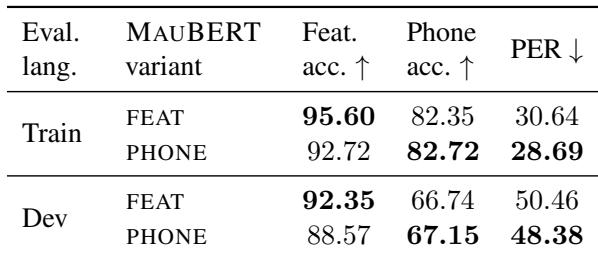
MAUBERT 在训练语言上的表现优于在开发语言上的表现,其中音素识别指标的下降幅度大于特征准确率。基于特征的变体在发音特征预测方面更强,但基于音素的变体在音素识别性能上略优。在迁移到未见开发语言时,音素准确率和音素错误率的下降幅度大于特征准确率。基于音素的变体在音素准确率上具有较小优势,在音素错误率上具有更大优势。
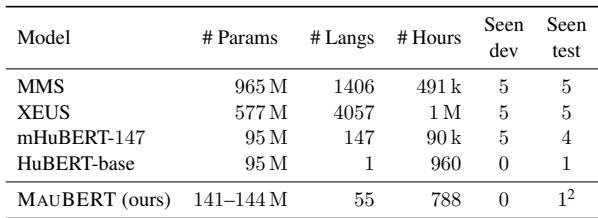
MAUBERT 位于紧凑单语言语音模型和超大多语言基线模型之间,使用中等模型规模,并且训练小时数远少于大规模多语言系统。它还在训练过程中不接触开发语言,因此适合对新语言进行零样本适配。这一对比支持了一个发现:有效的语言适配可以依赖有针对性的模型设计,而不是极端多语言规模。与规模更大的多语言语音模型相比,MAUBERT 用中等参数量提供了较广的语言覆盖。它使用的训练数据远少于 MMS 和 XEUS,但仍针对多种评估语言。与多语言基线不同,MAUBERT 在训练期间不接触开发语言,这强化了其零样本声明。其中等多语言规模也有助于保持与单语言基线的公平比较,同时仍提供多语言能力。
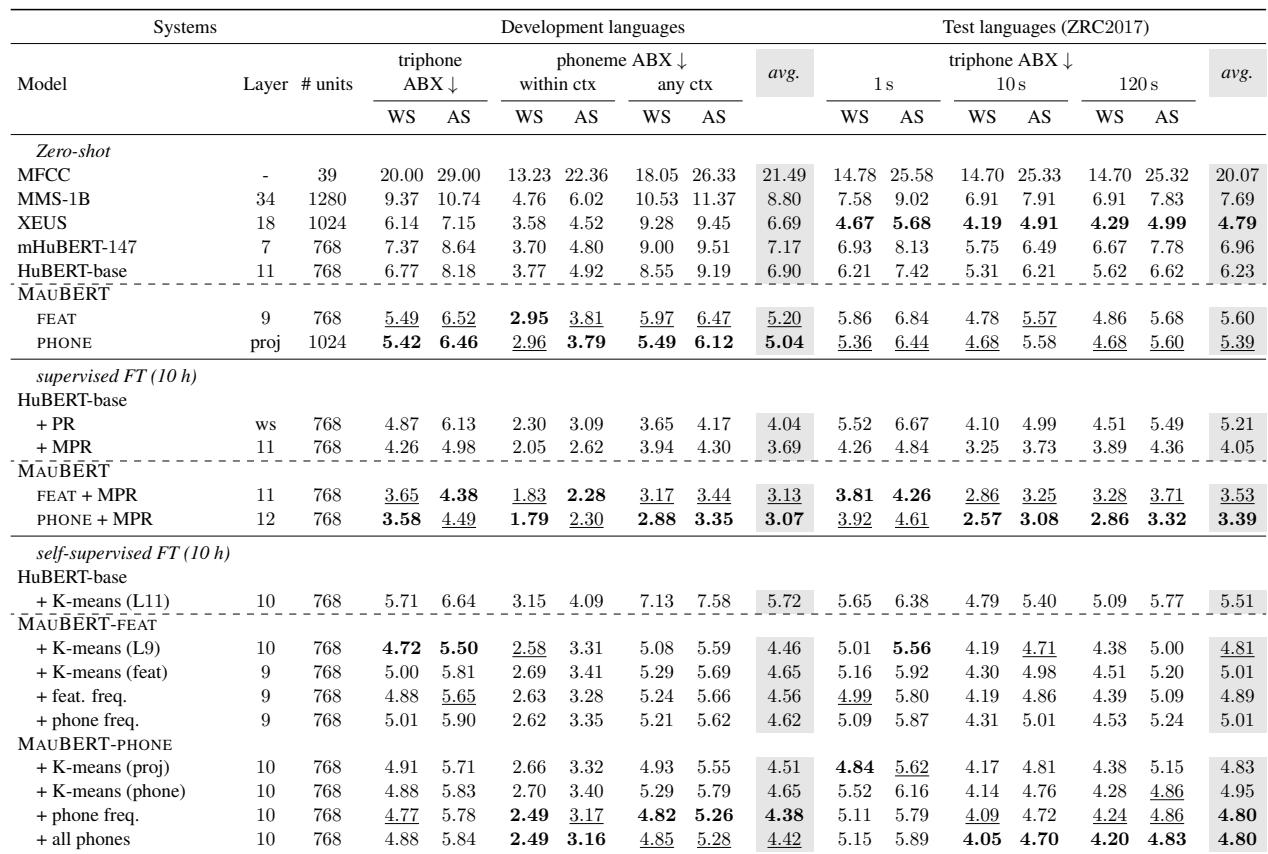
更低的 ABX 分数表示更强的声学判别性。零样本比较表明,多语言自监督模型远比 MFCC 基线更有效。在可比较条件下,开发语言往往产生高于测试语言的错误分数,这表明某些语系在跨语言音位判别上更难。监督微调进一步降低 ABX 错误率,其中掩码输入音素预测为三音位判别带来尤其大的提升。XEUS 在开发语言和测试语言上的零样本平均 ABX 分数优于 MMS-1B 和 mHuBERT-147。开发语言的 ABX 分数通常高于测试语言分数,表明这些判别任务更难。相对于零样本设置,监督微调降低了 ABX 错误率,且掩码输入预测被认为尤其有效。
英语和法语不同语域中的三音位 ABX 错误率显示出朗读语音和自发语音之间的明显差距,自发语音更难。在列出的零样本系统中,XEUS 总体错误率最低,而 MAUBERT-FEAT 也具有竞争力,在朗读语音中尤其明显。结果显示,自监督微调可以改善适配,并有助于恢复自发语音上的性能。自发语音导致比朗读语音更高的三音位 ABX 错误率。XEUS 在基线中最强,MAUBERT-FEAT 在朗读条件下仍具有竞争力。
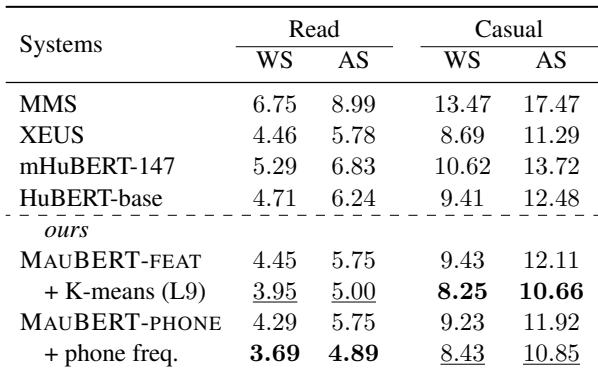
实验在训练语言和未见开发语言上评估 MAUBERT,结果显示音素识别的退化大于发音特征预测;基于音素和基于特征的变体分别在音素识别和特征预测上表现更好。这些模型在紧凑的零样本设置下与单语言基线和大多语言基线进行比较,支持这样一个观点:高效模型设计而非极端多语言规模可以实现有效的跨语言适配。ABX 结果进一步表明,多语言自监督模型大幅优于 MFCC 基线,开发语言通常比测试语言更难,且监督微调,尤其是掩码输入音素预测,能够提高判别性。对英语和法语语域的补充分析发现,自发语音比朗读语音更难,而 MAUBERT-FEAT 整体上仍具有竞争力。