Command Palette
Search for a command to run...
超越最终作者:建模创作者与编辑者的双重角色以实现细粒度大语言模型生成文本检测
超越最终作者:建模创作者与编辑者的双重角色以实现细粒度大语言模型生成文本检测
Yang Li Qiang Sheng Zhengjia Wang Yehan Yang Danding Wang Juan Cao
摘要
大语言模型(LLM)的滥用要求对合成文本进行精确检测。现有工作主要遵循二元或三元分类设置,最多只能区分纯人类/LLM 文本或协作文本。这对于细致的监管仍然不足,因为经过 LLM 润色的人类文本和经过人类化的 LLM 文本往往触发不同的政策后果。在本文中,我们探讨了在严格的四类设置下的细粒度 LLM 生成文本检测。为了处理这种复杂性,我们提出了 RACE(用于创作者-编辑者建模的修辞分析),一种细粒度检测方法,该方法刻画了创作者和编辑者的不同特征。具体来说,RACE 利用修辞结构理论(RST)为创作者的基础构建逻辑图,同时提取基本话语单元(EDU)级别的特征以捕捉编辑者的风格。实验表明,RACE 在识别细粒度类型方面优于 12 个基线,且误报率低,为 LLM 监管提供了一种与政策对齐的解决方案。
一句话总结
中国科学院计算技术研究所和中国科学院大学的研究人员提出了RACE,一种细粒度检测方法,利用修辞结构理论通过篇章级逻辑图和EDU级特征对创作者和编辑者角色进行建模,在四类LLM生成文本检测中优于12个基线方法,同时为政策对齐的监管提供低误报率。
核心贡献
- 论文引入了一种四类细粒度检测设定,区分人类撰写的文本、LLM生成的文本、LLM润色的人类文本和人工化LLM文本,超越了无法满足精细化政策监管需求的二分类和三分类设定。
- 论文提出了RACE,一种通过构建修辞结构理论(RST)逻辑图来分别对创作者和编辑者角色进行建模的检测器,捕获创作者的逻辑组织,并提取基本话语单元(EDU)级特征来刻画编辑者的风格,随后在生成的逻辑感知图上进行修辞引导的消息传递。
- 在HART基准上的结果表明,RACE在细粒度四类识别任务中优于12个基线方法,同时保持低误报率,为LLM生成文本监管提供了政策对齐的解决方案。
引言
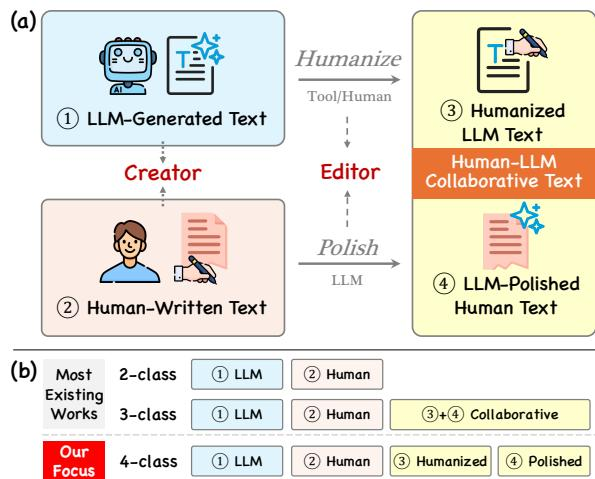
大规模语言模型(LLM)的爆炸式增长改变了内容创作,但同时也通过使大规模虚假信息、未经授权的学术帮助和身份欺诈成为可能而侵蚀了信任。因此,检测LLM生成的文本对于维护信息可信度至关重要。然而,早期的检测器将这一问题框定为二分类任务,即人类或LLM,这无法捕捉现实世界中的协作场景。人们经常要求LLM润色其草稿,或者反过来,将LLM输出人工化以规避检测,产生模糊传统边界的混合文本。先前的工作转向细粒度设定,通常增加一个第三类混合类别,但即使是这种三分类划分也不足以满足精细化的监管政策需求,特别是在学术写作中,文本润色被视为合法帮助,而通过人工化来绕过检测则是被禁止的。
在此背景下,作者研究了一个实际重要的四类检测设定,将混合类别分为LLM润色的人类文本和人工化LLM文本。他们通过创作者和编辑者的双重视角分析这些类别:创作者建立底层逻辑结构和论证流程,而编辑者塑造语言表达和表层风格。对于纯人类或纯LLM文本,这些角色无法区分,但两个混合类别表现出不同的创作者-编辑者协作模式,因此分别对角色进行建模至关重要。为解决这一问题,作者提出了RACE(用于创作者-编辑者建模的修辞分析),将文本分割为基本话语单元(EDU)以捕捉编辑者的表层细化,并利用修辞结构理论(RST)构建基于EDU的逻辑关系图,对创作者的基础组织进行建模。随后,修辞引导的消息传递机制在该图上传播信息以捕捉复杂的修辞依赖关系。作者为四类设定贡献了一个任务特定的框架,一种基于RST的创作者-编辑者建模方法,以及大量实验证明RACE以低误报率优于基线方法。
数据集
数据集概览
-
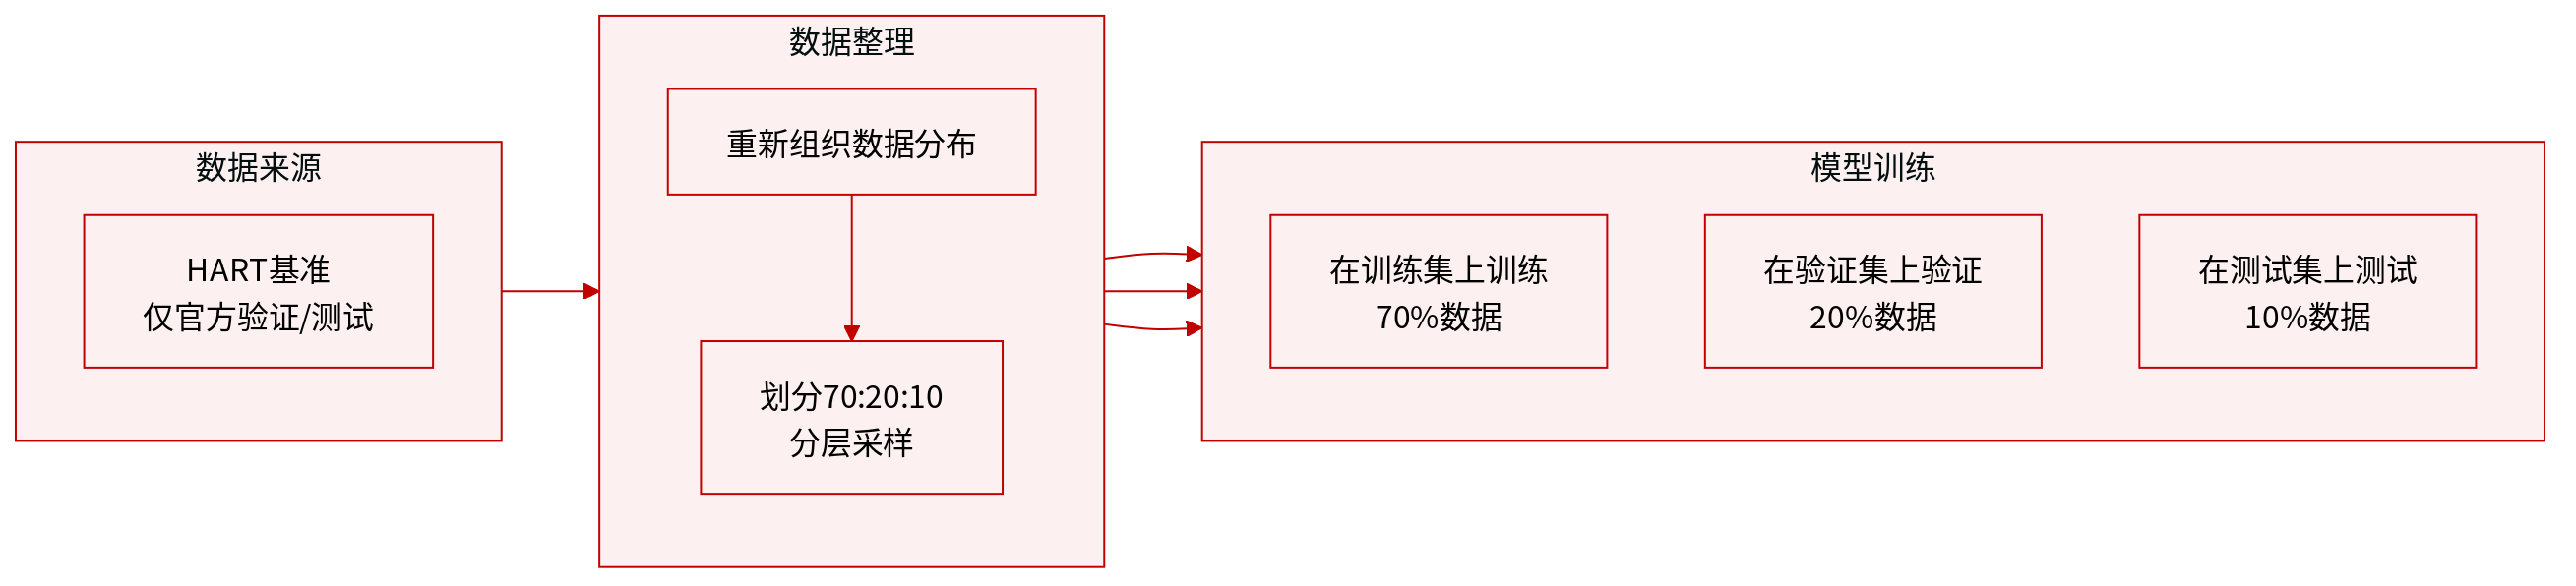
来源与构成:作者使用HART基准作为评估数据集,选择原因是其覆盖了所需的细粒度类别(News、Writing、ArXiv和Essay)。官方发布仅包含验证集和测试集划分,因此作者重新组织了数据分布以实现监督学习。
-
训练/验证/测试划分:重新组织的数据按70:20:10的比例使用跨多样领域的分层抽样进行划分。这确保了所有划分之间的分布一致性。
-
分组感知划分:除标准划分外,作者在附录B.2中报告了更严格的分组感知划分,其中源自同一基础文本的所有变体被分配到同一划分中。这防止了数据泄漏并测试了对未见基础文本的泛化能力。
-
任务设定:数据支持4类细粒度检测任务。由于该设定不存在任务特定的方法,作者改编了12种原本为二类或三类设定设计的学习型或指标型方法。
-
学习型基线:包括RoBERTa、RoBERTa-DANN、CoCo、DeTeCtive和LF-Motifs。分类头从2个输出扩展为4个输出。CoCo和LF-Motifs融合了篇章信息,而DeTeCtive使用与作者方法类似的对比学习。
-
指标型基线:包括Binoculars、Fast-DetectGPT和TDT。这些方法产生标量预测,因此作者提取最后一层表示并附加可学习的MLP以实现四类预测。
-
评估指标:作者优先考虑评估全局排序能力而非硬预测的指标。他们使用宏平均AUROC,该指标衡量从任意类别中随机选择的正样本排名高于随机选择的负样本的概率,以及TPR@1% FPR,该指标需要精确判断同时避免误报。
-
RACE的实现细节:模型使用RoBERTa-base作为骨干网络,仅微调最后一层而冻结前面的层。提取的特征被投影到128维以初始化节点特征。图组件是2层的RGCN,隐藏维度为512,使用10个基进行参数正则化。监督对比损失的温度设置为0.07。选择最佳验证检查点进行测试,所有实验在单个NVIDIA RTX 4090 GPU上运行。
方法
作者提出了一个逻辑结构感知的检测框架,旨在捕捉创作者和编辑者的双重痕迹。初步分析表明,不同来源之间的修辞结构存在显著差异;如分布图所示,人类创作者在Attribution和Temporal等关系中表现出过度表达,而LLM更依赖于Elaboration和Cause。这些结构特征即使在编辑后仍然存在,这激发了使用修辞图进行检测的动机。
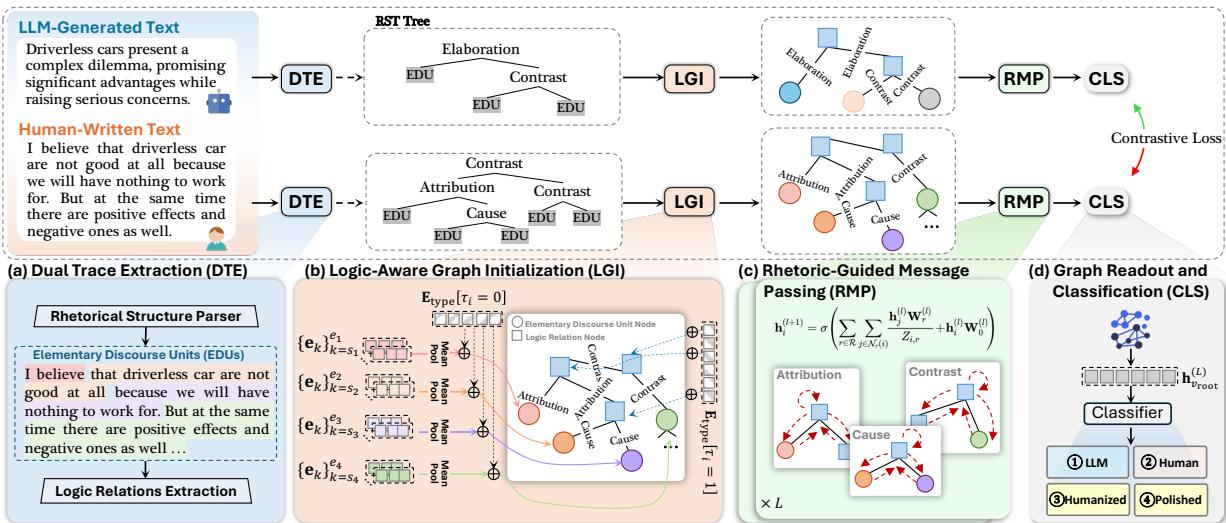
整体架构如框架图所示,由四个关键组件组成:双重痕迹提取、逻辑感知图初始化、修辞引导的消息传递以及图读出与分类。
首先,双重痕迹提取模块使用端到端的RST解析器将非结构化文本转换为层次化表示。该过程生成一个二元组成树,其中叶节点对应基本话语单元(EDU),内部节点表示逻辑关系(例如Contrast、Cause)。该树作为后续图构建的骨架。
接下来,逻辑感知图初始化模块将该树形式化为多关系图G=(V,E,R)。节点特征使用混合策略初始化。最初,"后代节点跨度池化"计算内容表示:EDU节点通过对token嵌入进行均值池化初始化,而关系节点通过对其后代节点的嵌入进行平均初始化。随后,"信息瓶颈投影"通过线性层将这些嵌入投影到紧凑的结构空间中,并附加可学习的类型嵌入,从而过滤表层噪声。
然后,修辞引导的消息传递模块采用L层关系图卷积网络(RGCN)。与普通GCN不同,该模块分配关系特定的变换矩阵,使模型能够为不同的修辞逻辑学习不同的传播规则。节点表示通过基于特定关系类型聚合邻居信息来更新。为防止参数爆炸和过拟合,作者应用基分解,通过将关系特定矩阵表示为共享基矩阵和可学习标量系数的线性组合来约束权重空间。
最后,图读出与分类模块通过池化根节点的隐藏状态来提取全局文本表示。该向量经过由dropout、线性层和softmax函数组成的分类头。模型使用联合损失函数进行优化,该函数结合了监督对比损失和交叉熵损失,鼓励学习紧凑且有判别力的表示空间。
实验
实验在重新组织的HART基准上进行,采用70:20:10的训练/验证/测试划分(包括更严格的分组感知划分),通过宏AUROC和TPR@1%FPR评估与改编基线相比的性能。主要结果表明,RACE在TPR@1%FPR上优于所有基线,特别是以3.36%的绝对差距超过了最佳篇章感知方法CoCo,并且学习型方法总体上优于指标型方法。消融实验确认了关系图建模、对比学习、基分解和信息瓶颈投影的必要性,其中LLM生成类和润色类的下降最大,进一步分析表明RACE具有更好的特征判别性、对短文本的处理能力更强以及更强的分布外鲁棒性。
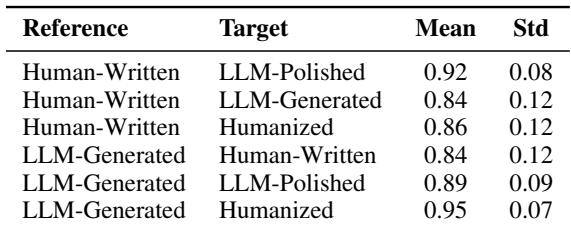
修辞关系频率向量之间的样本级余弦相似度表明,无论后续编辑如何,文本与其来源保持高度相似,平均值约为0.84至0.95,标准差较小。这表明原始创作者的基础修辞结构在润色或人工化过程中得以保留,支持创作者和编辑者角色不同的观点。由同一创作者生成的文本在编辑后修辞上保持接近,所有配对的平均相似度均高于0.84。LLM生成文本与人工化文本之间的相似度最高,为0.95,而人类撰写的文本与LLM生成文本的配对相似度最低,为0.84。所有配对的较小标准差表明修辞特征在编辑操作中保持一致。
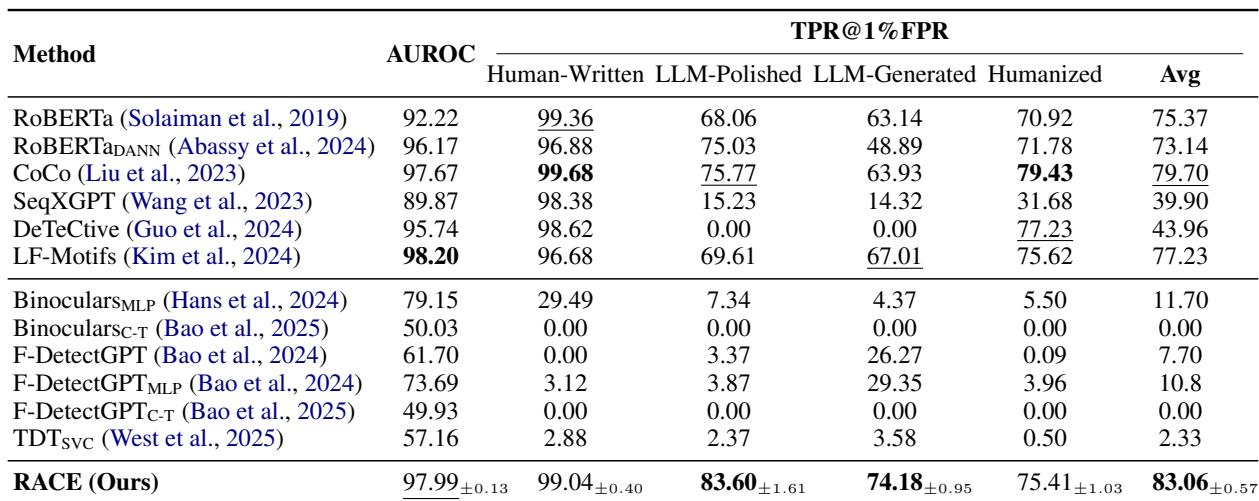
RACE在4类设定下实现了比较方法中最高的平均TPR@1%FPR,以3.36%的绝对差距超过了最佳基线CoCo。学习型方法总体上优于指标型方法,一些指标型检测器在低误报率下表现出接近零的TPR。RACE在所有四个文本类别上也表现出强劲性能,特别是在人工化类别上。RACE以超过最佳基线CoCo 3.36%的差距引领平均TPR@1%FPR。学习型检测器优于指标型检测器,因为指标型方法经常崩溃多类任务所需的特征空间。RACE实现了最佳的平均AUROC(98.20)和最高的人工化文本TPR@1%FPR,表明其具有稳健的细粒度检测能力。同为篇章感知方法的CoCo和LF-Motifs落后于RACE,后者使用关系图消息传递来捕捉结构异常。
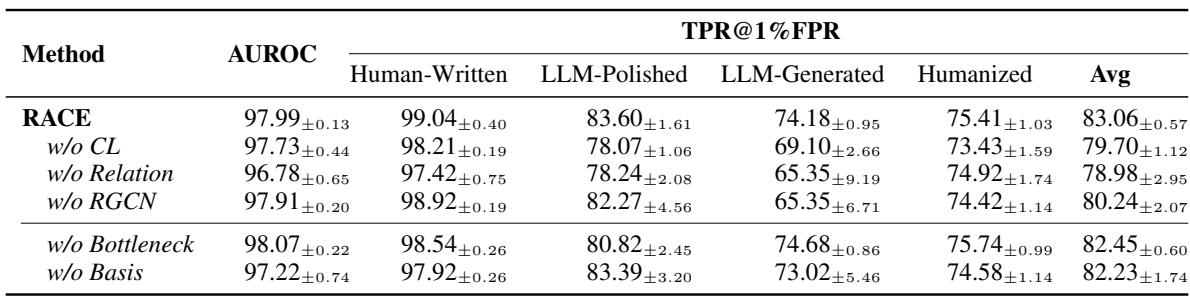
消融研究表明,RACE的每个组件都对细粒度检测性能有所贡献,其中当移除组件时,LLM生成类和LLM润色类的性能退化最为显著。关系建模和对比学习组件对于区分创作者-编辑者模式至关重要,而瓶颈和基分解为特定类别提供有针对性的益处和稳定性。移除任何组件都会降低平均检测性能,其中LLM生成类和LLM润色类的下降最大。w/o Relation变体表现出严重的性能退化和高方差,表明逻辑关系对于捕捉创作者-编辑者角色至关重要。移除信息瓶颈特别损害了LLM润色检测,表明它有助于避免过拟合表层编辑模式。移除基分解增加了性能方差,突显了其通过权重共享作为正则化器的作用。
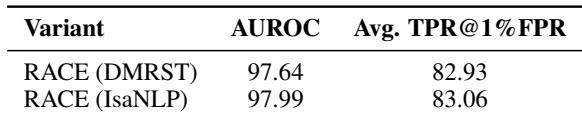
解析器鲁棒性分析表明,当底层RST解析器被替换时,RACE保持一致的性能,DMRST和IsaNLP产生几乎相同的AUROC和平均TPR值。这种稳定性表明模型的增益来自其创作者-编辑者建模而非解析器特定的伪影。使用DMRST的RACE实现了97.64的AUROC和82.93的平均TPR@1%FPR,而使用IsaNLP的RACE分别达到了97.99和83.06。跨解析器的最小性能差异确认了RACE的鲁棒性独立于所选的RST解析器,强调了其核心建模方法的重要性。
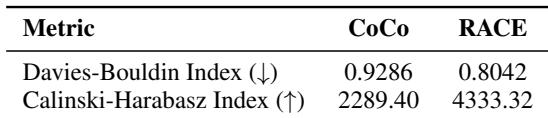
RACE实现了比CoCo更好的特征判别性,表现为更低的Davies-Bouldin指数和显著更高的Calinski-Harabasz指数。改进的嵌入空间可能源于对创作者和编辑者逻辑的显式建模,导致更紧凑和更独特的聚类。RACE在较短文本上也表现出更强的性能,其基于图的方法更有效地捕捉细微差异。RACE将Davies-Bouldin指数从0.9286降低到0.8042,表明相对于类间分离更好的类内紧密度。RACE的Calinski-Harabasz指数几乎是CoCo的两倍,反映了显著更独特的嵌入空间。对于200到600个token之间的文本,RACE优于CoCo,表明其基于图的建模在有限信息下更高效。
实验表明,修辞结构在编辑后与来源保持高度相似,支持创作者和编辑者角色不同的观点,RACE通过关系图消息传递在细粒度检测中优于基线方法。消融和解析器鲁棒性测试表明每个组件都有贡献,特别是关系建模和对比学习,而性能在不同RST解析器下保持稳定。RACE还产生了比CoCo更具判别性的嵌入,并且在较短文本上明显更强,表明其有效捕捉结构异常。