Command Palette
Search for a command to run...
CIG:基于语义记忆动态衡量审议式对话中的会话信息增益
CIG:基于语义记忆动态衡量审议式对话中的会话信息增益
Ming-Bin Chen Jey Han Lau Lea Frermann
摘要
衡量公共审议质量不仅需要评估礼貌程度或论证结构,还需要评估对话的信息推进程度。我们提出了会话信息增益(CIG)框架,从每条话语如何推进对目标话题的集体理解这一角度对其进行评估。为了将 CIG 操作化,我们对讨论的演化语义记忆进行建模:系统从话语中提取原子性断言,并将其增量式地整合为结构化记忆状态。基于该记忆,我们从新颖性、相关性和蕴含范围三个可解释维度对每条话语进行评分。我们在两个有主持人的审议场景(电视辩论和社区讨论)中选取 80 个片段,按上述维度进行标注,结果表明,源自记忆动态的指标(如断言更新次数)与人类感知的 CIG 的相关性显著高于话语长度或 TF–IDF 等传统启发式方法。我们开发了基于大语言模型的 CIG 预测器,为面向信息维度的对话质量分析和审议成效评估奠定了基础。
一句话总结
墨尔本大学提出了对话信息增益(Conversational Information Gain, CIG),该框架将原子性论断抽取到一个持续演化的语义记忆中,并从新奇性、相关性和蕴含范围三个维度对每句话语进行评分。结果表明,在协商式对话中,源自记忆的动态信号与人类感知信息增益的相关性强于 TF-IDF 等传统启发式方法。
核心贡献
-
该论文提出对话信息增益,一种用于评估每句话语如何推动协商中集体理解的框架。该框架通过持续演化的语义记忆加以落实:由 LLM 抽取原子性论断,并由 NLI 引导的整合过程更新记忆,再按新奇性、相关性和蕴含范围进行评分。
-
该论文提供了针对 INSQ 辩论和 FORA 社区讨论中 80 个片段的标注研究,证明 CIG 评分具有中到高的可靠性;同时显示,记忆派生信号(例如论断更新次数)比长度或 TF-IDF 启发式方法更能反映人类感知的信息性。
-
该论文给出了基于 LLM 的 CIG 预测器,其中 GPT-5 在匹配信息条件下能够复现汇总层面的人工判断,并提供了诊断性的调节效应分析:INSQ 辩论会出现即时信息跃升,而 FORA 社区讨论则表现出跨轮次的逐步累积。
引言
社区论坛、主持人引导的讨论和辩论中的公共协商之所以重要,是因为民主决策依赖推动参与者形成共享理解的交流。先前的评估方法往往关注结构性正式性、礼貌程度或浅层论辩特征,但这些表层信号可能奖励礼貌或官僚式话语,同时遗漏实质性进展。作者提出对话信息增益,该指标衡量每句话语在多大程度上推动共享知识状态,并将其分解为新奇性、相关性和蕴含范围。作者通过由整合论断构成的轻量级语义记忆来落实这一概念,并表明人工标注者和 LLM 都能以合理可靠性评估 CIG,而且基于记忆的信号比常见启发式方法更紧密地追踪感知到的进展。
数据集
-
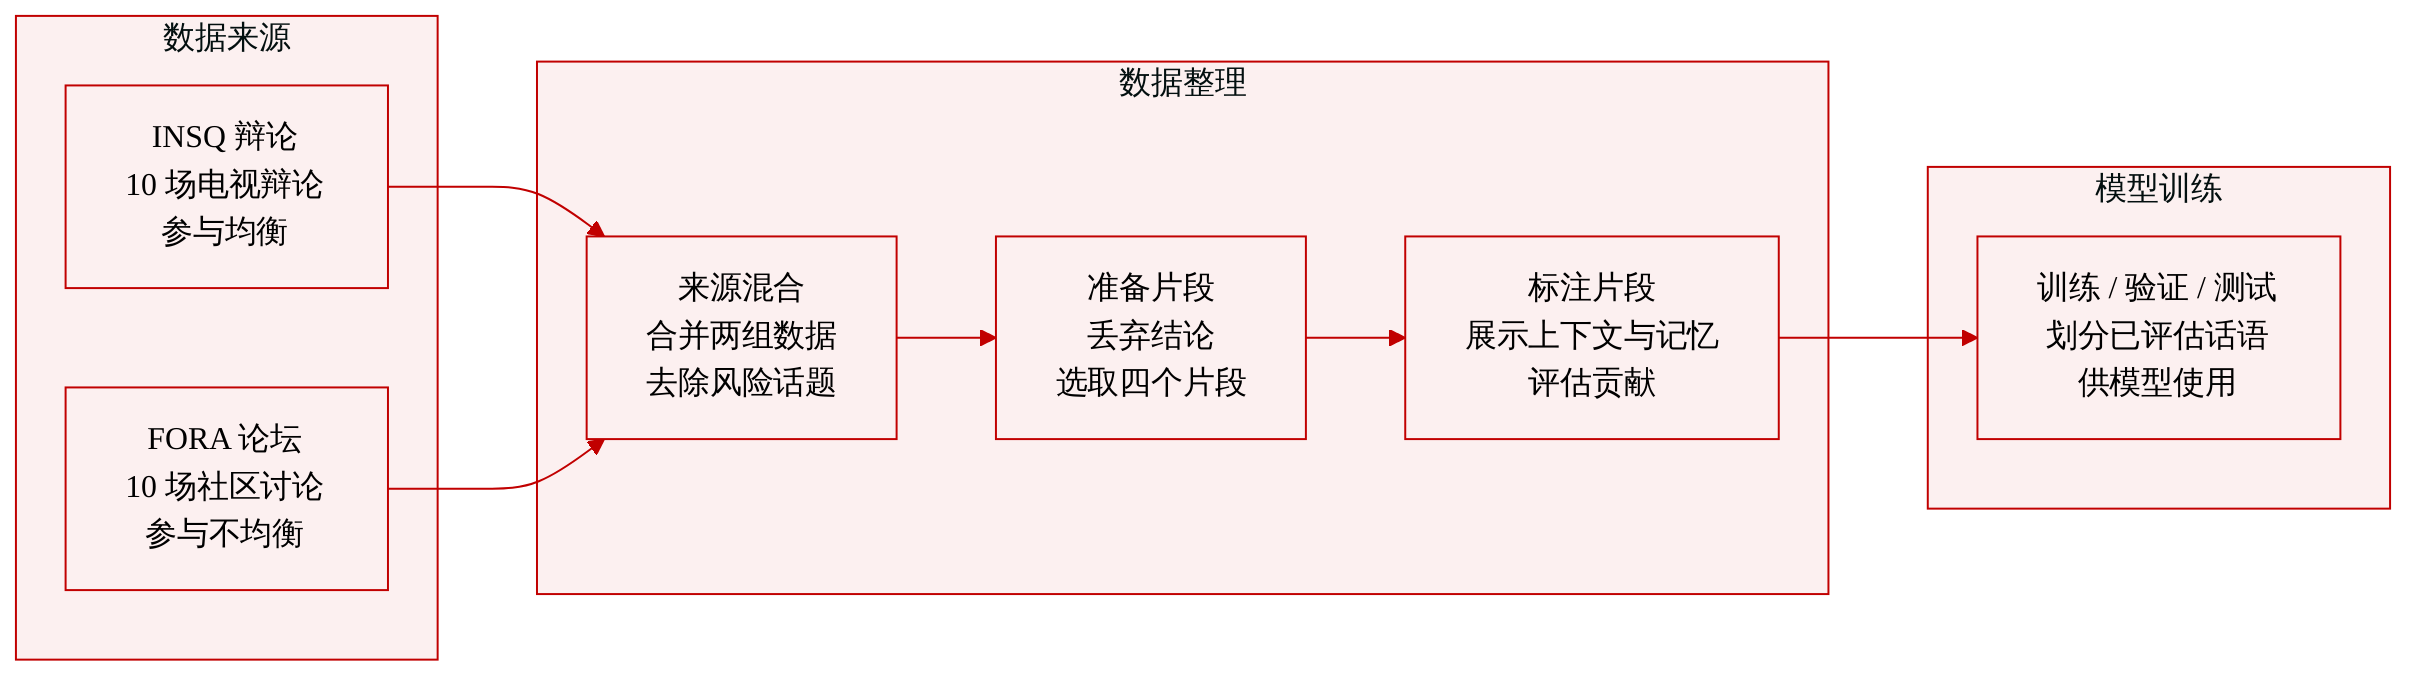
作者使用来自两种协商式讨论场景的带标注转录文本:来自 INTELLIGENCE SQUARED(INSQ)的十场电视辩论,以及来自 FORA 语料库、围绕达勒姆社区未来愿景的十场社区讨论。
-
作者通过排除高度敏感或近期两极分化的主题来人工策划数据集,以减少标注者偏差和潜在危害。
-
两个语料库都包含主持人引导的多人讨论,但意图和参与风格不同。INSQ 辩论是竞技性的、基于动议的事件,领域专家参与,主持更严格;FORA 集会则是协作式头脑风暴会议,主持者通常以同侪身份参与。
-
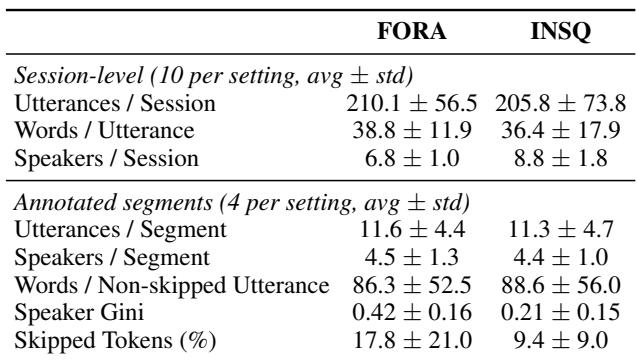
作者使用表 2 的统计结果说明发言者参与差异:INSQ 的发言参与更均衡,由较低的发言者 Gini 值体现;FORA 由于社区讨论风格更自由,参与更不均衡。
-
两个数据集都遵循可比的引言、讨论和结论结构。对于 INSQ,作者使用预定义结构,并只分析讨论阶段。对于 FORA,作者使用 GPT-5 检测阶段边界,然后进行人工核验。
-
结论部分被丢弃,而引言部分用于初始化记忆模块使用的初始知识。
-
每集节目的讨论阶段使用 GPT-5,结合滑动窗口和多数投票,被切分为子主题单元。
-
对于每个片段,作者通过语义相似度检索相关已有记忆,并用 GPT-5 将其摘要化,从而构建先前记忆摘要。该摘要化提示词由一位论文作者使用试点数据开发。
-
为让标注聚焦于实质性的参与者贡献,主持人话语和少于五个词的极短话语会被跳过。这些被跳过话语的占比依场景不同,占 tokens 的 9% 至 18%。
-
从每集节目选出四个片段进行标注。选择过程平衡估计阅读时间、跳过率和切分置信度。
-
标注由 88 位 Prolific 标注员完成,他们均为英语母语者,并至少拥有学士学位。由于与同行一致性持续偏低,有十位标注者被移除。
-
每次任务包含一个教程、一项预筛选测试,以及按时间顺序呈现的来自同一会议的四个抽样片段。
-
作者在同一材料上使用两种标注变体。一种变体按每句话语收集一个 1 到 4 的群体贡献分数。另一种变体分别收集新奇性、相关性和蕴含范围的评分,同样使用 1 到 4 的等级。
-
标注元数据包括讨论主题、由先前记忆构建的长期记忆摘要、作为短期上下文的三句先前话语,以及待评分的目标话语。
-
标注者间一致性在各项设置和标注维度上均为中到高。
方法
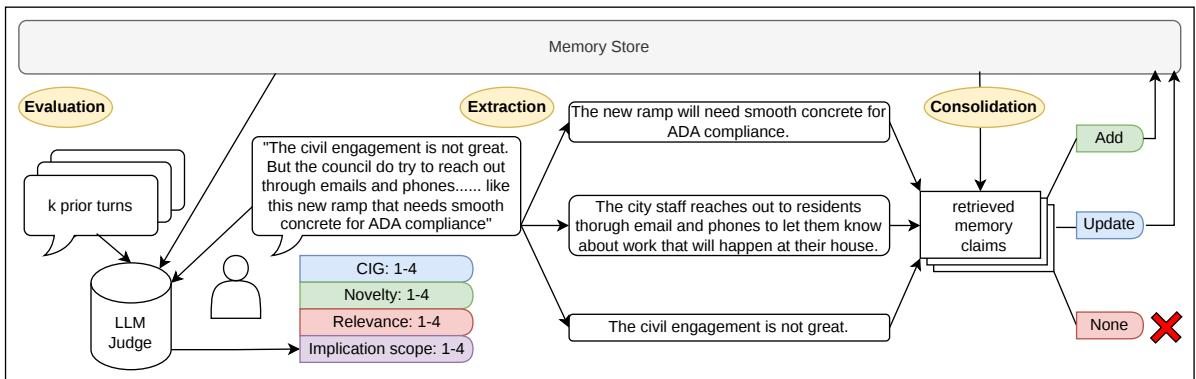
作者通过结合多维度评分量规与增量更新的语义记忆,设计了对话信息增益(CIG)的评估流程。该方法不把对话视为孤立话语序列,而将其视为扩大或缩小群体共享知识的过程。参见框架示意图。
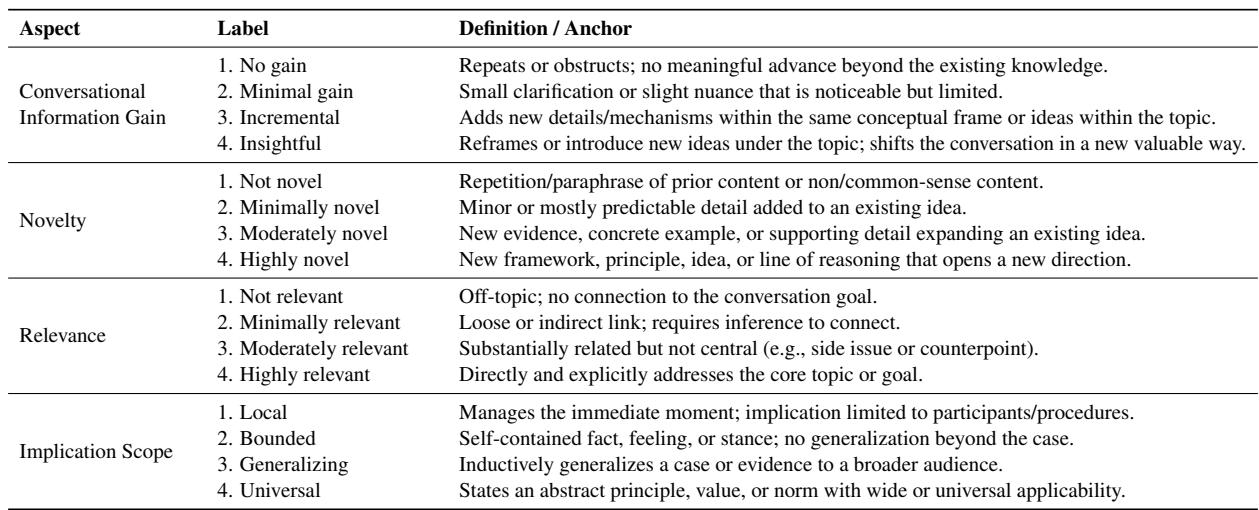
该框架从 CIG 构念本身开始。作者将 CIG 定义为:相对于先前知识和先前对话,一个回应在多大程度上推动群体对主题的理解,或推动讨论朝向目标。为使该构念可测量,作者将其分解为三个维度:新奇性、相关性和蕴含范围。新奇性考察话语是否引入改变或扩展现有概念框架的信息,而不仅仅是与先前话语存在词汇形式差异。相关性考察话语是否与主要主题或目标存在实质联系,包括是否需要桥接推理,或是否指向公认子主题。蕴含范围衡量贡献在多大程度上超出当前发言者、个案或程序性交流。在实践中,局部程序性评论的范围较窄,个案陈述仍绑定于单一情境,归纳泛化将证据提升为更广泛模式,而原则级论断则投射普遍适用性。
所有维度均按四个等级评分。这一设计使方法能够将信息贡献与表层对话质量区分开来。例如,组织下一轮发言之类的简短协调行为可能有助于对话流畅,但不一定提高 CIG,因为它并未扩大群体共享理解。
核心方法论贡献在于使用动态语义记忆来表示对话已经确立的内容。作者通过两个模块维护该记忆:抽取与整合。在抽取阶段,LLM 将每句话语分解为原子性论断。这些论断应写成自包含形式,即抽取器解析指代并消除上下文依赖歧义。复合陈述被拆分为独立命题,而缓和语气和填充内容被规范化,以恢复底层论断内容。例如,间接表达的担忧可转换为后续可与其他论断比较的直接事实命题。同时,记忆保留发言者归属,使系统知道哪个论断由哪一参与者引入。这一点很重要,因为公共协商常常包含并行或冲突框架,这些区分不应被简单的合并步骤抹除。
在整合阶段,系统将新抽取论断与已存储记忆条目比较。令新论断为 A。系统首先使用向量检索,检索前 k 个语义相似的记忆条目 {Bi}i=1k。随后,基于 LLM 的自然语言推理(NLI)判定器双向评估每一对论断,并指定五种关系之一:等价、正向蕴含、反向蕴含、矛盾或中立。该推理层为记忆提供了纯向量检索无法提供的逻辑结构。
记忆更新策略是确定性的。作者将比较限制为由同一发言者产生的论断,使用子集
S(A)={Bi∣speaker(Bi)=speaker(A)}.分配给新论断的动作是
α(A)∈{ADD,UPDATE,NONE}.如果 S(A) 为空,或仅包含中立关系,则动作为 ADD,该论断作为新的记忆条目插入。这允许记忆保留并行框架和发言者间分歧。如果 S(A) 非空,则等价或反向蕴含触发 NONE,意味着现有记忆已经捕获该信息。矛盾或正向蕴含触发 UPDATE,并对最相似的先前论断 B⋆ 执行更新,其中
B⋆=argB∈S(A)maxsin(A,B).矛盾会替换过时论断,而正向蕴含将先前论断与新论断合并为更具体的整合表示。该设计使记忆在语义上更紧凑,同时对发言者更敏感。
在评分阶段,LLM 判定器不会从零开始评估话语。相反,它会接收由语义记忆构建的紧凑先前上下文。在预处理期间,讨论阶段被切分为子主题单元,引言用于初始化背景知识,检索到的记忆条目被摘要为先前记忆摘要。评估目标片段时,模型接收主题、最近话语的短窗口、基于记忆的先前摘要和示例演示。模型随后输出 CIG 和各维度评分。这种匹配上下文设置是该方法的核心:模型需要针对与人工标注者相同的演化知识状态进行推理,并判断什么才算新信息、相关信息或具有公共后果性的信息。
作者还将这种基于记忆的表示与替代先前上下文进行比较。提供完整先前转录文本或逐字检索记忆条目时,预测结果接近基于摘要记忆的结果;而只提供最后几句话语或不提供先前上下文时,偏差更大。这表明记忆摘要不只是压缩产物;它保留了判断对话信息增益最相关的信息。
最终阶段将论断级分析连接到话语级印象。论断抽取后,模型可为每个论断分配新奇性、相关性和蕴含范围分数。这些论断级分数随后被聚合,以预测完整话语的 CIG。作者测试多种聚合算子,发现最稳健的预测来自先对少量显著论断进行选择性池化,再在维度间进行合取组合。这一模式意味着,话语不会仅因包含许多普通论断而被判断为有信息量。相反,感知到的信息性似乎取决于少数强论断,同时要求任何必要维度都不能出现严重弱点。
实验
实验评估所提出的 CIG 维度、自动预测和启发式记忆信号能否解释并估计感知到的信息性,使用有序模型、GPT-5 标注、相关性分析和论断级聚合测试。结果显示,新奇性和相关性解释了人类 CIG 判断的大部分变异,而蕴含范围贡献较小;当给定可比先前上下文时,GPT-5 能够复现汇总层面的人工评分,并且源自记忆的动态信号和摘要可作为强且忠实的代理。围绕主持人动态的案例研究进一步表明,CIG 能够揭示互动风格如何塑造信息增益:在对抗性场景中产生即时峰值,在协作讨论中产生更分散的增益。
评分量规将对话信息增益定义为一个贡献推动群体共享理解的程度,并使用先前知识和先前对话作为上下文。它区分低价值重复、最小澄清、现有框架内的渐进阐释,以及改变讨论方向的洞见性重构。相关评估语境表明,CIG 可以在大规模条件下进行标注和近似,基于记忆的信号与人类判断高度一致,模型估计也接近人类共识。CIG 关注信息推进,而不是一般对话质量;较高等级区分了增加细节与引入新框架;新奇性独立于主题相关性和影响大小进行评定;基于记忆的上下文有助于生成接近人工评分的 CIG 估计。
带标注的 FORA 和 INSQ 会议在对话规模上大体相似,包括每次会议的话语数、每句话语的词数,以及片段级话语数。INSQ 会议平均包含更多发言者,反映更多方的辩论格式,而两种设置中各四个标注片段的发言者数量相似。片段级参与指标排除了被跳过的主持人话语和极短片段,这些内容占用了明显但有限比例的 tokens。两种设置的话语数和片段长度大体可比。INSQ 会议的发言者数量高于 FORA 会议,而片段级发言者数量仍相似。主持人话语和短句片段被排除在片段级参与指标之外,并占据非轻微的 token 份额。
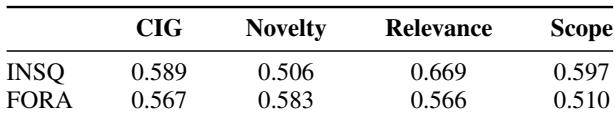
对整体信息性的一致性为中到高,并在各语料库之间大体可比,但三个维度评分呈现更不均衡的模式。在一个语料库中,相关性是最稳定被判断的维度,而新奇性相对不够稳定;在另一个语料库中,新奇性达到最高一致性,而蕴含范围最低。这表明整体感知信息性的评分较一致,但其组成维度更依赖具体场景。整体 CIG 一致性在两个语料库之间大体相似。维度一致性存在差异:在一个场景中相关性高度一致,在另一个场景中蕴含范围一致性最弱。
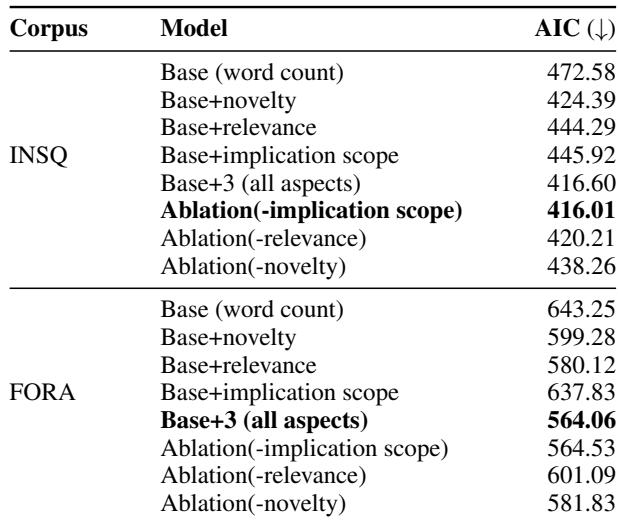
有序回归模型比较显示,仅凭话语长度预测感知 CIG 的效果,不如采用所提出的语义维度。添加新奇性带来最强单一维度增益,相关性也改善拟合,而蕴含范围只提供有限且不稳定的收益。在两个语料库中,不包含蕴含范围的模型具有竞争力或更好,表明信息性并非简单地由更广泛的公共覆盖面驱动。仅使用词数时的拟合较差,而添加语义维度后模型效果改善。新奇性是最有用的单个维度,相关性也改善拟合。蕴含范围并非必需,并且在一个语料库中可能降低预测性能。
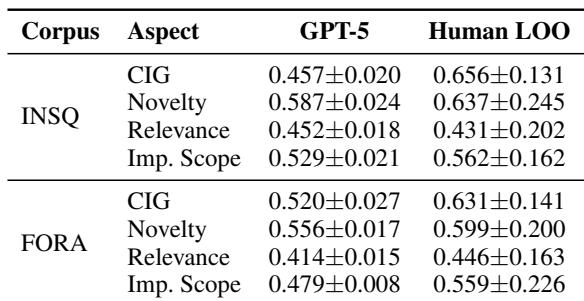
在两个语料库中,当 CIG 预测仅使用基于记忆的先前摘要时,GPT-5 仍可与人工留一基线相媲美。在多个评分类别中,GPT-5 与人类共识的偏差等于或低于个体人类标注者,这表明摘要捕获了人工标注者使用的很多信息。在两个语料库中,GPT-5 都与人类共识在整体 CIG 上高度一致。对于整体 CIG 和新奇性,GPT-5 的误差低于人工留一基线。仅凭记忆摘要即可作为 CIG 评分所依赖上下文的紧凑近似。
实验使用带标注的 FORA 和 INSQ 对话评估对话信息增益,考察先前对话上下文能否支持可靠评分和可扩展估计。结果显示,整体信息性在两个语料库中得到一致判断,尽管对新奇性、相关性和蕴含范围的评分更依赖场景。模型比较进一步表明,语义维度,尤其是新奇性和相关性,比话语长度更能解释感知 CIG;仅使用基于记忆摘要的 GPT-5 模型达到接近人类的评分一致性,尤其在整体 CIG 和新奇性上。