Command Palette
Search for a command to run...
CxMP:用于评估语言模型构式理解的语言学最小对立对基准
CxMP:用于评估语言模型构式理解的语言学最小对立对基准
Miyu Oba Saku Sugawara
摘要
理解语言模型中的语言习得机制仍是一个开放问题,然而现有许多基准仅关注语法可接受性,对语法形式所传递意义的解读关注甚少。我们提出了用于评估语言模型构式理解的语言学最小对立对基准(CxMP),该基准以构式语法为理论基础,将形式—意义配对(构式)视为基本语言单位。它通过涵盖九种构式类型的受控最小对立对,评估模型是否能够解读构式所蕴含的语义信息。实验结果表明,即使在大型语言模型(LLM)中,构式理解的发展仍更为缓慢且在某些构式上表现有限,而语法可接受性能力的出现则更早;在 CxMP 上,浅层启发式方法呈现出 U 形模式。这些发现凸显了扩展现有语言学评估以捕捉语言形式所编码之意义的必要性。
一句话总结
奈良先端科学技术大学院大学、国立信息学研究所和东京大学的研究者提出了 CxMP,这是一种基于构式语法的语言最小对立体基准,用于评估大语言模型是否能够理解九类语法构式中编码的意义。研究发现,构式理解的发展更为渐进,并且即使在大型模型中仍然有限,而语法可接受性出现得更早。
核心贡献
- CxMP 被提出为一个基于构式语法的基准,用于评估语言模型是否理解构式所隐含的语义信息,而不仅仅是判断语法可接受性。
- 该基准在九类构式中使用了受控最小对立体、多种名词变体、参与者角色交换以及多句设计,以将构式意义与词汇关联和浅层启发式分离。
- 实验显示,构式理解的发展更为渐进,在小模型和大语言模型中对某些构式仍然有限;而语法可接受性出现得更早,并且 CxMP 中的浅层启发式呈现 U 形模式。
引言
作者将语言模型评估置于构式语法框架内,该框架将成对的语言形式与意义视为语法的基本单位。这一点很重要,因为当前评估通常关注语法可接受性,而不是模型是否理解句法模式所传递的意义,例如某一构式所蕴含的角色与语义关系。先前工作受到构式基准碎片化、仅聚焦单一构式的狭窄关注,以及使模型推理不透明且不利于小模型的 NLI 式格式的限制。为解决这一问题,作者提出 CxMP,这是一个覆盖九类构式并使用最小对立体来测试语言模型(从具有发展合理性的较小模型到现代大语言模型)能否捕捉构式所编码意义的受控基准。
数据集
-
CxMP 是一个面向构式理解的评估基准数据集。作者使用它在不同规模的模型上测试语言模型能否将句子形式映射到构式层意义。
-
数据集规模与结构:
- 数据集总共包含 43,000 个评估对。
- 每个评估对包含一个带有目标构式的构式示例句子,以及一句用于探测该构式意义的诊断句。
- 诊断句被写成可信解释与不可信解释之间的最小对比。
- 每个构式都有两个变体,标记为 A 和 B,用于探测互补视角。
- 数据未被描述为训练语料,论文也未报告训练划分、混合比例或数据混合策略。
-
主要数据来源与生成流程:
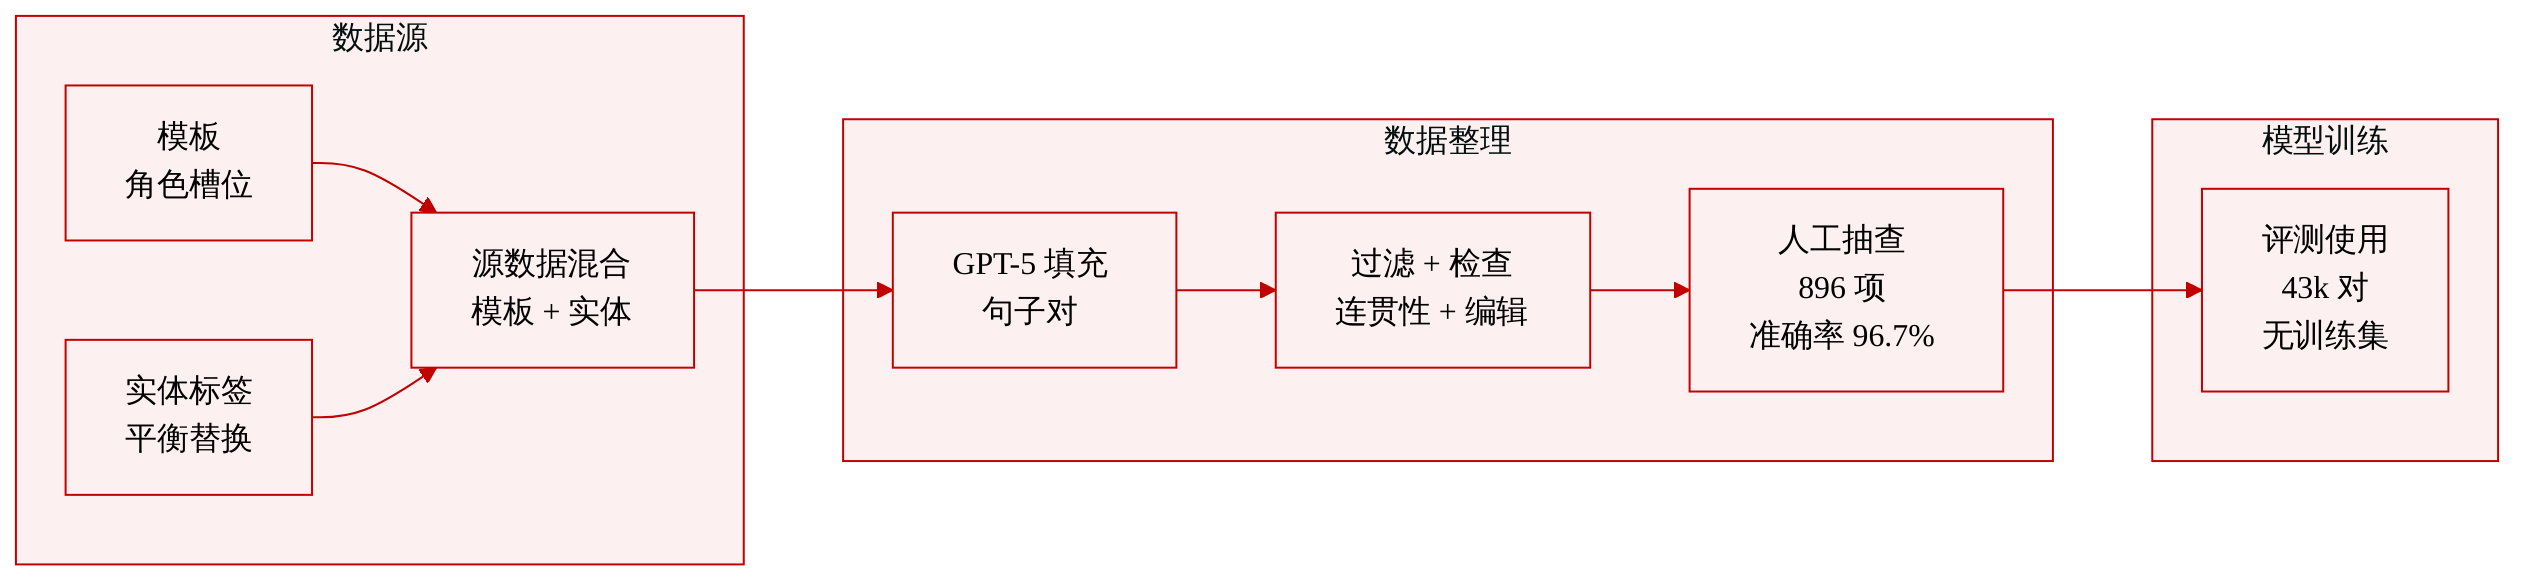
- 作者使用 GPT-5 从预定义模板生成构式示例。
- 模板包含结构角色的槽位,例如主语、动词、宾语、斜格短语、开放小句补语以及实体名称。
- 每个构式都预定义了可信诊断句。
- 不可信诊断句通过将选定词语替换为不可信替代词来生成。
- 生成的句子使用启发式规则和基于大语言模型的语义连贯性检查进行过滤。
- 数据子集经过人工检查,以验证评估对是否连贯。
-
人工验证子集:
- 作者通过 Prolific 招募的英语母语者对人工标注子集进行了验证。
- 标注者阅读一个句子,并选择更可信的后续表达。
- 验证样本包含 896 个条目。
- 每个条目获得三个独立标注。
- 多数投票准确率为 96.65%。
- 标注者完全一致率为 83.59%。
- 不同构式的条目数量不同;对于没有未交换变体切换的构式,通常为 112 和 56。
-
实体与变体控制:
- 使用四种实体标签类型:
- 女性姓名。
- 男性姓名。
- 姓名加字母标签,例如 Name B。
- 普通名词。
- 这些实体类型以相同比例使用。
- 对于包含两个参与者的构式,作者创建了交换主语和宾语位置的版本。
- 交换版本与未交换版本保持平衡。
- 该设计降低了对词汇偏置、词序启发式以及与性别相关的姓名模式的依赖。
- 使用四种实体标签类型:
-
构式子集与设计细节:
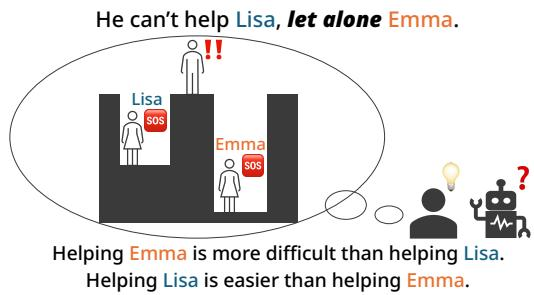
- LET-ALONE:
- 使用带有否定极性环境的名词比较。
- 包含 cannot 和 don’t 等否定助动词。
- 探测在否定标量维度上哪个动作更难。
- 相关构式 MUCH-LESS 被省略,因为它被视为 let alone 的表层变体。
- CAUSATIVE-WITH:
- 使用直接宾语后的 with 短语。
- 将主语和宾语限制为人类名词。
- 测试模型是否正确解读受影响实体与被提供实体。
- WAY-MANNER:
- 在宾语位置使用固定短语 one’s way,随后接路径或位置短语。
- 探测运动与静止以及有意努力。
- COMPARATIVE-CORRELATIVE:
- 使用两个以 the 开头并接比较形容词或比较副词的从句。
- 第二个从句依赖第一个从句。
- 探测当第一个从句设置关系条件时,哪个实体表现出结果性质。
- CONATIVE:
- 使用 by at 引导的直接宾语,表示未保证成功的尝试性动作。
- 包含一半 conative 示例和一半标准及物示例。
- 探测模型能否区分尝试但不确定的动作与成功影响受宾体的动作。
- DITRANSITIVE:
- 使用主语、动词、宾语 1、宾语 2 的图式。
- 编码将客体转移或给予接受者。
- 探测谁给出物品以及谁接收物品。
- CAUSED-MOTION:
- 使用主语、动词、宾语、斜格短语的图式。
- 斜格短语表示方向或路径。
- 探测谁引发运动以及哪个参与者被移动。
- RESULTATIVE:
- 使用主语、动词、宾语、开放小句补语的图式。
- 补语通常表示状态变化。
- 探测哪个参与者经历了变化以及哪个参与者引发变化。
- INTRANSITIVE-MOTION:
- 使用主语、动词、斜格短语的图式。
- 斜格短语表示作为目标的有生命实体。
- 探测谁移动以及哪个参与者是运动目标。
- LET-ALONE:
-
元数据与处理特征:
- 每个实例都关联一个构式标签,例如 conative、ditransitive、caused-motion、resultative、intransitive-motion、comparative-correlatives、way-manner、causative-with 或 let-alone。
- 实例包含变体标签 A 和 B。
- 结构角色通过模板控制,包括主语、动词、宾语、斜格和开放小句补语。
- 包含实体角色标签,用于追踪姓名类型和参与者交换。
- 数据集为纯文本,因此未使用裁剪策略。
- 评估所需的主要元数据包括构式示例、诊断句、可信性标签、构式类型、变体、实体类型和交换状态。
-
论文中的使用:
- 作者将 CxMP 用作与模型无关的评估数据集。
- 它旨在在小模型和大语言模型之间实现一致评估。
- 多句最小对立体格式用于评估构式的语义贡献,而不仅仅是语法自然性。
- 交换实体条件用于检测模型是否依赖表面启发式,而非构式形式与意义的映射。
方法
作者构建了一个统一评估框架,将构式理解操作化为将某一构式的句法形式映射到其对句中实体所施加的语义角色、关系和事件结构的能力。该框架并非仅测试词汇识别或广泛事实知识,而是将正确解释定义为模型能够识别某一特定构式中实体的意义、角色或关系。
该方法围绕九类构式构建,覆盖从部分固定表达到高抽象题元结构模式的谱系。每个构式都配有诊断句,要求模型恢复该构式特有的语义贡献。对于比较相关构式,第一个从句在实体之间建立关系,诊断句询问哪个实体表现出结果性质。对于致使运动构式,斜格短语表示路径或方向,诊断句询问哪个参与者引发运动以及哪个参与者发生运动。对于结果构式,诊断句针对状态变化以及引发变化的参与者。该设计将构式知识转化为针对性的解释判断,而不是表层模式匹配。
构式示例和诊断对通过基于模板的生成流程产生。对于每个构式,作者准备槽位填充模板,指定所需句法角色,例如主语、动词、宾语、斜格短语或补语,以及预期实体类型。语言模型被提示填充这些槽位,以形成上下文中合适的词语。模板约束构式结构,而模型提供自然词汇材料。每个构式还预定义了可信诊断句。随后通过将选定词语替换为违反预期构式解释的替代词,生成不可信替代句。这生成了配对条目,其中正确答案取决于对构式的理解,而不仅仅是选择可信句子。
实体实现方式受到刻意控制,以减少表面词汇或位置线索。框架使用四种实体表达式:女性姓名、男性姓名、带字母标签的姓名以及普通名词。普通名词往往更自然,但可能引入强烈语义偏置。带字母标签的姓名受控程度最高,但自然度较低。人类姓名提供中间选项,但仍可能带有性别关联。对于涉及两个实体的构式,作者还生成两个实体位置反转的交换版本。数据集中交换与未交换版本保持平衡,使框架能够测试模型是依赖词序或位置启发式,还是真正进行构式解释。
生成的输出经过若干过滤阶段。启发式检查移除格式错误或结构无效的句子。额外的基于大语言模型的评估用于判断语义连贯性,以及诊断句是否符合预期构式意义。对生成的评估对子集进行人工检查以确认可靠性。使用英语母语者进行人工验证,进一步检查条目是否可解释,并在更可信后续表达上获得很高的多数投票一致率。该流程最终产生一个受控评估集,其中包含构式语义对,用于在广泛句法构式上测试形式与意义的映射。
实验
实验在模型规模、训练语料、数据规模、训练目标和指令微调等维度评估 CxMP 基准,以确定语言模型是否理解构式意义,而不仅仅是表面语法性。在发展约束条件下训练的模型表现接近随机;更大模型出现不均匀改善,其中掩码目标通常表现更好,而指令微调仅对某些构式有帮助。进一步分析表明,构式意义晚于语法可接受性出现,中型模型通常依赖词汇和位置偏置,而伪词替换揭示了模型对真实词语语义的强烈依赖。
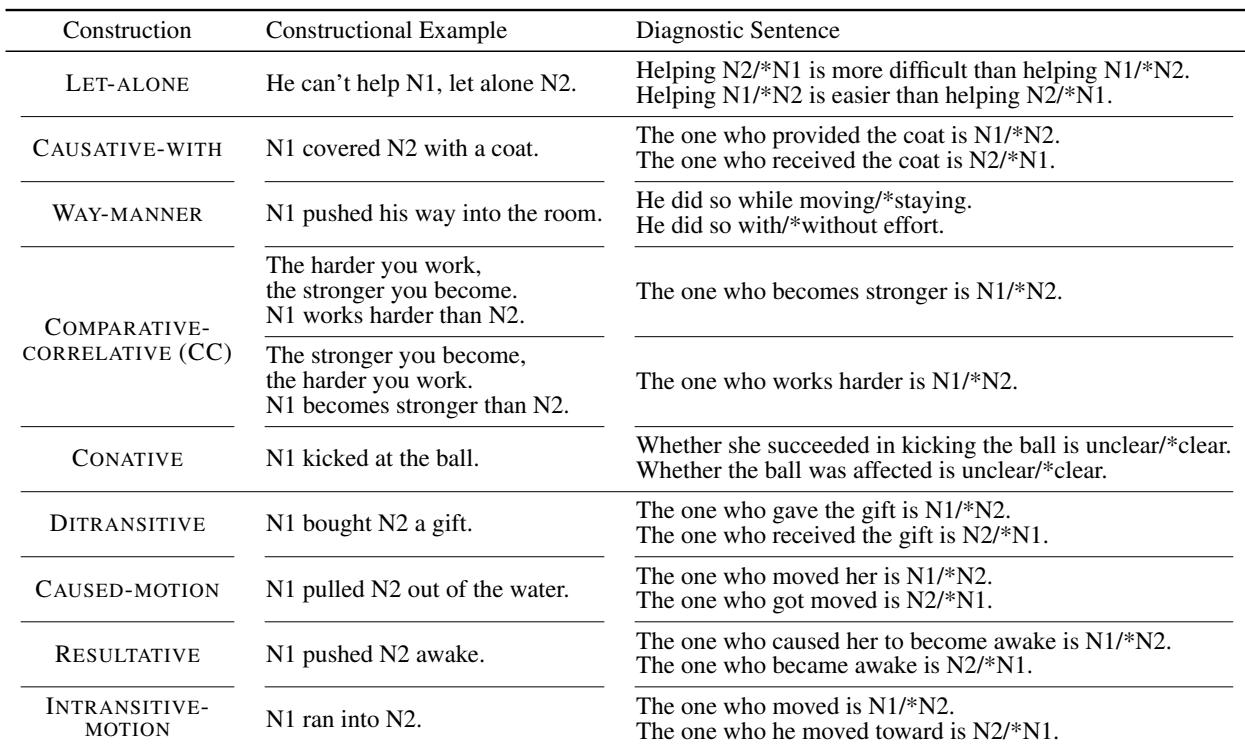
所审查的构式包括部分固定和完全图式化模式,例如 let alone、causative with、way manner、comparative correlative、conative 和 ditransitive。每个构式都用一个短示例以及一个将可信解读与不可信解读进行对比的诊断句进行评估,以探测标量、角色、运动或努力关系。相关模型结果显示,当实词被替换为伪词时,分数下降;但在保留封闭类或屈折线索时,某些模式仍能保持高于随机水平的表现。评估设计使用可信与不可信之间的最小对比对,而不是单一开放式判断。伪词替换会削弱模型性能,表明模型依赖词汇线索;与此同时,运动和题元结构模式在语法线索存在时表现出相对稳定性。
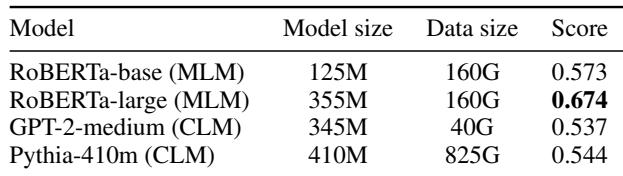
在所列小模型中,较大的 MLM 模型获得最高分,而 CLM 模型分数较低。模型规模在 MLM 对照对中有帮助,但使用更多数据训练的 CLM 仍未超过较大的 MLM 模型。总体模式与周围结果一致,即小规模模型在构式意义方面表现困难。较大的 MLM 模型得分高于其较小 MLM 对应模型,也高于所列 CLM 模型。某个 CLM 模型拥有更大训练语料并未在所示模型中产生最高分。
实验使用可信与不可信最小对比对以及伪词替换来评估部分固定和图式化构式,以测试模型是否捕捉到超越表面词汇内容的构式意义。结果表明,替换实词会削弱性能,意味着模型依赖词汇线索;而在语法线索存在时,某些运动和题元结构模式保持相对稳健。在比较的所有模型中,较大的 MLM 表现最佳,而扩大 CLM 训练数据并不能确保更优结果,这表明小规模模型仍然在构式意义方面存在困难。