Command Palette
Search for a command to run...
ViLL-E:面向检索的视频大语言模型嵌入
ViLL-E:面向检索的视频大语言模型嵌入
Rohit Gupta Jayakrishnan Unnikrishnan Fan Fei Sheng Liu Son Tran Mubarak Shah
摘要
视频大语言模型(VideoLLM)在输出为文本形式的视频理解任务中表现出色,例如视频问答和视频描述生成。然而,在文本到视频检索和片段检索等检索任务中,其性能不及基于嵌入的专用模型。我们提出 ViLL-E(Video-LLM-Embed),一种统一的 VideoLLM 架构,其配备了一种新颖的嵌入生成机制,使模型能够对复杂视频"思考更久",而对简单视频提前停止生成。我们采用三阶段训练方法对该模型进行训练,融合生成式学习与对比学习:首先利用视频-描述对进行大规模预训练;随后在规模更小、描述更精细的数据集上进行持续训练;最后在涵盖视频问答、时序定位、视频检索和视频-文本匹配的新多任务数据集上进行任务特定的微调。我们的模型显著提升了时序定位性能(相较于其他 VideoLLM 平均提升 7%)和视频检索性能(相较于双编码器模型最高提升 4%),在保持视频问答任务竞争力的同时,达到了与最先进专用嵌入模型相当的性能。此外,我们的联合对比-生成式训练方式解锁了新的零样本能力,在组合视频检索(较最先进方法提升 5%)和长文本检索(较最先进方法提升 2%)中显著超越了现有最优方法。
一句话总结
亚马逊和 UCF 提出 ViLL-E,这是一种统一的 VideoLLM 架构,具有自适应嵌入生成机制:对复杂视频进行更长的“思考”,对简单视频提前停止。该架构通过三阶段联合生成与对比流水线训练,显著提升时间定位和视频检索能力,并解锁零样本组合检索和长文本检索能力。
核心贡献
-
ViLL-E 为 VideoLLM 扩展了一种自适应嵌入生成机制,支持文本到视频检索和时间定位,同时保留文本生成能力。该机制允许模型对复杂视频执行更多推理步骤,对更简单视频提前终止。
-
开发了由三阶段组成的生成式与对比式训练方案:大规模视频文本描述预训练、在详细文本描述数据上持续训练,以及在面向视频问答、时间定位、视频检索和视频文本匹配的多任务数据集上进行任务特定微调。该方案使单一模型保持强文本生成能力,并生成强多模态嵌入。
-
ViLL-E 在时间定位方面相比其他 VideoLLM 平均提升约 7%,在视频检索方面相比双编码器模型提升最高 4%,同时在视频问答方面保持竞争力。其联合训练还实现零样本组合视频检索和长文本检索,分别比此前最先进方法约高出 5% 和 2%。
引言
视频大语言模型通过将视觉特征与语言模型对齐,把大语言模型扩展到视频领域,并支持视频描述生成、问答等任务。这一路线之所以重要,是因为视频理解是搜索、内容审核、助手系统和时间推理的核心。
现有 VideoLLM 主要面向文本生成优化,但文本到视频检索和时间定位等重要任务需要判别式视频文本嵌入。以往的检索和定位模型可能很强,但通常面向特定任务或特定数据集,并且不与 VideoLLM 共享同一生成式主干。
作者提出 ViLL-E,这是一个支持文本生成和嵌入生成的统一 VideoLLM。它使用可学习的注意力池化嵌入头、生成式与对比式联合训练,以及三阶段训练流水线。ViLL-E 在视频问答上保持竞争力,在时间定位上优于 VideoLLM,并实现强视频检索性能。
数据集
-
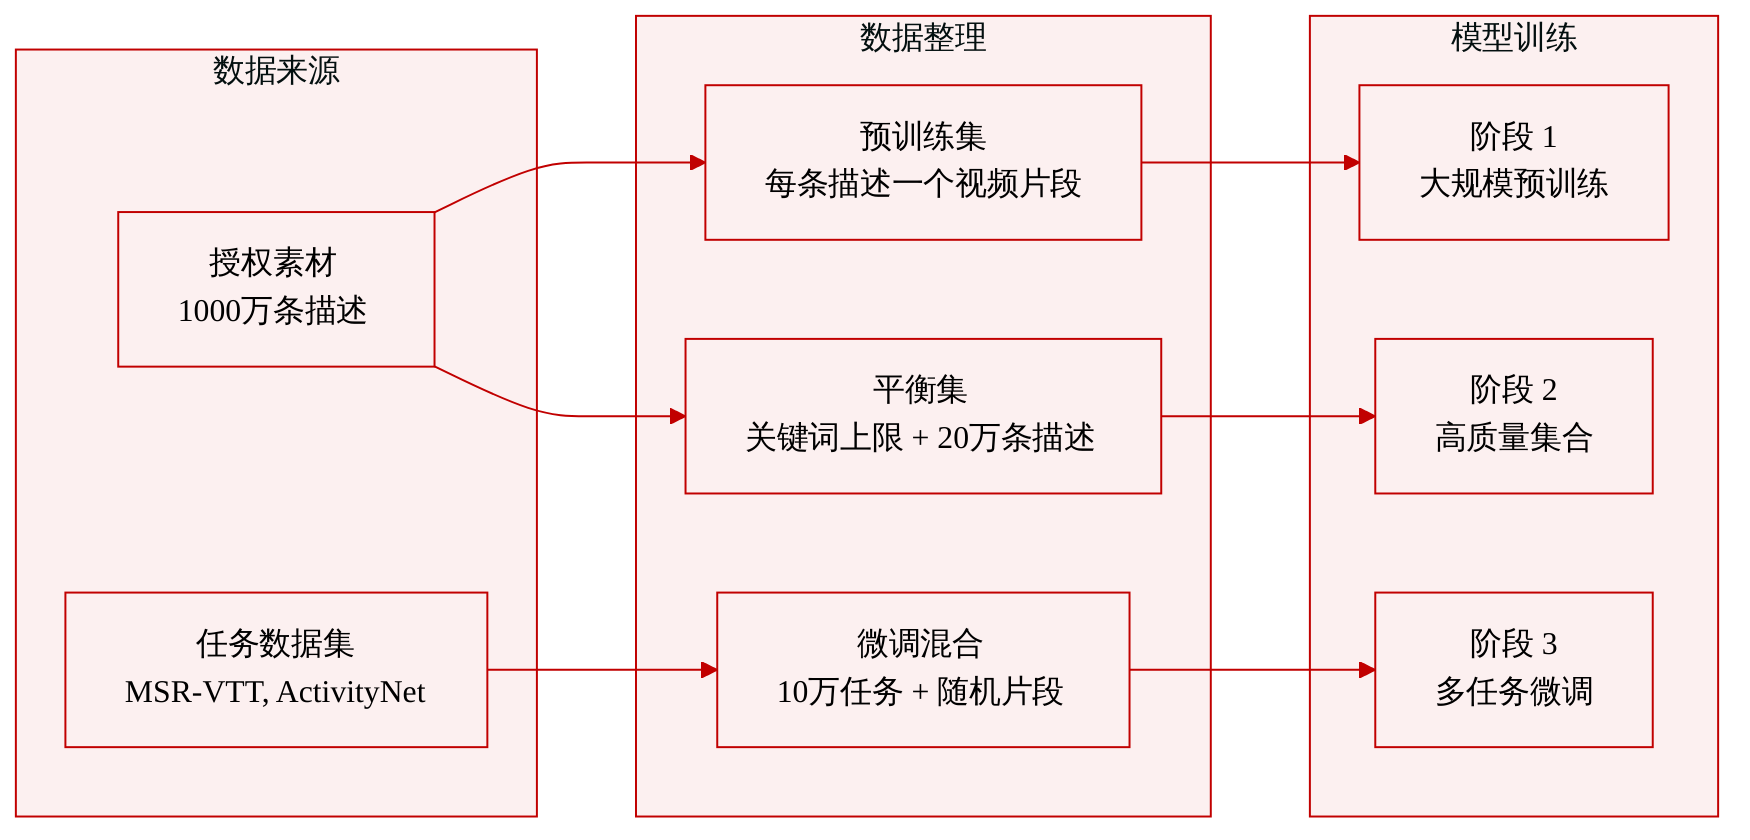
作者构建了面向三阶段训练的数据流水线,主要使用获得授权的 Shutterstock 库存视频,并补充成熟的视频文本数据集用于微调。
-
在大规模预训练中,使用授权 Shutterstock 数据集中的视频文本对,其中包含 1000 万条唯一描述。通过为每条描述保留一个随机视频片段,得到 1000 万视频文本对,规模与 WebVid-10M 接近。
-
在高质量中间训练阶段,使用重新生成描述的 Shutterstock 子集。对原始关键词标签进行过滤,移除出现次数少于 30 次的关键词,然后为每个关键词向候选池添加最多 500 个视频,并优先选择高频关键词。
-
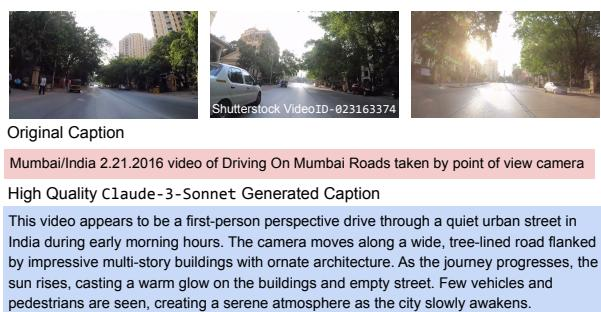
为了在预算约束下创建更多样、更高质量的描述集合,对 20 万条视频生成描述。使用 Claude-3-Sonnet,每个视频采样 20 帧,每帧调整高度为 480 像素,并使用要求详细叙述的提示词,覆盖主题、视觉内容、人物、动作、场景和关键瞬间。
-
这种过滤和重新生成描述的过程旨在平衡数据集,并减少常见概念过度出现的偏差,其依据是对高频类别进行欠采样可以提升对罕见视觉概念的泛化。
-
对于微调,从少量视频文本数据集中抽取 10 万样本,构建多任务数据集。这些样本支持视频描述生成、检索、匹配以及其他指令式监督。
-
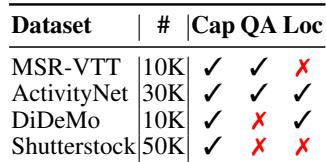
MSR-VTT 提供短视频描述和问答监督。ActivityNet 和 DiDeMo 提供更长的视频,并对视频片段提供可进行时间定位的描述,从而支持定位监督。ActivityNet 还提供问答标注。
-
为保持长尾多样性,在精选微调数据之外混合原始 Shutterstock 视频文本对的随机子集。
方法
作者利用支持生成式输出和面向检索任务的稠密嵌入的统一多模态视频语言模型。系统由预训练多模态语言模型 PaliGemma 3B 初始化,并扩展视觉处理分支、用于高效训练的低秩适配路径,以及独立的嵌入头。整体流水线通过冻结视觉编码器处理视频帧,将提取的视觉特征投影到语言模型空间,并与文本提示嵌入拼接。语言模型随后执行自回归生成,并在产生序列结束 token 后,将相关生成表示传递给嵌入头,形成紧凑的视频嵌入。参见架构示意图。
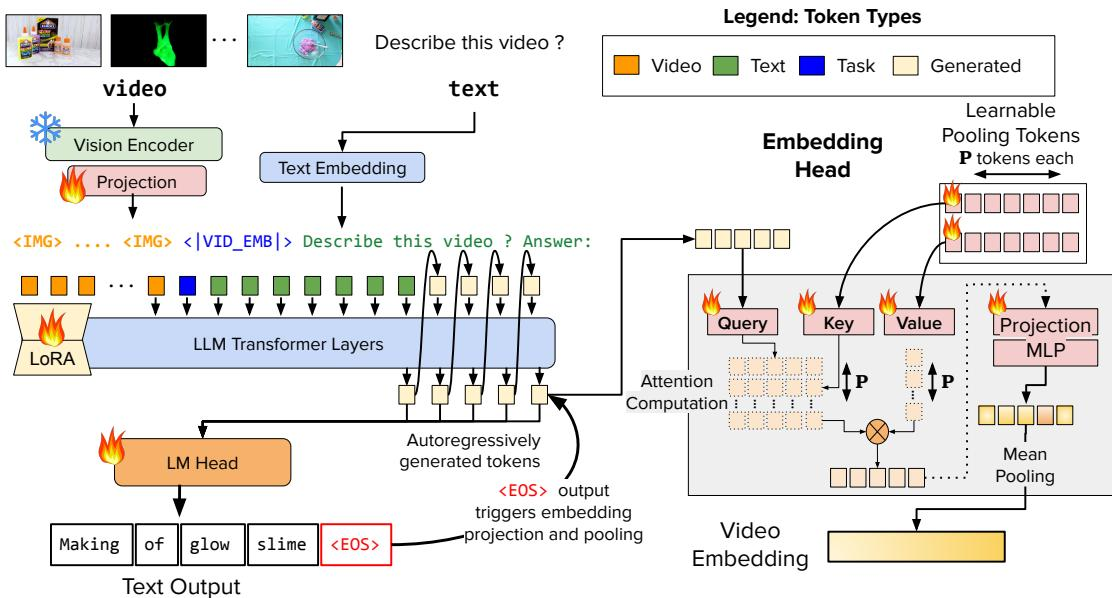
主干遵循前缀语言模型风格的注意力模式。视觉 tokens 和输入文本提示通过双向注意力处理,而模型生成的后缀通过因果注意力处理。该设计保留了视频问答和视频描述等任务所需的强语言建模行为,同时使生成 tokens 可作为变长表示用于嵌入提取。语言建模头生成文本输出,特殊序列结束 token 作为信号,表示模型已完成推理轨迹,随后的嵌入池化操作可以开始。
嵌入头是系统的关键组件之一。其设计目标是参数高效、向稠密嵌入空间提供瓶颈,并适配不同复杂度的视频。作者没有使用固定池化方案或固定的一组可学习查询,而是引入 KV-Former 风格的注意力池化模块。该模块取与生成 tokens 相关的最后层隐藏状态,并将其作为查询。随后使用一组 P 个可学习键值池化 tokens,通过注意力操作从查询 tokens 聚合信息。被注意到的表示经多层感知机投影,再进行均值池化,生成最终视频嵌入。该机制带来灵活性,因为生成 tokens 数量可随视频难度变化。复杂视频可产生更长的推理轨迹,而更简单视频可在序列结束 token 之前产生较短输出。
文本嵌入通过更简单路径生成。由于文本输入不需要以同样方式进行变长自回归推理,模型使用标准推理生成单个文本嵌入。这种不对称性在保持文本侧检索输入效率的同时,让视频嵌入具备自适应能力。
训练组织为多阶段、多任务过程。第一阶段,作者在大规模视频文本数据上进行生成式与对比式预训练。模型用两个互补监督信号训练。对每个视频文本对,第一次前向传播将视频帧与请求模型描述视频的提示一起处理。该次传播同时生成描述文本和视频嵌入。第二次较轻的前向传播单独处理文本输入以生成文本嵌入。生成部分使用下一 token 预测损失监督,嵌入部分使用 CLIP 风格对比目标监督,该目标对齐匹配的视频和文本嵌入,并将它们与批次内负样本分开。组合目标可写为
L=Lgen+λLctr,其中 Lgen 鼓励生成流畅且与上下文相关的视频描述,Lctr 强化跨模态对齐。
第二阶段是在更小规模、更高质量描述集合上继续预训练。作者平衡关键词覆盖度,并对过度常见的概念进行欠采样,使模型保留视觉细节,并泛化到更罕见内容。这一阶段很重要,因为第一阶段描述可能较短或包含噪声,而密集描述性描述有助于在学习表示空间中保留细粒度证据。用更详细生成描述替换简短原始标注的收益可通过下方描述对比图说明。
最后阶段是多任务微调。训练数据结合视频描述生成、问答、文本到视频检索、文本到视频匹配和时间定位等监督信号。在此阶段,语言模型主干通过低秩适配器进行适配,同时完整训练视觉投影模块和嵌入头。该设置使模型在保留预训练生成能力的同时,以较高参数效率学习任务专用检索行为。
检索目标采用对比式设定,鼓励每个视频文本对的排名高于负样本对。视频描述生成和问答使用下一 token 预测训练,由提示引导模型生成请求的答案或描述。匹配任务添加二值对齐信号,教会模型判断给定视频和文本是否构成真实配对。时间定位通过片段窗口上的对比形式训练,其中正样本窗口会与通过滑动窗口挖掘得到的时间重叠有限硬负样本进行对比,例如交并比低于 0.2。这会迫使模型区分视觉相似但语义不正确的时间区间。在所有阶段中,该流水线在单一可训练架构中连接视频理解、语言生成、自适应嵌入生成和面向检索的对比学习。
实验
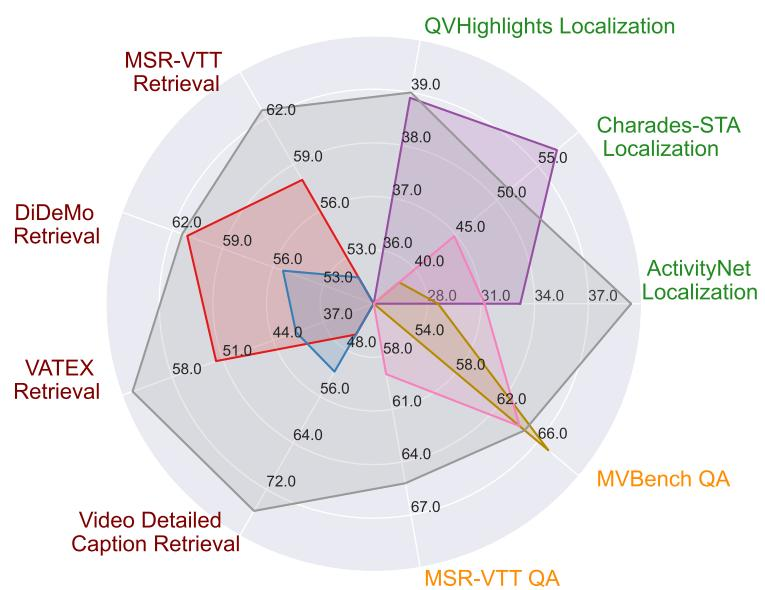
实验评估统一视频语言模型在检索、定位和问答基准上的表现,并探测联合生成和嵌入能力支持的新任务。结果显示,模型提供强视频理解能力,在许多检索和问答设置上保持有竞争力或领先的性能,并支持组合检索和重排序工作流。消融实验表明,结合生成式与对比式监督、使用有效嵌入头,以及大规模预训练,对同时在嵌入和生成任务上保持精度都很重要。
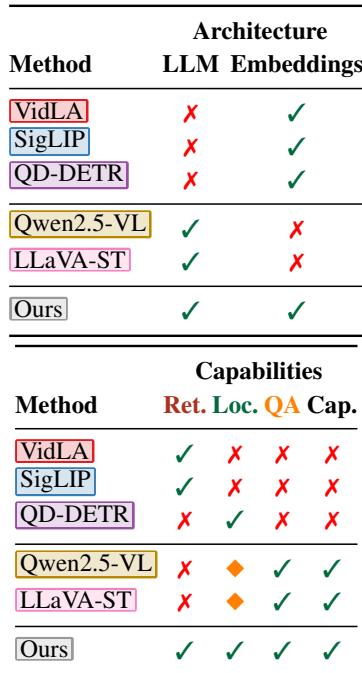
比较结果显示,基于嵌入的检索模型与基于 LLM 的 VideoLLM 之间存在明显差距。ViLL-E 通过同时生成嵌入并保留生成能力统一两者,从而可以匹敌以检索为重点的专家模型。它在生成式视频问答任务上保持竞争力,尽管更强的通用 VideoLLM 在某些生成基准上仍可能领先。专家检索模型提供嵌入但缺少 LLM 生成能力。通用 VideoLLM 提供生成能力但缺少检索所需嵌入。文本到视频检索暴露了标准 VideoLLM 的局限。采用 VideoLLM 重排序的两阶段检索相比纯嵌入检索带来小幅提升。零样本组合视频检索优于近期基线。对比监督对检索和定位质量很重要。
数据集收集涵盖描述、问答和定位等跨四个数据源的视频语言任务。ActivityNet 提供最广泛任务覆盖,MSR-VTT 聚焦描述和问答,DiDeMo 聚焦描述和定位,Shutterstock 主要提供描述。所列数据源在规模和标注侧重上不同,支持混合训练设置。ActivityNet 是任务最多样的子集,包含描述、问答和定位标签。MSR-VTT 支持描述和问答任务,但在此数据集中不支持定位。DiDeMo 提供描述和定位监督,但缺少问答标签。Shutterstock 以相对较多样本纳入,但在该数据集中列为仅描述。
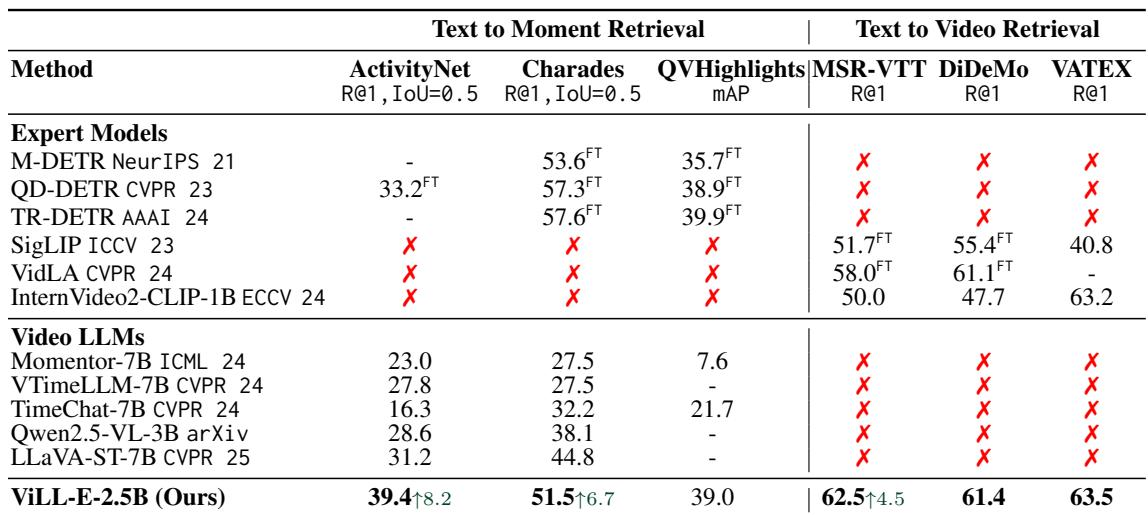
模型在时刻检索和文本到视频检索设置中均展现强统一检索性能。它在时刻检索上优于面向定位的 VideoLLM,并与特定数据集专家模型保持竞争力。对于视频检索,它在标准基准上接近或超过微调检索基线。它在时刻检索任务上优于面向定位的 VideoLLM。它在时刻检索上接近或超过特定数据集专家模型。它在文本到视频检索基准上接近或超过微调图像和视频检索模型。
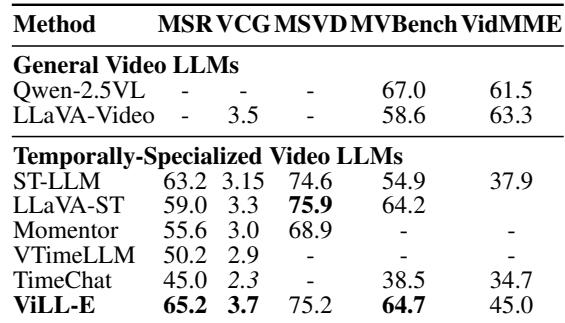
ViLL-E 在简单问答基准和综合视频理解评估中均被认为可与最先进 VideoLLM 竞争。比较显示,通用 VideoLLM 可在综合基准上领先,而面向时间定位的专门模型在聚焦问答数据集上仍很强。总体而言,ViLL-E 在问答类任务上保持竞争力。ViLL-E 在简单问答和综合问答基准上与强 VideoLLM 具有竞争力。通用 VideoLLM 在综合基准上有优势,但 ViLL-E 整体仍保持竞争力。时间定位专门模型在特定问答任务上表现强,表明优势依赖于基准。
两阶段检索和匹配过程在 MSR-VTT 上优于单阶段嵌入检索,它使用 VideoLLM 匹配损失对顶部候选进行重排序。提升在召回指标上最明显,说明生成式推理可以补充基于嵌入的视频描述检索。两阶段重排序在文本到视频匹配上相比单阶段检索带来小幅顶部准确率提升。它提升视频到文本召回,尤其在更宽召回阈值下。该方法在部分两阶段 MSR-VTT 召回分数上超过 VidLA 基线。
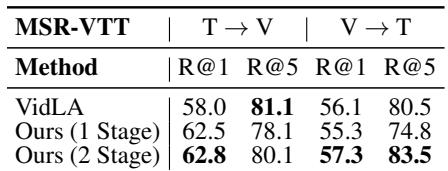
实验使用标注侧重点各异的混合视频语言数据,在检索、时刻定位和面向生成的问答上评估统一视频语言模型。结果表明,该模型能够在保留生成能力的同时提供检索级嵌入,并在时刻检索和文本到视频检索上优于或接近专门专家模型与通用 VideoLLM。关于视频问答和两阶段重排序的额外分析表明,其生成能力具有竞争力,并且基于 VideoLLM 的重排序可以适度补充嵌入检索。