Command Palette
Search for a command to run...
MARCH:用于幻觉检测的多智能体强化自检框架
MARCH:用于幻觉检测的多智能体强化自检框架
摘要
幻觉仍然是大型语言模型(LLM)的关键瓶颈,损害了其在现实应用中的可靠性,尤其是在检索增强生成(RAG)系统中。现有的幻觉检测方法采用“LLM 即评判者”的方式,对照检索到的证据验证 LLM 的输出,但这些方法存在固有的确认偏差,即验证者会无意中重现原始生成的错误。为解决此问题,我们引入了多智能体强化自检幻觉检测框架(MARCH),该框架通过刻意设计的信息不对称机制,强制实现严格的事实对齐。MARCH 编排了一个由三个专门智能体组成的协作流水线:求解器(Solver)、提议器(Proposer)和检查器(Checker)。求解器生成初始 RAG 响应,提议器将其分解为可验证的原子命题。关键之处在于,检查器在隔离状态下验证这些命题与检索证据的一致性,而无法访问求解器的原始输出。这种精心设计的信息不对称方案打破了自我确认偏差的循环。通过使用多智能体强化学习(MARL)训练该流水线,我们使智能体能够共同进化并优化事实遵循性。跨多个幻觉基准的广泛实验表明,MARCH 显著降低了幻觉率。值得注意的是,配备 MARCH 的 8B 参数 LLM 取得了与强大闭源模型相当的性能。MARCH 为通过共同进化实现 LLM 的事实性自我提升铺平了一条可扩展的路径。代码位于 https://github.com/Qwen-Applications/MARCH。
一句话总结
来自阿里巴巴和香港中文大学(深圳)的研究人员提出了MARCH,一种多智能体强化学习框架,通过编排Solver、Proposer和Checker三个agent并刻意引入信息不对称来打破确认偏误,从而减少RAG中的大语言模型幻觉,使一个8B参数的模型达到与闭源系统竞争的性能。
核心贡献
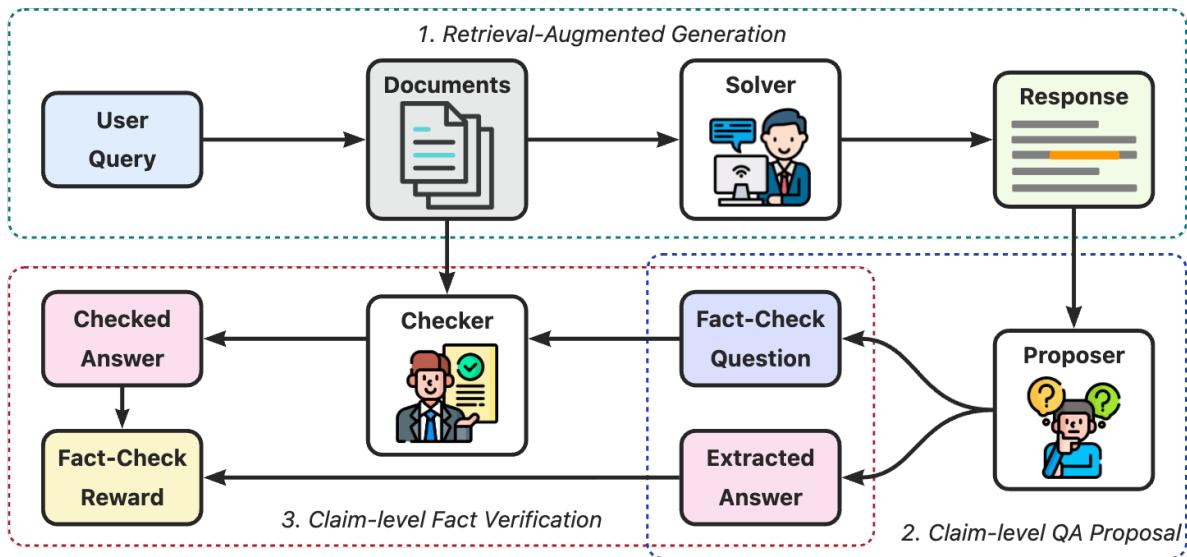
- MARCH(Multi-Agent Reinforced self-Check for Hallucination)编排三个专用agent:生成RAG回答的Solver、将回答分解为原子级主张式命题的Proposer,以及独立对照检索证据验证这些主张的Checker,该Checker严格屏蔽Solver的原始输出。这种信息不对称打破了长期困扰传统"LLM作为评判者"验证模式的自我确认偏误循环。
- 该框架使用多智能体强化学习(MARL)对整个流程进行端到端训练,并采用零容忍奖励机制,即提取的主张与基于文档的验证之间出现任何不一致,都会对整个回答轨迹施加惩罚。这种联合策略优化使得各agent能够共同进化并内化一个自含的验证循环,区别于先前将agent视为独立实体、不进行共享策略训练的多智能体系统。
- 在多种幻觉基准上的实验表明,MARCH大幅降低了幻觉率,且无需额外的人工标注或外部事实核查工具。值得注意的是,配备MARCH的8B参数大语言模型在多个幻觉基准上达到了与领先闭源模型相当的性能,同时在一般RAG问答任务上也取得了显著提升,并且该框架在不同模型家族之间具有泛化能力。
引言
即使经过检索增强,大语言模型在事实性方面仍存在问题,会产生流畅但与所提供来源材料相矛盾的回答。这个问题在金融、法律和医疗等数据密集型领域尤其严重,在这些领域,用户期望模型扮演严谨的证据阅读者而非合理的讲故事者。作者指出,先前的缓解方法在多个方面存在不足。监督微调实际上可能通过促进风格模仿而非事实保真来加剧幻觉,而RLHF中使用的标量奖励过于粗糙,无法对声明级准确性进行监督。可验证奖励方法依赖于稀缺的专家标注真值,并受限于外部验证器的推理能力边界。最关键的是,现有评估方案同时将查询、文档和生成回答暴露给验证器,从而诱发确认偏误,奖励内部连贯性而非真正的来源根基。为解决这一问题,作者引入了MARCH,一个建立在刻意信息不对称之上的强化学习框架。它编排三个专用agent:Solver生成回答,Proposer将回答原子化为离散的可验证声明,Checker在严格屏蔽Solver输出的情况下对照文档验证这些声明,从而防止认知污染。训练采用零容忍奖励机制,对提取声明与基于文档验证之间的任何不匹配施加惩罚,推动系统在无需外部事实核查器或额外标注的情况下实现自我验证。值得注意的是,配备MARCH的8B参数模型在多个幻觉基准上匹配了领先闭源系统,同时改进了通用RAG问答,展示了通向可信agent自我改进的可扩展路径。
数据集
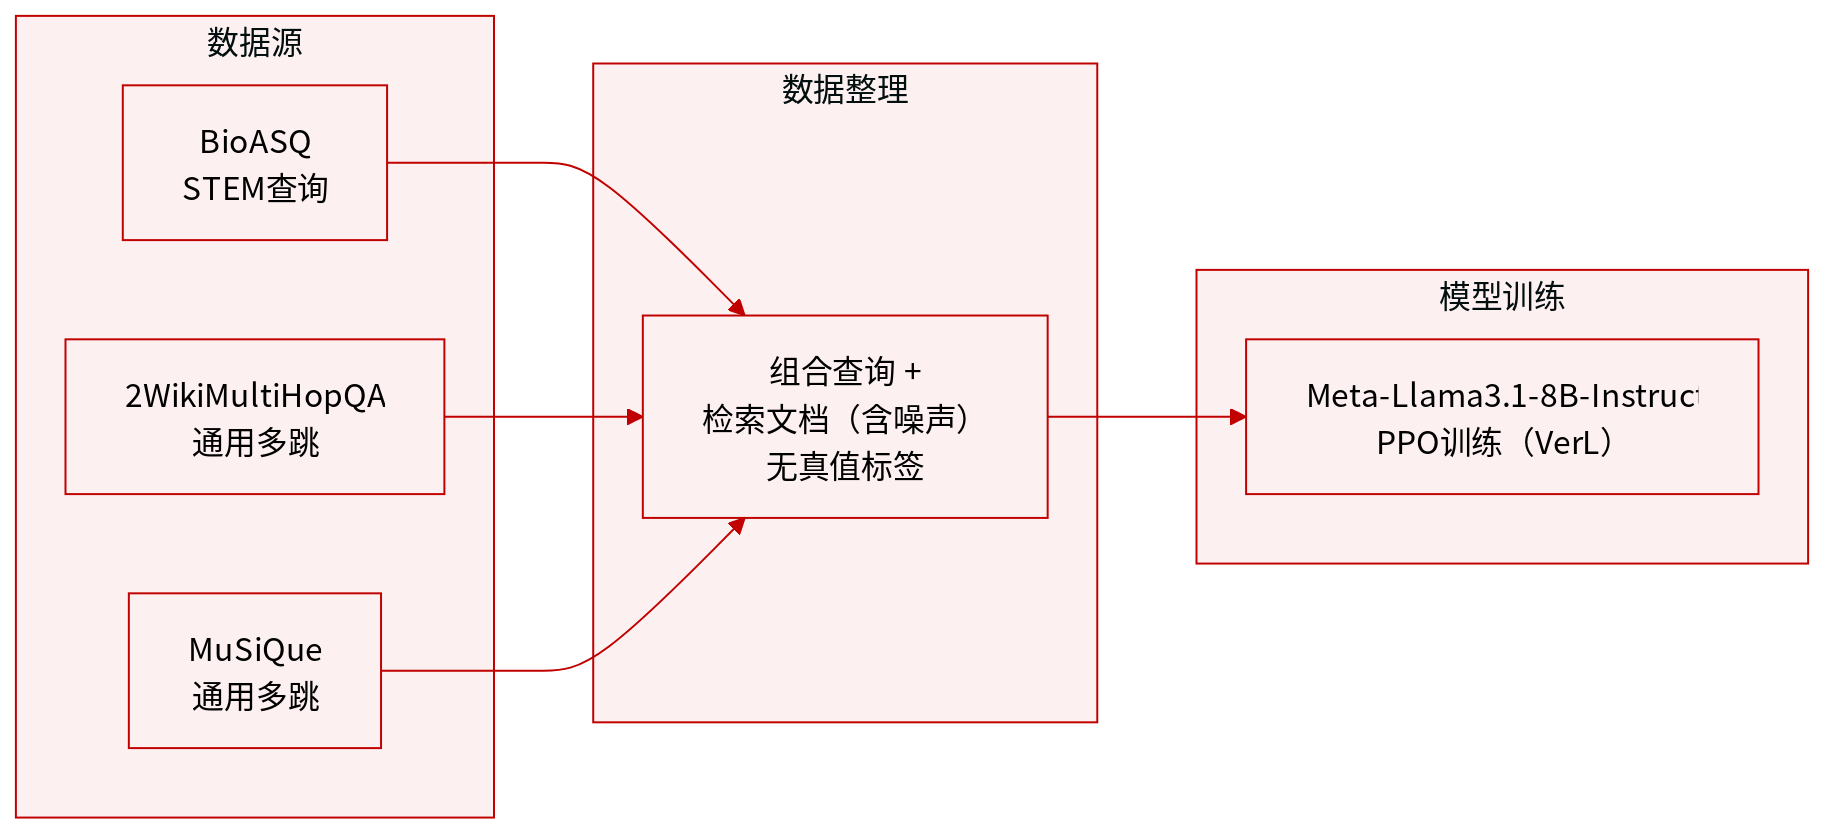
作者基于三个公开可用的问答数据集构建训练设置,根据领域和难度分为两种不同设置。
- STEM设置:基于 BioASQ,聚焦科学、技术、工程和数学类查询。
- 一般设置:基于 2WikiMultiHopQA 和 MuSiQue,涵盖更复杂的多跳推理任务。
对于所有数据集,训练数据仅包含原始查询和一组检索到的文档,不提供真值答案或标注。这使得该设置既真实又具有挑战性,因为检索过程引入了大量噪声和异质性。
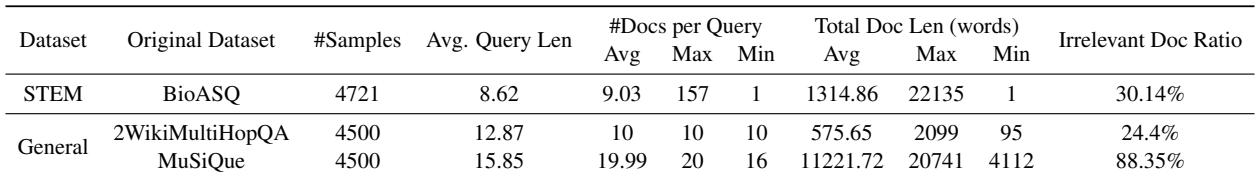
各子集的关键统计信息(来自表1):
- 每个查询的检索文档数量和文档长度在不同数据集间差异很大。
- 很大一部分检索文档与查询无关:
- BioASQ(STEM):30.1% 无关
- MuSiQue(一般):高达 88.4% 无关
- 2WikiMultiHopQA(一般):也显示出高噪声,但文中未明确量化
这种高噪声水平迫使各agent在存在大量干扰项的情况下学习基于文档的事实核查和推理。
作者在训练框架中使用这些数据集,以 Meta-Llama3.1-8B-Instruct 基础模型为起点。训练通过基于VerL的强化学习流程进行,但数据集描述本身仅涵盖组成、来源和噪声特征。文中未提及显式的过滤或预处理步骤;检索到的文档按原样使用,保留其原始噪声分布。
方法
作者提出了MARCH(Multi-Agent Reinforced self-Check for Hallucination),该框架将事实根基重构为一个自含的、可验证的目标,通过将生成过程分解为结构化的非对称协作博弈来实现。该方法不依赖不可用的oracle真值,而是实例化三个源自同一基础策略 πθ 的专用agent:Solver、Proposer和Checker。
流程从 Solver agent开始,它根据输入查询 x 和检索到的文档 D 生成综合回答 y。为了实现细粒度验证,Proposer agent作为回答原子化器,将连续的叙述 y 分解为一组离散的、自包含的事实问答对 {(qi,ai)}i=1n。最后,Checker agent充当盲审审计员。它仅使用检索到的文档 D 回答Proposer生成的问题 {qi},严格不得访问原始回答 y 或提取的声明 ai。这种信息不对称消除了确认偏误。为了确保可靠的审计基线,Checker采用多采样策略,为每个问题生成多个独立的审计轨迹,然后通过多数投票确定最终共识答案 a^i。
如下图所示:
验证循环使用零容忍奖励(ZTR)机制来强制执行绝对的事实根基。该二元奖励函数仅在Solver断言的每个声明 ai 与Checker提供的独立根基 a^i 实现完全身份匹配时才赋予0分。任何幻觉都会导致-1分,形成一种"全有或全无"的结构,防止策略优化部分正确性。
共享策略 πθ 使用近端策略优化(PPO)进行优化。训练过程将Solver的推理路径 y 和Checker的审计轨迹 λ 都纳入优化循环。联合梯度通过对两条轨迹估计的优势之和进行求和计算,使模型能够同时改进其叙述生成和证据精确性,同时保持对参考模型的KL散度惩罚。
实验
实验在幻觉缓解和下游QA推理上评估了MARCH。仅使用带噪的、基于文档的RAG数据(无答案标注)进行训练,MARCH在多种幻觉基准上持续提高事实一致性和细微评判行为,将8B模型提升到与更大的专有系统相当的水平。改进的根基直接转化为更好的多跳推理性能,该小型模型在带噪基准上超过了更大的基线模型。消融实验证实,联合优化Solver和Checker并采用零容忍奖励最为有效,且框架在不同模型家族间具有泛化能力,尽管Proposer倾向于随时间修剪有风险的声明,这可以通过简单的指令约束加以缓解。
训练数据集表现出显著的异质性,检索文档数量及其长度方差很大,且所有设置中无关文档的比例都很高。这种噪声和变异性使训练环境真实但颇具挑战,尤其是在没有真值标注的情况下学习基于文档的事实核查。每个查询的无关文档比例在不同数据集间差异很大,在一个设置中超过88%。检索文档数量和文档长度表现出极端范围,从单个文档到数万词不等。数据集涵盖STEM和一般领域,源自不同的原始数据集,导致查询和文档统计的多样性。
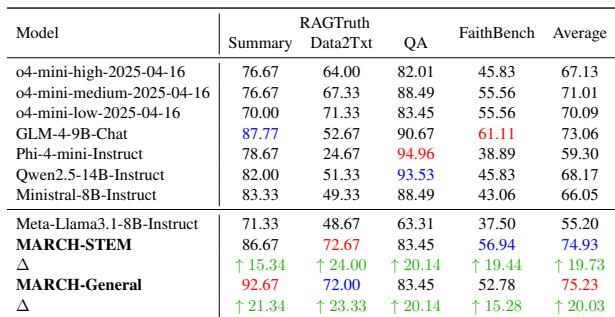
该表比较了多种模型在RAGTruth和FaithBench基准上的一致性率,结果显示不同模型的表现差异显著,其中GLM-4-9B-Chat的平均一致性率最高,而Phi-4-mini-Instruct在RAGTruth上表现尚可但在FaithBench上明显较弱。 GLM-4-9B-Chat达到了最高的平均一致性率(73.06%),优于其他对比模型。 Phi-4-mini-Instruct在RAGTruth上得分较高(78.67%)但FaithBench上仅24.67%,显示出跨基准的显著不一致性。 多数模型在RAGTruth上的得分高于FaithBench,表明不同基准对事实一致性的评估难度存在差异。
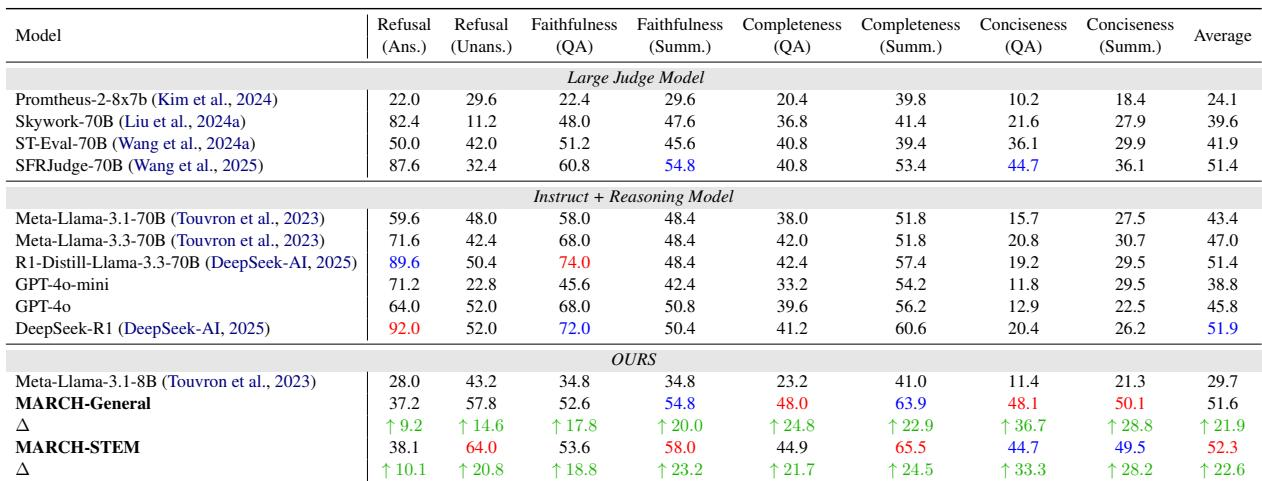
该表比较了多种大型judge模型在ContextualJudgeBench上针对QA和摘要任务的拒绝、忠实度、完整性和简洁性指标。SFRJudge-70B取得了最高的平均准确率,而Promtheus-2-8x7b在所有维度上均明显较差。大多数模型在不同子任务上表现出显著变异性,其中对未回答问题的拒绝检测尤为具有挑战性。SFRJudge-70B以51.4%的平均准确率领先,超出次优模型约9.5个百分点。Promtheus-2-8x7b总体准确率最低,尤其在QA和摘要的忠实度与完整性方面。模型在未回答问题上的拒绝得分往往低得多,例如Skywork-70B仅为11.2%,而它们在已回答问题上的拒绝得分则相对较高。
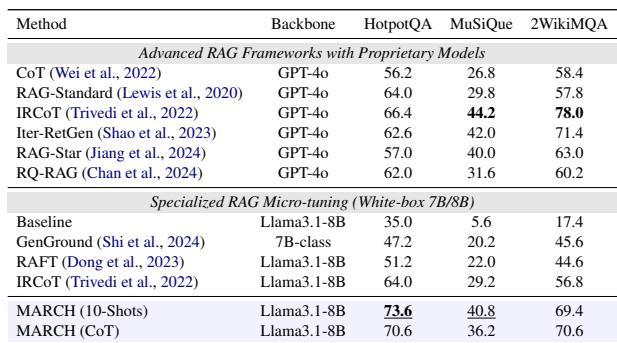
MARCH-Best是一个8B级模型,在多跳QA基准上优于专门的RAG基线,甚至超过了几个基于GPT-4o的框架。值得注意的是,它在HotpotQA和MuSiQue上比RAFT和GenGround等方法取得了更高的准确率,其HotpotQA结果超过了标准GPT-4o RAG和IRCoT(使用GPT-4o)的表现。MARCH-Best在HotpotQA上达到71.2%,超过了标准GPT-4o RAG(64.0%)和IRCoT(使用GPT-4o,66.4%)。在8B级模型中,MARCH-Best在HotpotQA和MuSiQue上的准确率高于RAFT和GenGround等基线。该框架改善了较小模型中的事实根基,使其在多跳推理任务中的表现可与更大专有模型相当或更优。
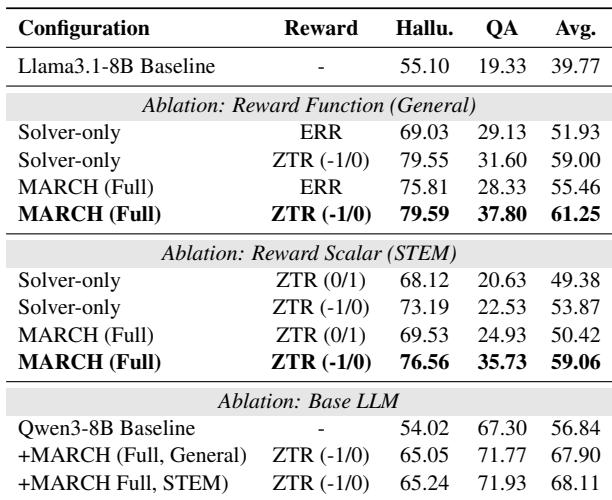
消融研究比较了MARCH框架的奖励机制和配置。结果表明,零容忍奖励(ZTR)优于错误率奖励(ERR),且基于惩罚的标量设置比基于激励的设置更有效。Solver和Checker的联合优化取得了最高准确率,且框架在不同模型家族间具有泛化能力。零容忍奖励始终优于错误率奖励,表明严格的逻辑一致性有利于复杂RAG任务。在ZTR内部,基于惩罚的标量(-1/0)优于基于激励的(0/1)设置,这可能是因为它提供了更强的对抗幻觉的校正梯度。在Qwen3-8B上,框架相较于其普通基线实现了超过11%的绝对提升,展示了模型无关的泛化能力。
实验在多个基准上评估了所提出的MARCH框架,包括RAGTruth、FaithBench、ContextualJudgeBench以及HotpotQA和MuSiQue等多跳QA数据集。MARCH-Best是一个8B级模型,在多跳QA上优于专门的RAG基线和几个基于GPT-4o的框架,同时消融实验表明,采用基于惩罚的标量零容忍奖励以及联合Solver-Checker优化可获得最高准确率,这表明严格的逻辑一致性是有益的。该框架还能跨模型家族泛化,在Qwen3-8B上相较于普通基线实现了超过11%的绝对提升,尽管训练数据带有噪声且异质性高。