Command Palette
Search for a command to run...
刻画 Transformer 中局部注意力的表达能力
刻画 Transformer 中局部注意力的表达能力
Jiaoda Li Ryan Cotterell
摘要
Transformer 是目前最流行的语言建模神经网络架构。Transformer 的基石是其全局注意力机制,该机制使模型在生成下一个词元之前能够聚合所有先前词元的信息。注意力的一种常见变体称为局部注意力,它将每个词元限制在有限窗口内的前驱词元中聚合信息,从而将全局注意力的二次复杂度降低为线性。尽管这种限制通常出于效率考虑,但人们也发现它能提升模型质量,而这一现象迄今缺乏令人满意的解释。我们从识别器表达能力的角度为这一现象提供了形式化的解释。已有研究表明,采用全局注意力的定点精度 Transformer 对应于线性时序逻辑的一个片段,该片段仅包含一个过去算子。我们进一步证明,引入局部注意力会增加第二个时序算子,从而严格扩大可识别正则语言的类。此外,全局注意力与局部注意力在表达能力上是互补的:两者互不包含,而将二者结合则能得到最丰富的片段。在形式语言识别和自然语言建模上的实验验证了该理论,表明全局–局部混合 Transformer 优于仅含全局注意力的同类模型。
一句话总结
苏黎世联邦理工学院的研究人员证明,transformer 中的局部注意力在刻画全局注意力的单一过去算子之外引入了第二个时序算子,严格扩大了可识别正则语言的类,并表明混合全局与局部架构在表达力上互补,在形式语言识别和自然语言建模上经验优于仅全局 transformer。
核心贡献
- 论文将固定精度 transformer 与线性时序逻辑的片段相关联,表明全局注意力对应 LTL[P],局部注意力增加了有界过去算子,严格扩大可识别正则语言的类。
- 该分析建立了精确的表达力关系,包括 k 局部注意力在 k=1 时表达力最大,k 局部注意力与全局注意力不可比较,全局与局部混合注意力对应严格更丰富的片段,而模谓词可以弥合较大 k 的表达力差距。
- 形式语言识别和 WikiText-2 语言建模实验支持该理论,表明混合全局与局部 transformer 优于仅全局模型,且 1 局部混合架构取得最强的语言建模性能。
引言
Transformer 依赖注意力,局部注意力将聚合限制在固定窗口中,使序列建模更高效,并在匹配计算量条件下意外提升语言建模和翻译表现。已有工作将全局注意力刻画为线性时序逻辑的受限片段,但未能解释局部注意力为何能提高表达力。作者将注意力模式与逻辑片段联系起来,表明局部注意力增加了一个新的过去算子,并且全局与局部混合注意力比单独使用全局或局部注意力严格识别更多形式语言。其还表明,纯局部注意力会把表达力坍缩为依赖固定长度后缀,而长度为 1 的 token 局部窗口带来最强的实用增益。
数据集
-
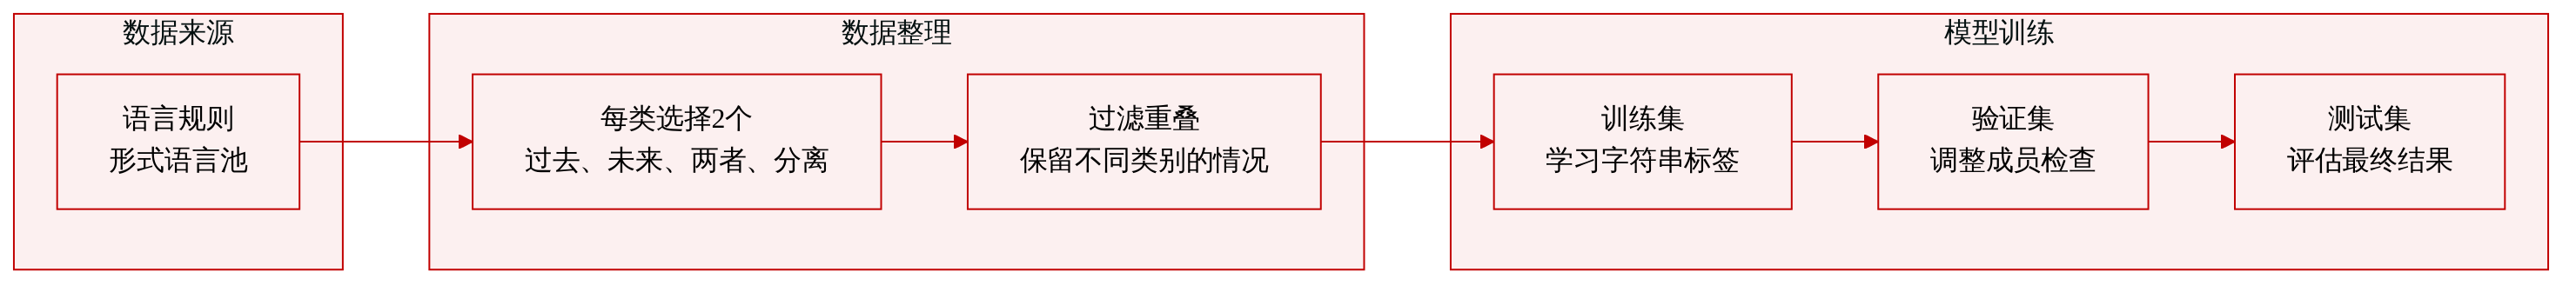
该数据集是用于评估时序逻辑片段的形式语言精选集合。作者从每个可定义类中选择两个代表性语言,使用正则语言定义作为来源。该摘录未报告数据集大小、字符串长度、采样分布或训练和评估划分。
-
LTL[Y] 子集:包含可用未来时序算子定义的语言。作者包括 Σa,即以 a 结尾的字符串,以及 Σab,即以 ab 结尾的字符串。这些捕获基于后缀的性质。
-
LTL[P] 子集:包含可用过去时序算子定义的语言。作者包括 aΣ,即以 a 开头的字符串,以及 ΣaΣbΣ,即包含 ab 作为非连续子序列的字符串。这些捕获前缀和子序列性质。
-
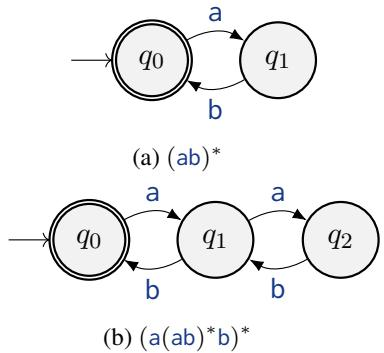
LTL[P, Y] 独占子集:包含可用过去和未来算子共同定义、但不能仅由 LTL[P] 或 LTL[Y] 定义的语言。作者包括 (ab),即由重复 ab 构成的字符串,以及 ΣabΣ*,即包含 ab 作为连续子串的字符串。过滤规则移除在过去仅片段或未来仅片段中已可表达的语言。
-
LTL[S] 独占子集:包含可用分离算子定义、但不能由 LTL[P, Y] 定义的语言。作者包括 {a,b,d}a{c,d},即受限字母表上的右确定多项式,以及 (a(ab)b),即最大嵌套深度为 2 的有界 Dyck 语言。过滤规则移除过去与未来片段中可表达的语言。
-
论文将该数据用作语言成员资格和时序逻辑可定义性的评估套件。模型在这些语言生成或选择的字符串上评估。提供的文本未描述裁剪、元数据构造、混合比例或详细预处理步骤。
方法
作者利用逻辑和自动机理论刻画来分析 transformer 表达力。整体流程首先将线性时序逻辑限制为由过去算子生成的片段,然后将 transformer 形式化为固定精度语言识别器,最后将注意力掩码映射到这些片段。该分析将 transformer 视为在填充序列上的分类器。输入 w=w1⋯wN 被处理为 w=w1⋯wNEOS,决策从 EOS 位置读取。这一约定使 transformer 评估与紧接最后一个 token 后的时序逻辑评估一致。
逻辑侧聚焦于由过去算子 P 和一步过去算子 Y 生成的线性时序逻辑片段。算子 Pψ 询问 ψ 是否在某个更早位置成立,而 Yψ 询问 ψ 是否在前一位置成立。组合片段 LTL[P,Y] 严格包含 LTL[P] 和 LTL[Y],因为这两个片段不可比较。为研究有界过去访问,作者引入 Y≤k 和 Y∗:
Y≤kψ=i=1⋁ki timesYY⋯Yψ,Y∗ψ=i=1⋁∞i timesYY⋯Yψ.算子 Y 是 Y≤1 的特例,而 Y∗ 与 P 重合。因此,将 Y∗ 添加到 LTL[P] 不会增加表达力,而添加完整的一步算子 Y 则会增加表达力。
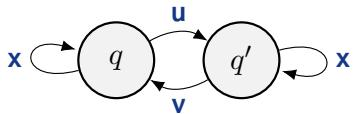
LTL[P,Y] 的刻画还使用标准自动机理论对象。对于正则语言 L⊆Σ∗,令 S 为其句法半群,令 A 为其最小 DFA。语言 L 可在 LTL[P,Y] 中定义,当且仅当 S 满足局部平凡条件,并且 A 避免特定禁止双状态模式。该模式包含两个状态 q 和 q′,在符号 u 和 v 下通过相反转移相连,同时每个状态在符号 x 下还具有自环。参见下面的自动机构型:
transformer 模块被直接定义为语言识别器。一个 (D,L) transformer 包含一个 token 编码器 e:Σ→FD、一族注意力机制 {Aℓ}ℓ=1L、一族按列非线性函数 {Fℓ}ℓ=1L,以及分类函数 c:FD→{0,1}。给定 w=w1⋯wNEOS,初始隐矩阵初始化为
H0(w):,n=defe(wn),n∈{1,…,N+1}.对于每一层 ℓ=1,…,L,模型计算
Gℓ(w)=LN(Hℓ−1(w)+Aℓ(Hℓ−1(w))), Hℓ(w)=LN(Gℓ(w)+Fℓ(Gℓ(w))),其中 LN 表示层归一化。最终决策从 EOS 列读取:
o(w)=defc(HL(w):,N+1).注意力机制是引入相关结构约束之处。对于隐矩阵 H∈FD×(N+1),查询、键和值矩阵由学习到的线性映射生成
Q(H)=ΘQH,K(H)=ΘKH,V(H)=ΘVH.位置对 (n,m) 的原始分数为
Sn,m(H)=DKQ:,n(H)⋅K:,m(H),带掩码 softmax 权重为
αn,m(H)=∑i=1N+1exp(Sn,i(H))Mn,iexp(Sn,m(H))Mn,m.注意力输出为
O:,n(H)=m=1∑N+1αn,m(H)V:,m(H).二值掩码 M 决定哪些过去位置可见。全局掩码允许访问所有更早的 token:
Mn,m∗={1,0,if m<n,otherwise.k 局部掩码允许访问前 k 个位置:
Mn,m≤k={1,0,if max(1,n−k)≤m<n,otherwise.多头注意力通过学习到的线性投影组合多个此类掩码头:
A(H)=h=1∑HΘhOh(H).不同头可以使用不同掩码,因此架构可以在同一模块中混合全局与局部访问。
关键假设是固定精度。所有参数、激活以及乘法、指数运算和 softmax 归一化等基本运算都假设位于有限可表示集合 F 中。结果会舍入回 F,这使得加法和 softmax 敏感的求和顺序在技术上具有相关性。该假设至关重要,因为它使 transformer 的算术行为具有有限状态特征,并使它与自动机和时序逻辑建立联系成为可能。
从掩码到逻辑的对应关系是分析的核心架构结果。如果每个注意力头都使用全局掩码 M∗,则 transformer 从 EOS 位置识别的语言恰好是在 LTL[P] 中定义的语言。如果每个头都使用 k 局部掩码 M≤k,则可识别语言恰好是在 LTL[Y≤k] 中定义的语言。如果一些头使用 M∗,另一些头使用 M≤k,则混合架构从 EOS 位置识别的语言恰好是在 LTL[P,Y≤k] 中定义的语言。因此,混合全局与局部注意力相对于纯全局注意力或纯 k 局部注意力带来严格的表达力增益。
该分析还区分不同窗口大小的逻辑作用。一步局部掩码直接对应 Y,更大的有界窗口则通过 Y≤k 分析。使用重复的一步访问来表达有界 k 窗口回溯,只能通过增加深度来保持表达力,因为位置 1,…,k 上的有界析取可能需要若干堆叠的单步操作。位置信息会改变这一图景。类似
MODmr:w,n⊨MODmriffn≡r(modm)的模谓词允许逻辑引用位置对 m 取模的结果。如果 transformer 的位置编码提供可比的与位置相关的信息,则一个 k 局部头可以在 k 窗口内识别直接前驱,从而影响不同局部掩码方案之间的表达力分离。
实验
实验在从时序逻辑可定义性类中选取的形式语言上,以及 WikiText-2 上的下一 token 建模任务上,评估具有局部专用、混合和全局专用注意力的 transformer 变体。在没有位置编码时,结果非常接近地验证理论:局部注意力识别相应的面向未来语言,全局注意力识别相应的面向过去语言,混合注意力识别二者的并集,非常小的局部窗口表现最强。位置编码产生混合效果,并且没有消除混合注意力的优势,而自然语言实验同样表明,混合注意力,尤其是最小局部窗口,提供最佳整体性能。总体而言,局部注意力和全局注意力是互补的,混合设计结合了二者优势。