Command Palette
Search for a command to run...
大规模多语言联合切分与注释
大规模多语言联合切分与注释
Michael Ginn Lindia Tjuatja Enora Rice Ali Marashian Maria Valentini Jasmine Xu Graham Neubig Alexis Palmer
摘要
利用神经网络进行自动化行间注释预测是加速语言记录工作的一种有前景的方法。然而,尽管 GLOSSLM(Ginn et al., 2024b)等前沿模型在注释基准上取得了高分,针对语言学家的用户研究发现此类模型在实际场景中存在关键性障碍(Rice et al., 2025)。具体而言,现有模型通常生成语素级注释,但将其分配给整个词而不预测实际的语素边界,这使得预测结果可解释性较差,从而难以获得人工标注者的信任。我们开展了首个关于从原始文本联合预测行间注释及对应形态切分的神经网络模型研究。我们通过实验确定了训练模型以平衡切分与注释准确率以及两任务间对齐的最优方式。我们扩展了 GLOSSLM 的训练语料,并预训练了 POLYGLOSS——一个用于联合切分与注释的序列到序列多语言模型系列,其在注释任务上优于 GLOSSLM,并在切分、注释和对齐任务上超越了多种开源大语言模型。此外,我们证明 POLYGLOSS 可通过低秩适配快速适应新数据集。
一句话总结
科罗拉多大学博尔德分校和卡内基梅隆大学提出 POLYGLOSS,这是一组多语言 seq2seq 模型,能够从原始文本联合预测行间标注和形态切分,解决 GLOSSLM 等先前模型无法预测词素边界的不足,在标注方面优于 GLOSSLM,并在切分、标注和对齐方面超越开源 LLM,同时支持对新数据集进行高效的低秩适配。
核心贡献
- 引入 POLYGLOSS,这是一组多语言 seq2seq 模型,用于从原始文本单次联合预测行间标注和形态切分,解决先前行间标注系统缺少可解释词素边界的问题。
- 发布扩展并标准化后的 341k 示例 GLOSSLM 语料库。在该语料库上训练的模型在标注方面优于 GLOSSLM,并在切分、标注和对齐方面超越多种开源 LLM。
- 该工作展示了实际部署路径,表明 POLYGLOSS 可以通过低秩适配快速适配到新数据集。还表明每个语言的困惑度可以近似标注质量,用于过滤或回退。
引言
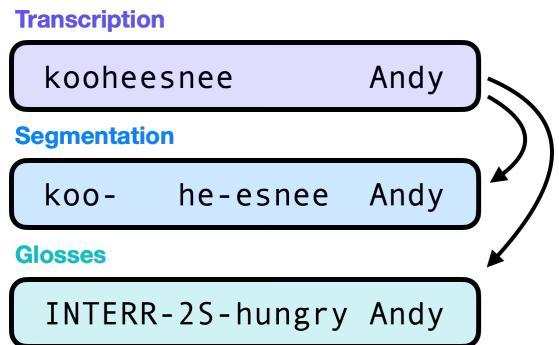
语言记录日益紧迫,因为世界上近一半语言面临消亡。行间标注文本整合了形态切分、标注标签和翻译,支持语言分析、教学以及可搜索语料库和机器翻译等工具。先前的自动行间标注系统主要根据转录文本或切分结果预测标注,但用户研究表明,直接输出标注可能难以解释、对某些语言不可靠,并且不符合偏好的标注惯例。作者利用扩充并标准化后的 341k 示例 GLOSSLM 语料库,训练了一个多语言模型,以联合预测形态切分和标注。他们还表明,每个语言的困惑度可以估计标注质量,用于过滤或回退,并且低秩适配可以快速将模型输出适配到新的标签惯例。
数据集
-
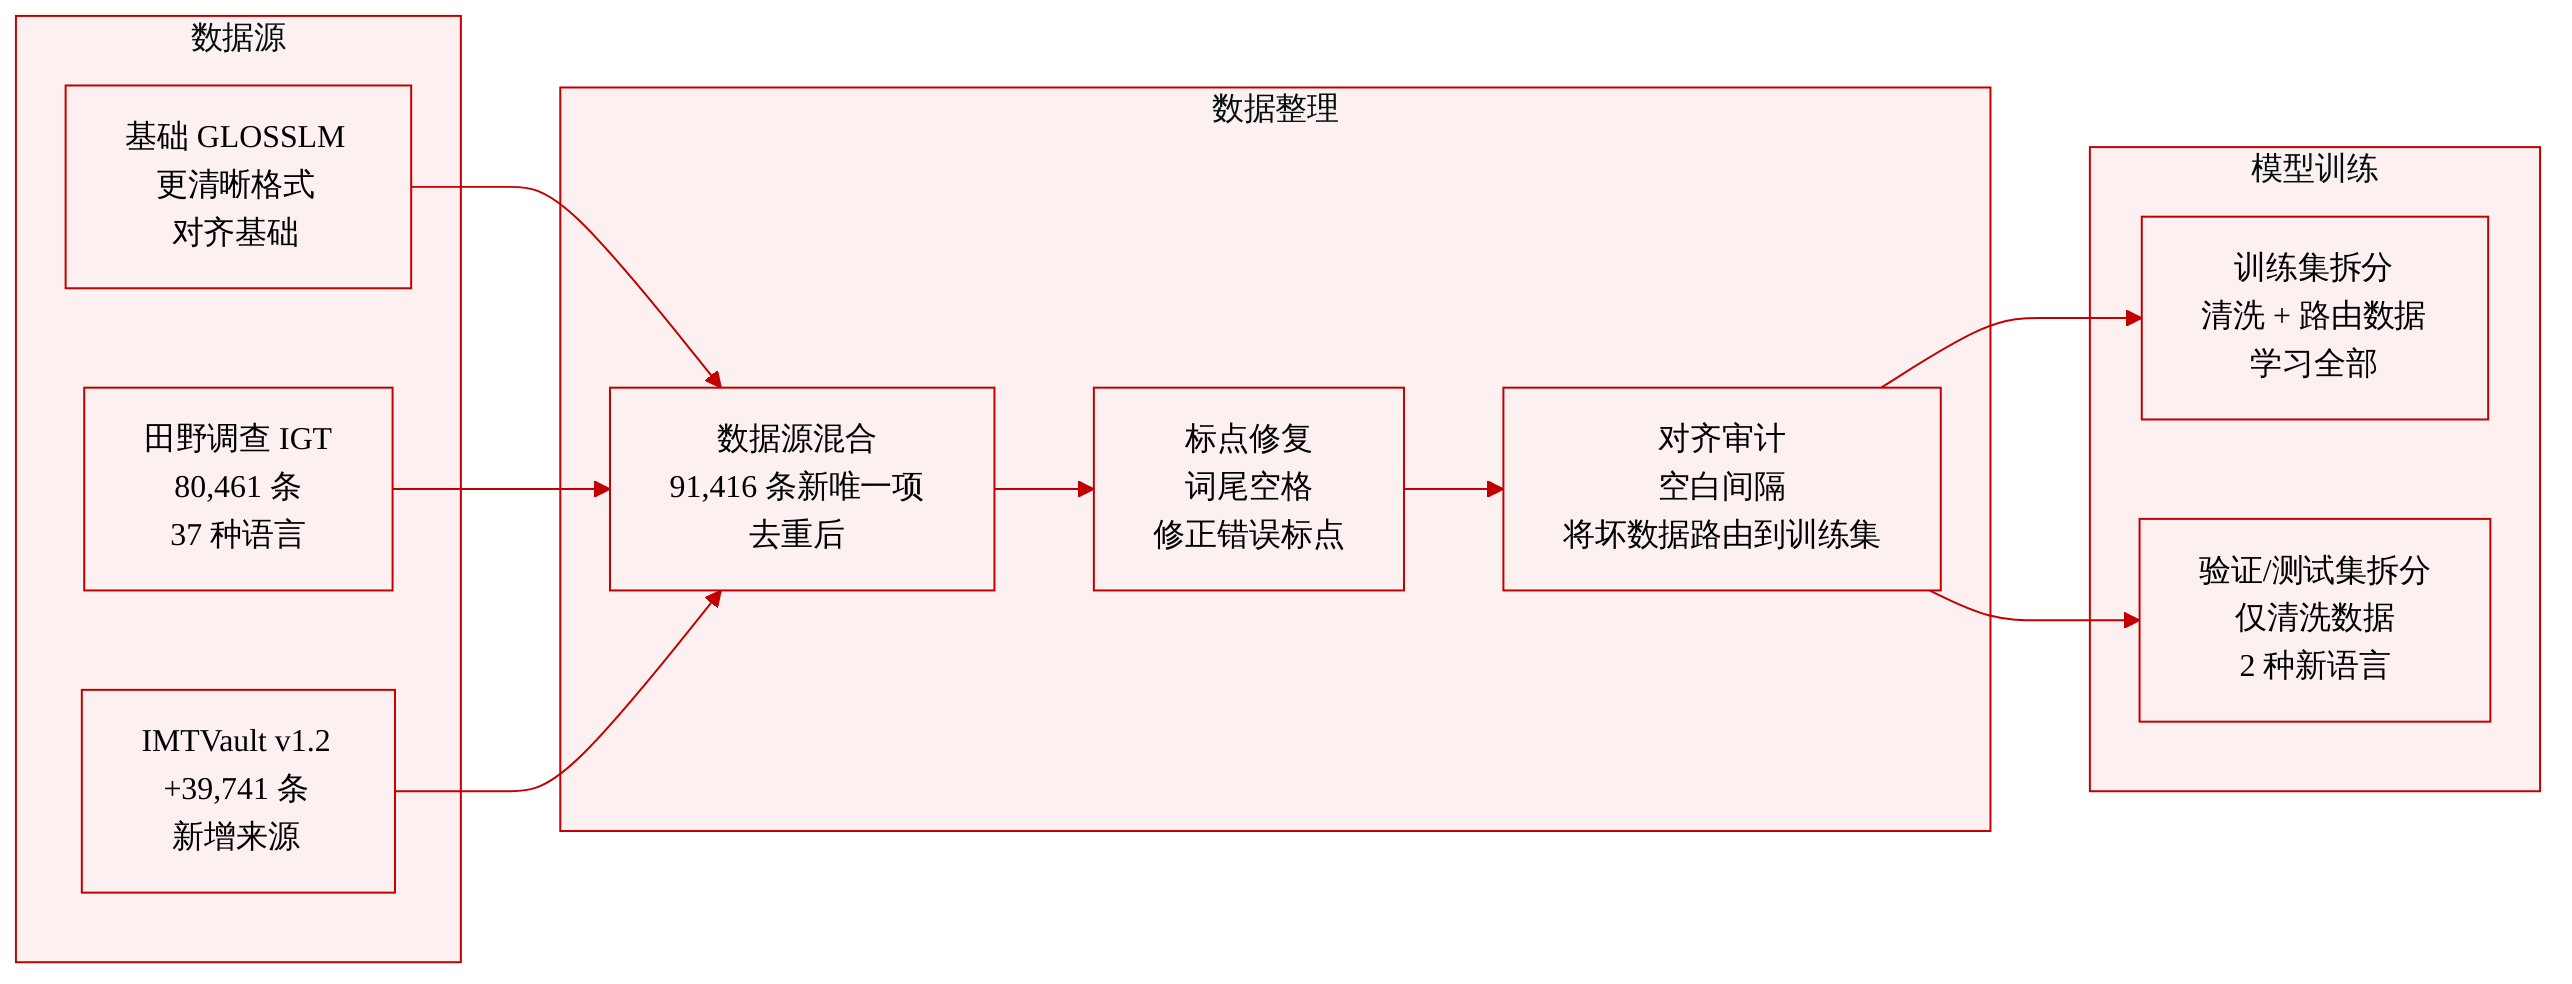
作者构建了 GLOSSLM 语料库的增强版本,通过改进原始语料库格式并添加新的行间标注文本数据实现。基础数据仍与 GLOSSLM 对齐,而增强语料库增加了更清晰的处理和更大的评测覆盖范围。
-
额外的 IGT 数据来自两个主要来源。Fieldwork 数据集提供了 37 种语言的 80,461 个 IGT 实例。IMTVault 更新至 1.2 版本,新增从较新语言学出版物中抓取的 39,741 个示例。
-
作者删除 20,116 个重复示例,并从这些新增内容中过滤极低质量示例。与原始 GLOSSLM 语料库相比,最终额外数据达到 91,416 个唯一示例。
-
所有来源都进行了标点规范化。句末标点两侧添加空格,而标注内部的标点保持不变。这有助于更一致的切分、tokenization 和标注对齐。
-
修复了特定来源的格式错误。例如,在 Arapaho 数据中,识别出 4,882 个在标注字段中包含 ",." 序列的实例,并由原始标注者确认为错误。
-
作者审查了形态切分与标注对齐。如果形态切分字段没有切分标记,而标注字段有多个片段,则切分字段设为空白。如果不对齐示例仍保留切分,则仅放入训练集,避免影响评测。
-
数据集同时用于训练和评测。不对齐或存在问题的示例经过清理、过滤或归入训练集,使评测数据更可靠。
-
从 Fieldwork 数据集新增两个评测语言:Hokkaido Ainu 和 Ruuli。论文还提供评测语言的数据划分信息,以及审查过程中的质量和错误统计。
方法
作者将 POLYGLOSS 构建为面向多语言行间标注的继续预训练框架。基础模型是 ByT5,一种基于 T5 架构的字节级编码器解码器 Transformer。选择字节级输入表示是为了避免罕见或类型学上距离较远的语言出现子词 tokenization 失败。模型从包含 580 million 个参数的 byt5 基础检查点继续训练。在继续预训练期间,模型学习从转录文本预测标注,并在可用时从形态切分预测标注。偏好的评测设置使用未切分转录文本,因为这是更困难且更现实的输入形式。
该方法围绕三种输出形式组织,这三种形式通过不同方式建模切分与标注之间的关系。在多任务预测设置中,流程为切分和标注分别创建训练示例。这允许系统从同一输入模型推断两种输出,但切分片段与标注之间的对齐并未被显式约束。作者认为这是导致不对齐的潜在来源,因为两个输出由独立监督目标生成。
为捕捉切分和标注之间的依赖关系,流程还使用拼接预测形式。在这种设置中,模型训练为在单一生成序列中首先输出形态切分,然后输出标注。由于训练遵循因果语言建模目标,模型在生成标注字符串时可以注意到较早的切分 token。这会形成从标注到切分的隐式依赖,但并不保证严格对齐。因此,生成不佳的切分会将错误传播到标注序列。为处理包含标注标签但不包含切分标签的示例,训练混合中也包含多任务风格的单独标注示例。
最结构化的形式是交错预测,它在输出格式中引入硬对齐约束。在这种设置中,每个标注标签之后紧跟以括号括起、与之对应的词素。这种安排迫使生成输出直接暴露标注与片段之间的映射。作者推测,这种格式应能产生最强的对齐效果,因为良好形成的预测必须包含成对的标注 token 和词素 token。
训练过程保持优化配置相对保守。所有模型都使用 bf16 精度,通过 AdamW 和默认超参数训练。学习率调度首先在前 3% 的训练步骤中使用线性预热,然后进行余弦衰减。应用最大范数为 1 的梯度裁剪。ByT5 变体的学习率为 5×10⁻⁵,batch size 为 64,训练 15 个 epoch。该设置使用四张 GH200 GPU,评测采用两条 beam 的 beam search。
面向新语言或标注风格的部署,作者使用低秩适配(LoRA)对 POLYGLOSS 进行适配,而不是全参数微调。这降低了计算成本,并支持从少量标注示例进行适配。在针对预训练期间未见语言的模拟标注场景中,rank 8 适配器在规模不断增加的训练集上训练,每次增加 50 个示例。最大适配运行使用 25 个 epoch、batch size 32,并且仅在 A100 GPU 上需要 12 分钟。下图展示了交错式 POLYGLOSS 模型和 ByT5 基础模型的适配行为。
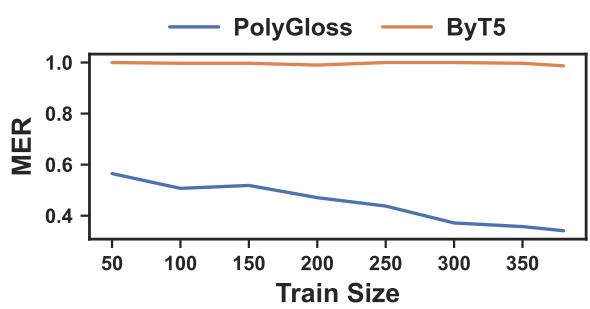
该图表明,预训练的 POLYGLOSS 表示可以随着更多数据可用而快速适配新语言,而 ByT5 基线仍保持较高的词素错误率。这支持了从语料库预训练的 POLYGLOSS 模型开始、并应用轻量级参数高效适配的设计选择,而不是为每个新语言从头训练通用多语言模型。
作者还将对齐评分机制与强化学习后训练过程联系起来。对齐评分被用作可验证奖励强化学习中的标量奖励函数。在针对拼接预测模型的一项初步研究中,使用 vanilla GRPO 来提升输出一致性。优化使用 β=0.1 和学习率 5×10⁻⁵。batch size 和 group size 都设置为 8,模型训练 50 个 epoch。在采样期间,解码温度为 0.6,top p 为 0.9,并施加 1.05 的重复惩罚。
该对齐奖励优化前后的结果如下图所示。
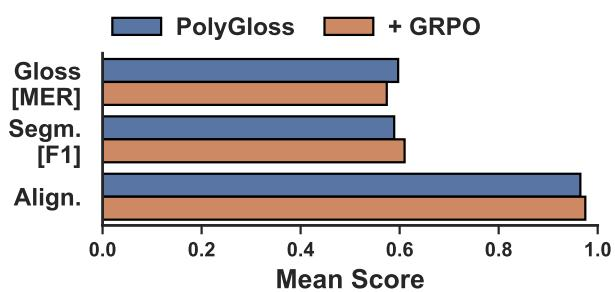
该图报告了 GRPO 调优前后的平均标注 MER、切分 F1 和对齐评分。基于奖励的更新在这些指标上产生轻微改进。该过程可以被解释为一种后训练阶段,使模型更容易生成便于对齐的输出,而无需额外标注数据。它也为缺少金标准形态切分的新语言提供了可能的适配机制,因为对齐奖励会鼓励生成的切分与可用标注标签相对应。
实验
实验使用标注、切分和对齐指标评估联合标注与切分,并将提出的模型与预训练基线、大语言模型提示、单语言变体和适配策略进行比较。结果表明,联合建模两项任务,尤其是采用交错格式,能够产生准确且对齐良好的输出,而多语言预训练为数据有限的语言带来迁移收益。对齐评分也支持实际使用,帮助预测新语言上的性能,并通过适配和强化学习进一步提升。
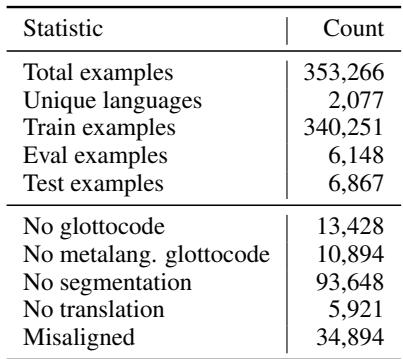
统计数据描述了最终的 POLYGLOSS 语料库,该语料库将清理后的 GLOSSLM 数据与额外的行间标注文本来源相结合。该语料库覆盖超过两千种语言,其中大多数示例被划入训练集,并保留了较小的评测集和测试集。少数示例缺少语言或元语言 glottocode,表明某些来源的元数据不完整。该语料库具有广泛的多语言规模,包含跨数千种唯一语言的数十万示例。训练集占据主导,而评测集和测试集相对较小但相互分离。一些示例仍在语言或元语言元数据中未被分类,反映来源局限。
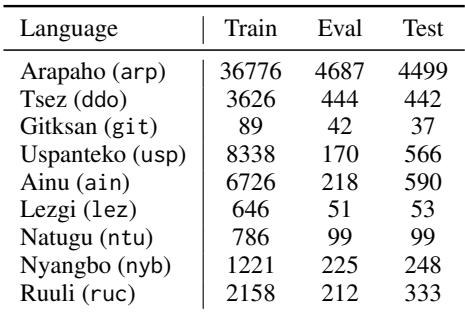
数据划分信息显示,评测语料库在不同语言之间高度不均衡,其中 Arapaho 拥有最大的训练和评测或测试资源,而 Gitksan 的训练集、评测集和测试集都非常小。大多数语言的训练集远大于其评测集和测试集,这表明数据可用性是纳入语言之间的重要差异。Arapaho 是数据最充分的语言,训练数据明显多于其他语言,并且其评测和测试部分也最大。Gitksan 是数据最稀少的语言,训练示例非常有限,评测和测试集也很小,在该语料库中属于低资源情形。包括 Uspanteko 和 Ainu 在内的一些语言,其测试集大于评测集,但其评测和测试数据仍远小于训练数据。
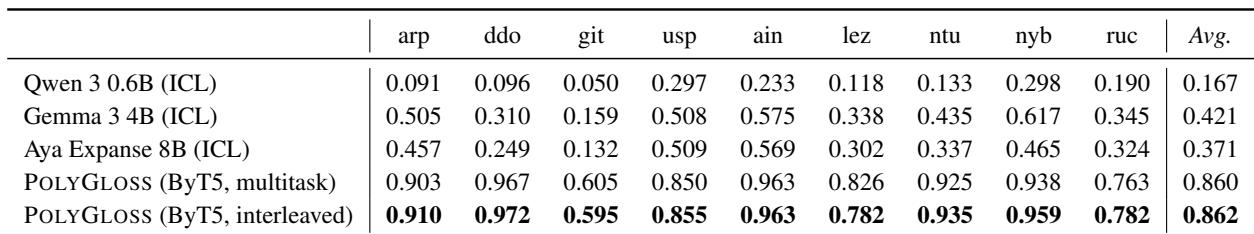
结果比较多语言模型在九个保留测试语言上的标注分数。在显示的行中,POLYGLOSS ByT5 交错模型具有最高的整体平均值,而带有 in-context learning 的 Qwen 0.6B 具有最低的整体平均值。所引用的说明将 POLYGLOSS 描述为优于 in-context learning 基线,并指出 GLOSSLM 在 arp、ddo 和 git 之外的语言上表现较差。POLYGLOSS ByT5 交错模型在列出的模型中具有最高的整体平均值,Qwen 0.6B 在列出的模型中具有最低的整体平均值。说明文本将 Qwen 0.6B 的一些问题归因于格式一致性和对齐失败。
交错式 POLYGLOSS ByT5 模型在展示的每种语言上都达到满分,表明其保留测试上的多语言性能非常强。它的多任务 ByT5 变体整体仍然很强,但没有达到交错格式的满分结果。in-context learning 基线更不稳定,最小的 Qwen 模型整体最弱,更大的 LLM 取得了较高但不完美的分数。交错式 POLYGLOSS 在所有展示语言上都达到满分。多任务 POLYGLOSS 很强,但在平均值上弱于交错变体。最小的 Qwen 模型是最弱的 in-context 基线,而更大的 Gemma 和 Aya 模型更强,但仍然不完美。
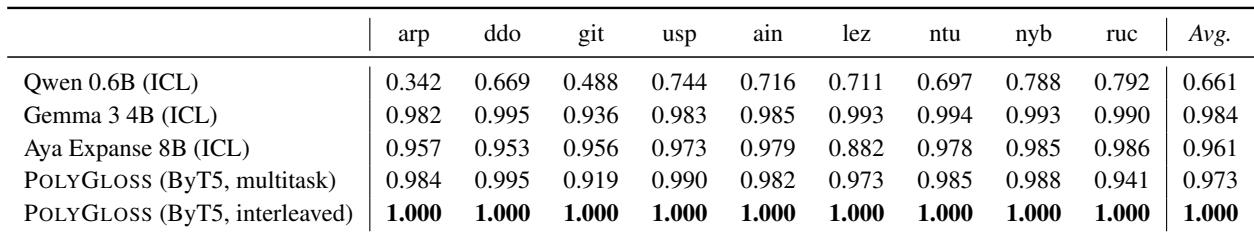
实验评估了所构建的 POLYGLOSS 语料库,该语料库涵盖许多语言,但数据在语言和划分之间不均衡。在九种语言上的保留测试标注实验表明,交错式 POLYGLOSS ByT5 模型表现最强,在展示语言上达到满分,而多任务 ByT5 变体仍然有竞争力但不够稳健。in-context learning 基线更不稳定,最小的 Qwen 模型因格式和对齐失败表现最弱,这表明为标注生成构建专用建模比单纯提示更可靠。