Command Palette
Search for a command to run...
From Local to Global: Revisiting Structured Pruning Paradigms for Large Language Models
From Local to Global: Revisiting Structured Pruning Paradigms for Large Language Models
Ziyan Wang Enmao Diao Qi Le Pu Wang Minwoo Lee Shu-ping Yeh Evgeny V Stupachenko Hao Feng Li Yang
摘要
Structured pruning is a practical approach to deploying large language models (LLMs) efficiently, as it yields compact, hardware-friendly architectures. However, the dominant local paradigm is task-agnostic: by optimizing layerwise reconstruction rather than task objectives, it tends to preserve perplexity or generic zero shot behavior but fails to capitalize on modest task-specific calibration signals, often yielding limited downstream gains. We revisit global structured pruning and present GISP, Global Iterative Structured Pruning, a post-training method that removes attention heads and MLP channels using first-order, loss-based important scores aggregated at the structure level with block-wise normalization. Built on this global importance metric, GISP adopts an iterative schedule, rather than one-shot pruning, stabilizes accuracy at higher sparsity, and mitigates perplexity collapse without requiring intermediate fine-tuning. Importantly, the iterative pruning forms nested subnetworks that support a "prune-once, deploy-many" workflow. Furthermore, GISP defines structural importance directly with respect to a target loss, making it easy to adapt pruning to task-specific objectives. In this work, we use perplexity for language modeling and a margin-based objective for decision-style tasks. Extensive experiments show that across Llama2-7B/13B, Llama3-8B, and Mistral-0.3-7B, GISP consistently lowers WikiText-2 perplexity and improves downstream accuracy, with especially strong gains at 40–50% sparsity; on DeepSeek R1-Distill-Llama-3-8B and Qwen3-8B with GSM8K, task-aligned calibration substantially boosts exact-match accuracy. The implementation is available at the official GISP repository.
一句话总结
北卡罗来纳大学夏洛特分校、DreamSoul、明尼苏达大学和英特尔公司提出了 GISP(Global Iterative Structured Pruning),这是一种训练后方法,它使用按块归一化并在结构层面聚合的全局、基于损失的一阶重要性分数,替代了任务无关的逐层重构,采用一种迭代剪枝计划,在不进行中间微调的情况下稳定更高稀疏度下的准确率,形成支持“一次剪枝、多处部署”工作流的嵌套子网络,并直接相对于目标损失定义结构重要性,以实现任务特定适配,从而在 Llama2-7B/13B、Llama3-8B 和 Mistral-0.3-7B 上带来一致的 WikiText-2 困惑度降低和下游准确率提升,在 40% 到 50% 稀疏度下改进尤其显著。
核心贡献
-
GISP 是一种面向 LLM 的全局迭代结构化剪枝方法,它使用按块归一化并在结构层面聚合的、基于损失的一阶重要性分数,移除注意力头和 MLP 通道,将剪枝与目标损失绑定,而不是仅依赖逐层重构。
-
其迭代计划形成嵌套子网络,支持跨不同稀疏度层级的“一次剪枝、多处部署”工作流,同时任务感知校准可以使用困惑度进行语言建模,或使用基于边距的目标函数处理决策型任务。
-
在 Llama2-7B/13B、Llama3-8B 和 Mistral-0.3-7B 上的实验显示更低的 WikiText-2 困惑度和更高的下游准确率,尤其在 40% 到 50% 稀疏度下;针对 GSM8K 的任务对齐校准提高了 DeepSeek R1-Distill-Llama-3-8B 和 Qwen3-8B 的精确匹配准确率。
引言
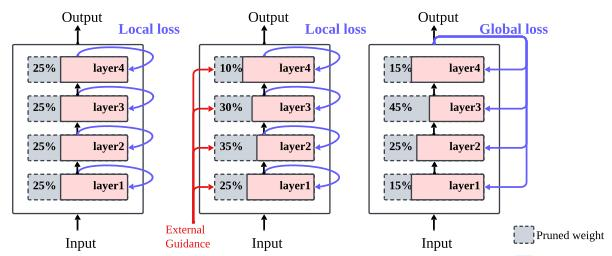
剪枝通过移除冗余参数来压缩大型语言模型,结构化剪枝尤其有用,因为它能够生成紧凑且对硬件友好的架构,在受限设备上高效运行。早期工作大多使用局部剪枝,将模型压缩分解为逐层重构问题;这简单高效,但任务无关,即使校准数据是任务特定的,也往往无法改善下游性能。非均匀局部变体削弱了这一弱点,但增加了算法复杂度,并仍然依赖层级代理指标而不是完整模型目标。作者利用全局剪枝,相对于模型级损失定义重要性,并提出 GISP,一种面向注意力头和 MLP 通道的全局迭代结构化剪枝框架。GISP 使用迭代、比例调度的剪枝,以在更高稀疏度下稳定性能,揭示了支持“一次剪枝、多处部署”工作流的嵌套子网络,并直接纳入任务感知目标,以获得更强的下游准确率。
方法
所提出的方法以结构化全局剪枝为中心。它不是逐层独立剪枝,而是相对于模型级损失估计注意力头和 MLP 通道的重要性,将所有候选结构统一排序,并在全局预算下移除最不重要的结构。作者首先分析一种朴素的单次剪枝版本,然后识别它在高稀疏度下变得不稳定的原因。这一分析促使他们最终提出 Global Iterative Structured Pruning,即 GISP。
单次剪枝流程从一个校准数据集开始
D={(xi,yi)}i=1N.对于每个权重元素,该方法计算由模型级损失导出的、基于损失的一阶重要性分数。在局部记号中,权重元素 w 的敏感度可写为
Iw=∣⟨∇wL,w⟩∣.这些元素级分数随后被聚合为结构级分数。一个结构要么是一个注意力头,要么是一个 MLP 通道。由于不同结构包含的权重元素数量不同,作者对聚合后的分数进行归一化,以便公平比较所有结构。他们还观察到,注意力块和 MLP 块的分数幅度可能差异显著,因此在这两个结构族内分别应用归一化。归一化之后,该方法对全部注意力头和 MLP 通道进行全局排序,选择分数最低的结构,并在目标剪枝比例 ρ 下将其剪除。
这一单次剪枝设置在不进行剪枝后微调的情况下评估。对每一步剪枝之后都进行微调,对大型语言模型而言成本高得难以承受,因此该方法作为训练后剪枝流程运行。单次剪枝策略在低剪枝比例下可能有效,但在高稀疏度下性能可能急剧下降。作者将这一限制归因于一个事实:一次性移除许多结构,会增加消除在模型已经改变之后仍然重要的权重或单元的风险。
为稳定高比例剪枝,作者将剪枝过程分解为多个较小的剪枝步骤。给定目标剪枝比例 ρ 和预定义迭代次数 n,GISP 在第 k 次迭代应用一个较小的增量比例 ρk。一个线性调度器跨迭代控制累积剪枝预算。在一种常见实现中,累积目标可写为
ρk=ρnk,因此,每一步移除大致相当数量的结构,同时总剪枝比例逐渐达到最终目标。这一迭代流程在每一步都利用已经剪枝模型的反馈,使方法能够在早期剪枝决策之后,进一步修正哪些结构真正冗余。
如下框架图所示:
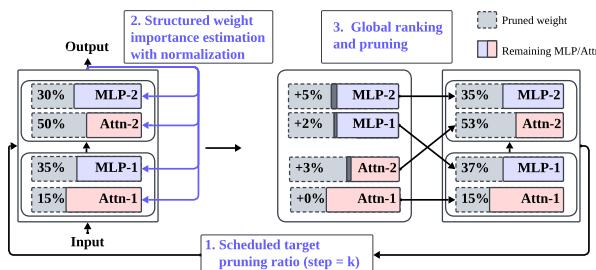
该框架将每次剪枝迭代组织为三个相互交互的阶段。首先,调度后的目标剪枝比例确定当前步骤需要移除多少结构。其次,该方法使用当前模型状态计算结构化权重重要性,并应用归一化,使注意力头和 MLP 通道能够在各自的结构组内比较。第三,该方法对所有候选结构进行全局排序,并剪除排名最低的结构。当前迭代得到的剪枝模型随后传入下一次迭代,在更新后的网络上重新计算重要性。
这种迭代设计产生嵌套的子网络序列。在每次迭代中,GISP 从已在之前步骤中剪枝过的模型里移除新的注意力头和 MLP 通道。因此,较低剪枝比例下的中间模型,自然地成为后续更稀疏模型的父子网络。这种嵌套属性赋予 GISP “一次完成”的能力。如果该方法朝一个较高目标比例运行一次,沿剪枝轨迹的中间模型可以直接作为较低稀疏度层级的可部署模型。作者表明,这些中间模型可以达到接近单独为每个目标比例运行较短剪枝流程所获得的困惑度数值。这对实际部署尤其有价值,因为一次剪枝运行可以产生一整个准确率与稀疏度之间的前沿,而不是单个固定子网络。因此,即使每次单独的剪枝运行可能比单次方法耗时更长,该迭代轨迹的成本也可以摊销到许多模型上。
该方法也自然扩展到任务特定剪枝。由于 GISP 相对于模型级目标估计重要性,而不是逐层重构损失,因此该目标可替换为下游任务目标。在一般形式中,重要性分数变为
IW=∣⟨∇WLtask,W⟩∣.对于文本生成或语言建模,Ltask 可以是 token 级交叉熵:
L=−N1i=1∑Nlogp(xi∣x<i),其中 p(xi∣x<i) 是在先前上下文条件下 token xi 的概率。该目标保持生成质量和困惑度行为。
对于多选问答或其他面向决策的任务,仅最小化正确答案上的困惑度可能不足。在此类任务中,模型通常按损失或困惑度对候选问答对排序,并选择得分最好的候选。如果剪枝降低错误候选损失的速度快于降低正确候选损失,决策边界可能移动,即使正确答案的损失在绝对意义上仍然有利,准确率也可能下降。为解决这个问题,作者定义了基于边距的重要性分数。令 L+ 表示正标签上的平均损失,L− 表示负标签上的平均损失。对于权重元素 Wij,重要性变为
IWij=(∂Wij∂L+−∂Wij∂L−)Wij.该分数优先选择有助于保持正确候选与错误候选之间损失差距的权重。通过这种方式,GISP 仍然是一个训练后、结构感知的剪枝框架,同时对齐实际任务目标,而不仅仅对齐通用语言模型重构。
实验
实验在多个 LLM 上评估 GISP,使用文本生成困惑度、常识推理、算术生成、消融实验和校准鲁棒性测试。这些研究表明,迭代全局剪枝能够稳定激进的结构化剪枝,产生更平滑的子网络轨迹,并优于代表性的局部基线,同时通过一次剪枝运行产生一系列一次完成的不同稀疏度。进一步分析证实了 GISP 的任务感知行为、微调后的更好适配能力,以及对有限或多样校准数据的鲁棒性。
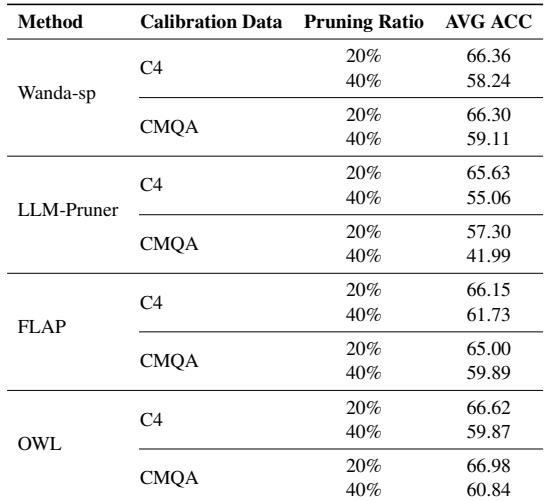
报告结果显示,局部剪枝准确率随剪枝比例增加而下降,并且在较高剪枝比例下退化更大。使用任务相关的校准数据集仅给局部剪枝带来有限增益,而且收益因方法而异,并非产生一致改进。局部剪枝从任务相关校准中获益不大。较高剪枝比例明显降低 CMQA 准确率。校准数据的影响在不同方法之间不同。
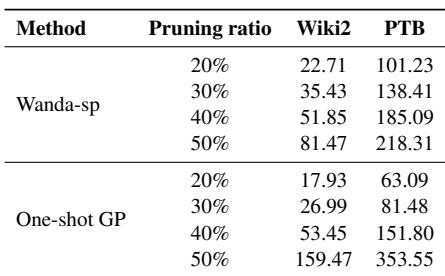
评估在递增的剪枝比例上比较单次全局剪枝与 Wanda-sp 在 WikiText-2 和 PTB 上的困惑度。单次全局剪枝在较低和中等稀疏度下表现出比 Wanda-sp 更低的困惑度,但随着剪枝更激烈,其优势变得不那么稳定。困惑度随更高剪枝比例而上升,表明这种单次方法在有限稀疏度范围内效果最佳。在两个数据集上的较低剪枝比例下,单次全局剪枝优于所比较的 Wanda-sp 基线。困惑度随剪枝比例增加而快速上升,显示在激进剪枝下稳定性下降。
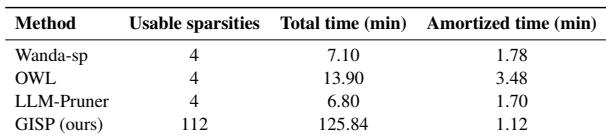
GISP 的总剪枝时间比所比较的局部剪枝方法更长,因为它执行迭代剪枝。然而,由于一次 GISP 运行产生许多可用稀疏度层级,其每个可部署子网络的摊销时间低于替代方案。剪枝轨迹中的中间模型呈现为有效子网络,减少了在每个稀疏度层级分别运行剪枝的需要。GISP 比所比较的剪枝方法产生多得多的可用稀疏度层级。尽管总运行时间更长,GISP 仍实现了更低的每个子网络摊销剪枝成本。一次 GISP 剪枝运行可以跨多个稀疏度层级产生有用子网络。
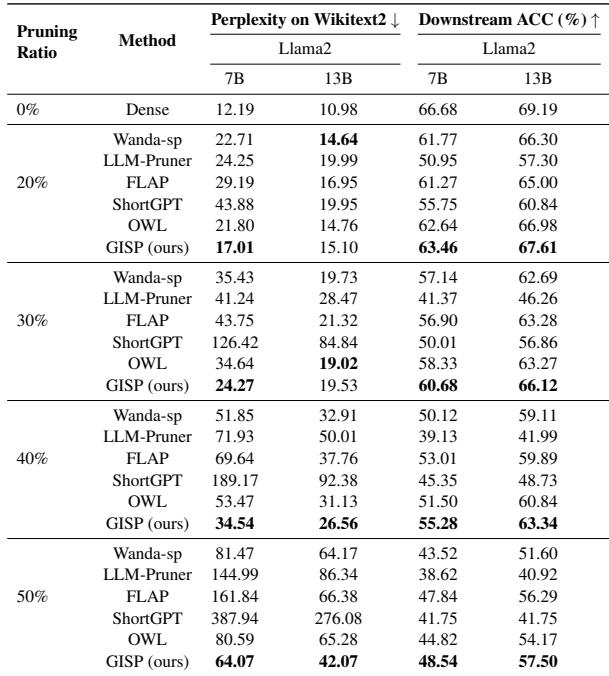
比较表明,GISP 通常比基线更好地保持文本生成质量,在测试模型和剪枝比例下获得更低的 WikiText2 困惑度。它也提高了 CMQA 上的常识推理准确率,优势在更高稀疏度层级更显著。这些趋势表明,任务特定校准有助于在剪枝后同时保持语言建模能力和下游推理性能。在 Llama2 模型上,GISP 往往比所比较的剪枝方法具有更低困惑度。GISP 在不同模型规模和剪枝比例下均获得更高的 CMQA 推理准确率。这一优势在更高剪枝层级尤其明显。
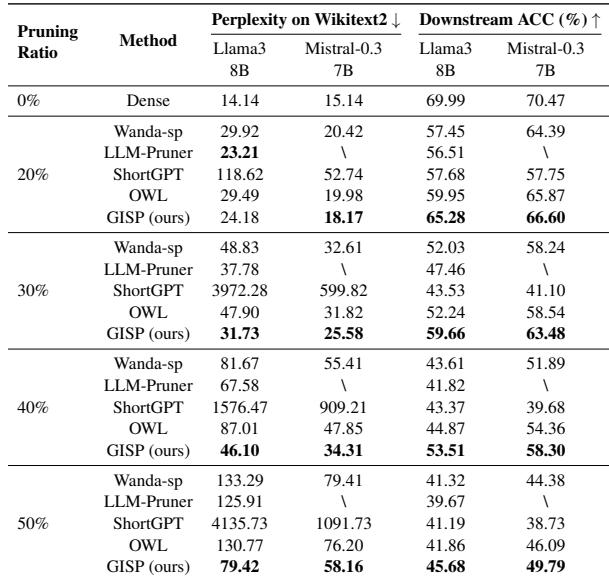
在 Llama3-8B 和 Mistral-0.3 上,所提出的剪枝方法在所展示的稀疏度下提供比较方法中最佳下游准确率,同时在 WikiText2 困惑度上保持竞争力。报告结果称,其优势在更高剪枝层级最强,表明随着模型被剪薄,任务相关能力得到更好保持。在所展示的 20% 剪枝比例下,该方法在 Llama3-8B 上的准确率高于 Wanda-sp、OWL、ShortGPT 和 LLM-Pruner,并在 Mistral-0.3 上高于可用基线。在困惑度方面,它优于 Wanda-sp、OWL 和 ShortGPT,不过 LLM-Pruner 在 Llama3-8B 上略低,这表明准确率是主要的一致优势。
实验在局部剪枝、单次全局剪枝、困惑度和推理任务等设置中评估剪枝行为,表明随着稀疏度增加,性能通常退化,而校准效应因方法而异。所提出的 GISP 方法显示能够从一次剪枝运行产生多个可用子网络,提高摊销效率,并比所比较的基线更好地保持语言建模质量和推理性能。总体而言,结果表明该方法在更高剪枝层级最具优势,在下游任务准确率上的增益强于仅在困惑度上的增益。