Command Palette
Search for a command to run...
句子加工中的记忆效率与资源理性编码
句子加工中的记忆效率与资源理性编码
Weijie Xu Brian Dillon Richard Futrell
摘要
越来越多的共识认为,语言模型(LM)若要成为人类语言加工的模型,就需要在使用上下文记忆方面加以限制,这种限制可类比于人类的工作记忆(WM)。本文采用一种新颖而简洁的方法来约束语言模型中的工作记忆,其思路反映了将记忆视为有限资源并策略性部署的人类认知模型。为了捕捉这种对记忆编码的约束,我们以可调比率向基于 Transformer 的 LM 的隐藏表示中注入噪声,并使用混合目标函数训练模型,使其在总编码精度的显式约束下最大化下一词预测性能。我们发现,显式的工作记忆约束改善了模型与人类阅读时间的对齐程度。更重要的是,管理编码精度的需求重塑了模型上下文表示的本质,使其更加压缩化和类别化。我们的结果表明,工作记忆分配的资源理性模型可以简单而成功地在神经模型中实现,并揭示了人类句子加工模型中工作记忆检索机制与底层记忆表示之间的分离现象。
一句话总结
来自加州大学欧文分校和马萨诸塞大学阿默斯特分校的研究者向基于 Transformer 的语言模型的隐藏表示中注入可调噪声,并使用约束总编码精度的混合目标进行训练,以模拟资源理性式的工作记忆分配;这带来了与人类阅读时间的更好匹配,以及更压缩、更具类别性的上下文表示。
核心贡献
- 为基于 Transformer 的语言模型添加工作记忆约束:向隐藏表示注入可调噪声,并使用混合目标训练,该目标在下一个词预测与编码精度显式限制之间进行平衡。
- 这些约束提升了与人类阅读时间的匹配程度,并使上下文表示更压缩、更具类别性,支持工作记忆分配的资源理性解释。
- 中等约束会增强注意力权重中的局部性偏好,更严格的约束会削弱这种偏好,从而揭示检索机制与编码表示之间的分离,并将工作记忆约束与量化联系起来。
引言
人类句子加工依赖工作记忆,因为早期词必须在不再直接可得时影响后续解释。由于人类工作记忆高度有限,理解这些约束如何塑造语言表示,对心理语言学以及构建更像人类的语言模型都重要。以往的计算工作主要通过人为设置来模拟工作记忆限制,例如更小的模型、更短的上下文窗口、偏向局部注意力,或对以往词进行二元擦除;但这些方法并不能直接解释有限资源如何影响存储在工作记忆中的信息质量。研究者转而将工作记忆约束视为表示精度限制,并表明更嘈杂、精度更低的工作记忆编码可以作为对语言预测需求的资源理性响应而出现。
方法
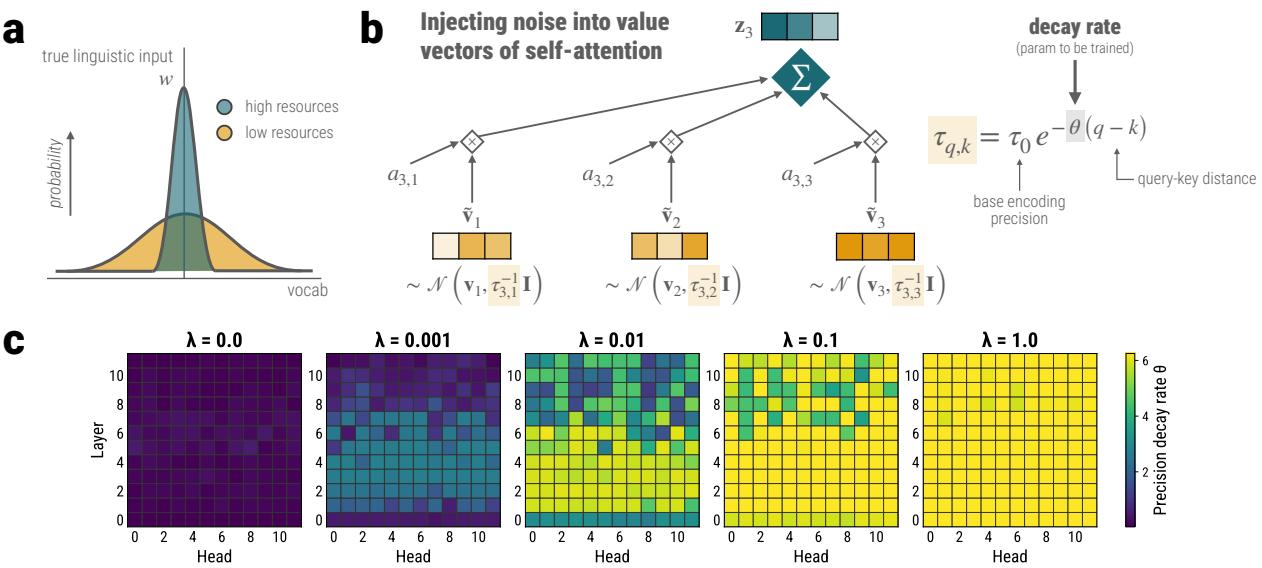
作者通过让内部工作记忆表示故意带有噪声,对基于 Transformer 的语言模型中的工作记忆约束建模。核心思想是,语言输入并非在工作记忆中被完美编码,而该编码的保真度取决于模型可用的工作记忆资源数量。在所提出框架中,工作记忆容量通过编码精度加以操作化,而精度则通过向自注意力使用的值向量注入高斯噪声来调节。
该方法建立在标准自注意力机制之上。通常,查询向量与键向量交互以确定注意力权重,这些权重随后用于聚合来自较早位置的值向量。为了建模不完美的工作记忆,作者会在聚合之前对每个历史值向量进行扰动。给定相对于当前查询位置 q 对应于先前键位置 k 的值向量 vqk,带噪值 v~qk 从高斯分布中采样:
v~qk∼N(vqk,τ−1I).这里,τ 表示编码精度,定义为方差的倒数。更高的精度对应更低的噪声,因此也对应更忠实的工作记忆表示。这将计算模型与信息论解释联系起来:带噪注意力通路表现得像具有有限信噪比的通信通道。拥有更多工作记忆资源的模型可以维持更高精度,而约束更紧的模型则在更强噪声下传递信息。
精度不会在所有过去的 tokens 上保持固定。相反,随着 token 与当前查询位置的距离增大,精度会指数衰减。相对于查询位置 q 的位置 k 处键 token 的精度为:
τqk=τ0e−θ(q−k).参数 θ 控制衰减速率,τ0 是最高可达精度,对应当前查询位置处的当前 token,其中 q−k=0。即使这一基础精度也是有限的,这反映了一个假设:编码永远不可能完全无噪声。这种设计使模型能够表示分级的工作记忆效应:近期信息以更高精度编码,而更远的信息则逐渐变得更嘈杂。
注意力头的输出随后使用标准 softmax 注意力权重聚合带噪值向量而形成:
zq=k∑aqkv~qk,其注意力权重为
aq=softmax(dK⊤q).为了高效优化这一随机注意力机制,作者采用重参数化技巧。注意力输出被分解为一个确定性分量和一个噪声分量:
zq=zqdet+z~q.确定性部分 zqdet 的计算方式与标准自注意力相同,如同没有噪声存在。噪声部分表示为缩放后的单位高斯:
z~q=σqϵ,ϵ∼N(0,I).假设来自不同先前 tokens 的噪声贡献彼此独立,则在注意力聚合后的有效方差为
σq2=k∑(aqkσqk)2=k∑aqk2τqk−1.这一表述在保持并行注意力计算的同时引入了位置相关的工作记忆噪声。作者专门向自注意力注入噪声,而不是在输出嵌入处注入噪声,因为自注意力最接近地对应从上下文中不同位置检索并组合表示的工作记忆过程。这也使得控制噪声作为存储 token 与当前查询位置之间相对距离的函数变得自然。
工作记忆约束随后通过混合损失函数在训练期间进行调节。模型并非仅针对语言建模准确率进行优化。相反,它必须在预测性能与维持精确工作记忆表示的成本之间取得平衡。训练目标为
L=cross-entropy loss−y∈S∑t=1∑Tlogp(yt∣y<t)+λmemory capacityh,l,t,k∑τh,l,t,kz−1,其中
z=LHT2T−1.第一项是训练样例上的标准下一个词预测损失。第二项对注意力头和各层中过去 tokens 的平均编码精度进行惩罚。该项代表模型使用的工作记忆资源量。标量 λ 控制工作记忆约束的强度。更大的 λ 会对高精度施加更强惩罚,促使模型以更少的工作记忆资源运行。因此,模型会学习语言预测性能与在记忆中对信息进行编码成本之间的权衡。
该设计形成了一种研究 Transformer 中工作记忆限制的统一方法。高斯噪声注入创建了工作记忆不完美的连续、分布化表示,而精度衰减函数引入了距离相关退化。混合训练目标则显式地塑造模型可分配多少高精度工作记忆资源,使工作记忆容量成为语言模型架构中的可控属性。
实验
实验评估了使用不同工作记忆约束训练的 GPT-2 式语言模型,检查学习到的精度衰减、与人类阅读时间的匹配,以及下一个词预测空间的几何结构。随着工作记忆约束增强,模型在不同层之间表现出不对称的精度衰减,并在中等约束水平上生成与人类阅读行为更匹配的预测,尽管困惑度更高,且极端意外度估计降低。更强的约束还会压缩预测空间,并促进更具类别性的编码,表明从细粒度区分转向更宽泛的语义泛化。