Command Palette
Search for a command to run...
重新思考 RLVR 中的熵干预:一种熵变化视角
重新思考 RLVR 中的熵干预:一种熵变化视角
Zhezheng Hao Hong Wang Haoyang Liu Jian Luo Jiarui Yu Hande Dong Qiang Lin Can Wang Jiawei Chen
摘要
具有可验证奖励的强化学习(RLVR)已成为大型语言模型(LLM)推理能力提升的关键驱动力,然而其训练常常受到熵崩溃的困扰——策略熵的快速下降限制了探索并削弱了训练效果。近期方法尝试通过各种启发式熵干预来缓解这一问题,但对其影响熵的机制尚未得到充分理解。在本工作中,我们对 RLVR 中的熵动态进行了全面的理论和实证分析,提供了两个主要见解:(1)我们推导了每次更新步骤中 token 级熵变化的近似表达式,揭示了四个控制因素,并为现有方法如何影响熵提供了统一视角;(2)我们展示了近期方法的一个根本局限性——它们依赖于对其中一两个因素的启发式调整,而忽略了其他相关因素,从而本质上限制了其有效性。在这些分析的指导下,我们引入了 STEER,一种基于熵变化估计对 token 进行自适应重新加权的原则性熵调节方法。在六个数学推理基准和三个编码基准上的实验表明,STEER 有效缓解了熵崩溃,并持续优于最先进的基线方法。
一句话总结
来自浙江大学、腾讯和一位独立研究员的研究者提出了 STEER,一种基于原则的熵调制方法,用于可验证奖励强化学习(RLVR)。该方法推导出近似的 token 级熵变化表达式,识别出四个主导因素,揭示了先前熵干预方法的启发式局限性,并自适应地重新加权 token 以缓解熵崩溃,在六个数学和三个编码基准测试中持续优于最先进的基线方法。
核心贡献
- 推导出 RLVR 中每个策略更新步骤的 token 级熵变化的近似表达式,识别出四个主导因素:裁剪策略、优势、token 概率和条件熵。这为解释现有熵干预方法如何影响这些因素提供了统一框架。
- 揭示了现有熵缓解方法的根本局限:它们仅对四个已识别因素中的一个或两个进行启发式调整,未考虑其他相关因素,这从根本上限制了它们在防止熵崩溃方面的有效性。
- 引入了 STEER,一种基于原则的熵调制方法,根据估计的熵变化自适应地重新加权 token。在六个数学推理和三个编码基准上的实验表明,STEER 能缓解熵崩溃并持续优于最先进的基线方法。
引言
大语言模型展现出强大的推理能力,其中一个关键驱动因素是可验证奖励强化学习(RLVR),它使用 PPO 和 GRPO 等策略梯度算法,根据可验证的奖励信号优化策略。这种方法一直是推理能力后训练扩展的核心。然而,一个主要问题是熵崩溃,即训练期间策略熵快速下降,削弱探索能力并使 rollout 变得同质化。在基于组的方法(如 GRPO)中,这会降低优势分数的区分能力并使训练停滞。现有的缓解策略(如 Clip-Higher、Positive-Reweighting 和 Entropy-Aware Advantage)大多是启发式的,其机制尚未被充分理解,因此有效性有限,熵仍难以控制。
作者对 token 级熵动态进行了基于原则的分析,推导出由四个因素控制的熵变化近似表达式:裁剪策略、优势、token 概率和条件熵。他们展示了现有方法如何影响这些因素并识别出局限性,包括先前方法仅对一小部分 token 进行调制且只考虑部分因素。基于此,他们引入了 STEER(通过重新加权稳定 token 级熵变化),自适应地降低具有较大熵变化的 token 的权重,以调节每步熵动态并维持探索。在六个数学和三个编码基准上的实验表明,STEER 优于 10 个基线方法,并能推广到不同的模型规模、模型家族和 RL 算法。
方法
作者建立了一个理论框架,用于量化验证强化学习(RLVR)更新过程中 token 级熵动态。通过分析 Group Relative Policy Optimization(GRPO)算法的策略梯度,他们推导出每个 token 熵变化的近似表达式,记为 Ω(s)。该指标揭示了熵演化同时受裁剪指示器、优势信号、旧策略概率、当前 token 概率 πθ 和状态熵 H(s) 的共同影响。
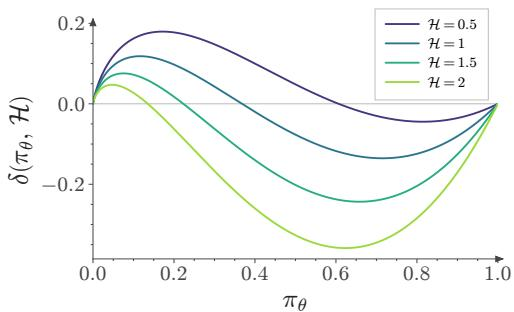
为了说明 token 概率与状态熵之间的相互作用,作者定义了函数 δ(πθ,H),用于捕捉这些特定项对整体熵变化的贡献。该函数的行为在不同熵水平下被可视化,展示了生成概率与熵之间的相互作用如何决定策略分布是变得更集中还是更均匀。
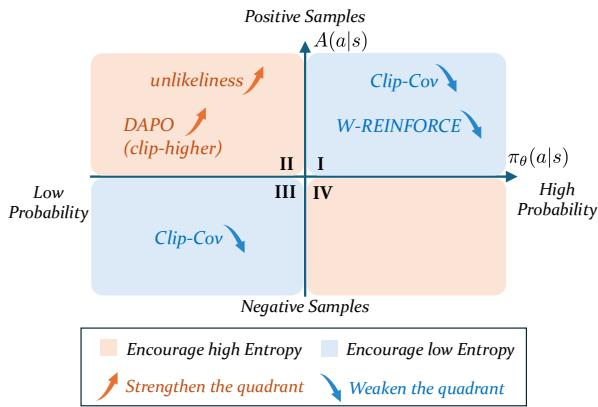
在上述定量分析的基础上,作者将 token 更新分为优势-概率空间中的四个不同定性象限。该框架阐明了训练过程中相互竞争的力量:象限 I 代表利用行为,其中正确输出中的高概率 token 降低熵;象限 II 对应探索行为,其中正确输出中的低概率 token 增加熵;象限 III 涉及抑制行为,其中错误输出中的低概率 token 降低熵;象限 IV 表示错误修正,其中错误输出中的高概率 token 增加熵。熵崩溃被理解为象限 I 和 III 中的熵降低力量压倒了象限 II 和 IV 中的熵增加力量的状态。
为了解决这些竞争动态所引发的不稳定性,作者提出了一种名为 STEER(通过重新加权稳定 token 级熵变化)的方法。该方法为每个 token 引入自适应权重 λ(s),将其熵变化从 Ω(s) 调制为 λ(s)Ω(s)。该权重基于归一化熵变化的大小使用指数衰减函数计算:
λ(s)=exp(−αmaxs∈B∣Ω(s)∣∣Ω(s)∣)其中,α 控制衰减速率,有效地将熵变化映射到 [λmin,1] 范围。通过衰减具有较大熵变化(无论是增加还是减少)的 token,STEER 稳定了训练动态,防止策略坍缩为低熵状态,同时保持足够的探索能力。
实验
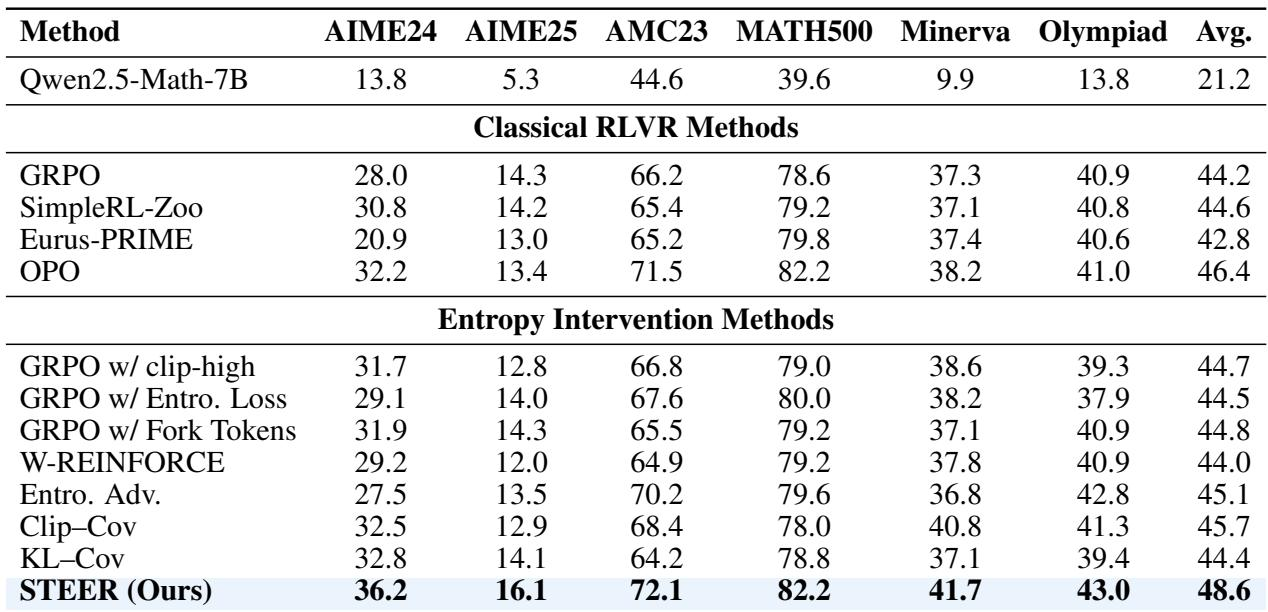
评估涵盖六个基准的数学推理和三个基准的编码任务,将 STEER 与包括 GRPO、OPO 和 Clip-Cov 在内的十个基线方法进行比较。STEER 在数学推理上持续优于所有基线方法,平均性能比第二好的方法提高 2.2 个百分点,并且在编码任务上在不同模型规模下至少比 GRPO 高 1%。在极端熵场景下,基线方法会出现熵崩溃或不可控的熵增加,而 STEER 保持稳定的熵并达到最高准确率。该方法还能推广到多种模型架构、规模和 RLVR 算法,包括 RLOO 和 OPO。
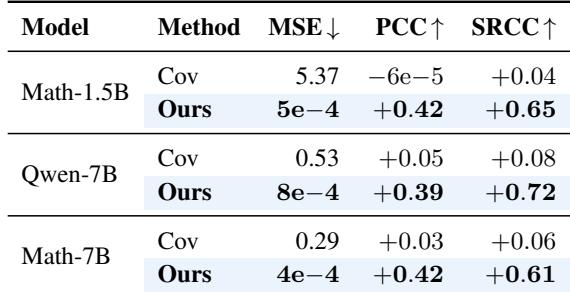
该表在三个模型上比较了协方差估计与所提出方法。所提出方法持续产生更低的均方误差和显著更高的正相关系数,而协方差估计则显示出接近零或可忽略的相关性。总体而言,所提出方法为每 token 熵变化提供了更可靠的定量刻画。在所有测试模型上,所提出方法相比协方差估计将均方误差降低了若干数量级。相关性指标(PCC 和 SRCC)在协方差估计下接近零或略微为正,但在所提出方法下变为强正相关。改进在不同模型规模上保持一致,表明熵干预机制具有良好的泛化能力。
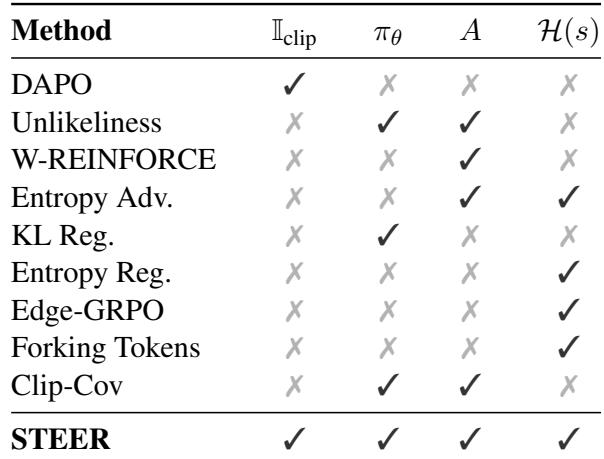
该表比较了熵干预方法如何纳入裁剪、策略概率、优势和状态熵等因素,揭示了每种现有方法仅覆盖其中一部分。相比之下,所提出方法显式地调节熵以维持稳定的训练动态,并在数学推理、编码和泛化设置中持续优于基线方法。STEER 防止熵崩溃或过度不确定性,在初始下降后实现稳定的熵,这与其他方法不同。即使在几乎不进行比例裁剪的极端条件下,STEER 仍保持相对稳定的性能和测试集上的最高准确率。STEER 在不同主干模型和 RL 算法上均带来一致的改进,表明其广泛的适用性。
STEER 在数学推理基准上持续优于所有基线方法,取得最高平均分数。它比第二好的方法高 2.2 分,比第三好的方法高 2.9 分,并且在每个数据集上都观察到改进。这些增益归因于显式的熵调节,保留了对信息量更大的轨迹的探索空间。STEER 在所有列出的数学推理数据集上取得最高平均性能。STEER 将平均准确率比第二名提高 2.2 个百分点,比第三名提高 2.9 个百分点。
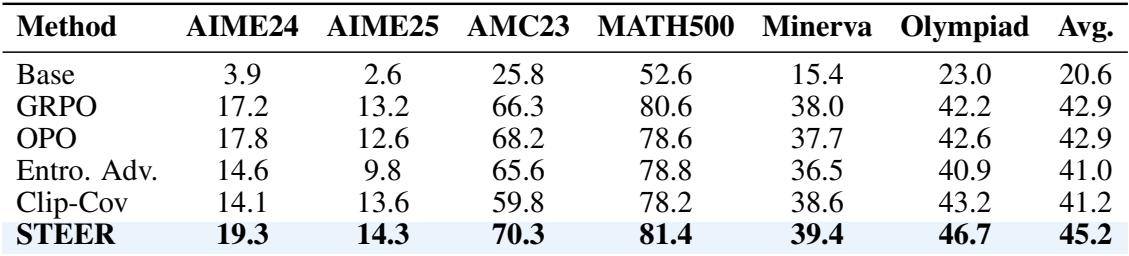
在 Qwen2.5-14B 上,STEER 在每个数学推理数据集上都超越了所有基线方法,取得最高平均性能。它持续领先于强大的 RLVR 和熵干预基线,表明在数学推理任务中具有稳健的泛化能力。STEER 取得 45.2% 的最高平均分数,领先于所有竞争方法。STEER 平均比第二好的方法(OPO)高出约 2 分。STEER 在 AIME24、AMC23 和 MATH500 等单个数据集上记录了最高分数。
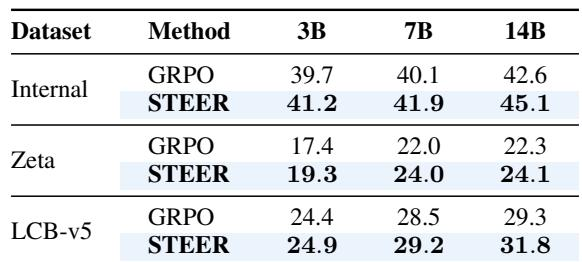
该表在三种 Qwen2.5-coder 模型规模上将 STEER 与 GRPO 在真实编码任务上进行比较。STEER 在每个数据集和模型配置上都持续优于 GRPO,改进至少一个百分点,在 14B 规模上通常有更大增益。STEER 在所有三个数据集和所有三种模型规模上都取得比 GRPO 更高的分数。性能优势在 14B 模型上更为明显,表明在更大骨干模型上具有更好的可扩展性。
所提出的熵估计方法在所有测试模型上持续优于协方差估计,产生远更低的均方误差和强正相关,而协方差估计则显示接近零或可忽略的相关性。STEER 作为所提出的熵干预方法,显式调节熵以维持稳定的训练动态,并在数学推理、编码和泛化任务上优于现有基线,在不同骨干模型、模型规模和 RL 算法上显示出稳健的改进。在数学推理基准上,STEER 取得最高平均准确率,超过第二好的方法两分以上;在编码任务上,它持续在所有测试模型规模上击败 GRPO,且在更大规模上有更大增益。这些结果证实了所提出方法的可靠性和广泛适用性。