Command Palette
Search for a command to run...
CURE:基于批判驱动的统一强化学习用于测试时自我改进
CURE:基于批判驱动的统一强化学习用于测试时自我改进
Guirong Chen Shuqi Ye Wenkai Yang Shiqi Shen Guangyao Shen Yankai Lin
摘要
大语言模型(LLMs)的演进范式正从扩展训练计算量转向扩展推理时计算量。虽然基于可验证奖励的强化学习(RLVR)已成为这一转变的关键引擎,但标准方法往往无法赋予模型进行测试时扩展所需的自主改进能力。现有的批判引导方法试图通过利用外部反馈或真实信号来缓解这一问题;然而,这些依赖在测试时不可用,从根本上限制了模型持续自我改进的能力。为弥合这一差距,我们提出了 CURE(批判驱动的统一强化学习),一个将单一策略联合优化用于标准求解、批判和引导性重新探索的框架。独特的是,CURE 通过生成战略性提示同时丢弃初始错误解来促进重新探索,以减轻锚定偏差。在多种数学推理和代码生成基准上的实证结果表明,CURE 不仅保持了具有竞争力的单轮性能,更重要的是解锁了有效的推理时扩展,使模型通过迭代自我改进显著提升准确性。
一句话总结
中国人民大学和腾讯的研究人员提出了CURE(批判驱动的统一强化学习,Critique-driven Unified REinforcement Learning)框架,该框架联合优化单个策略,使其具备求解、批判和引导式再探索能力。该框架在生成策略性提示的同时丢弃初始的错误解答,以减轻锚定偏差,从而在多种数学推理和代码生成基准上实现有效的测试时自我改进。
核心贡献
- CURE(批判驱动的统一强化学习)是一个联合优化单个策略的求解、批判和引导式再探索能力的框架,使其无需外部监督即可实现自主测试时自我改进。
- 为减轻锚定偏差,CURE在生成高层级策略性提示的同时丢弃初始的错误解答,然后在仅以这些提示为条件的新状态下重新开始推理。
- 在数学和代码基准上的实验表明,CURE在具备有效推理时扩展能力的同时保持了有竞争力的单轮性能;在AIME25上,CURE在第二轮提升了2.8%,并通过迭代自我改进实现了4.2%的总提升。
引言
大语言模型领域正在从扩展训练时计算转向扩展测试时计算,其中出现了两种范式:并行扩展(parallel scaling),即采样并评估多个候选解答;以及顺序扩展(sequential scaling),即通过带可验证奖励的强化学习来扩展思维链推理。然而,这两种方法都难以支持类似人类的迭代式改进。并行扩展仅仅是采样独立的解答而不对其进行改进,而顺序扩展模型在可靠的自我验证和纠正方面存在困难,因为这些能力在训练过程中并未得到显式优化。此前的批判引导方法尝试通过外部反馈来解决这一问题,但这类方法依赖于不切实际的更强监督,或依赖于测试时无法获得的真实信号,从而破坏了自我改进的闭环。
为弥合这一差距,作者提出了CURE,这是一个统一的强化学习框架,在单个策略内联合优化三种原子能力:求解、批判和批判引导的再探索。一个关键的设计选择是,在再生成过程中,模型丢弃其初始的错误解答,仅以高层级策略性提示为条件,这有助于减轻锚定偏差并防止重复先前的错误。作者将这些能力整合到一个统一的RLVR流程中,其中求解通过回放成功的再探索轨迹得到增强,批判通过基于验证判断的监督学习以及延迟的基于准确率的奖励进行优化,而再探索则被对齐以遵循生成的提示。在数学和代码任务上的实验表明,CURE在保持有竞争力单轮性能的同时实现了优越的推理时可扩展性,在AIME25上通过迭代自我改进获得了4.2%的总提升。这项工作证明了无需外部依赖即可将自包含的改进闭环注入大语言模型。
方法
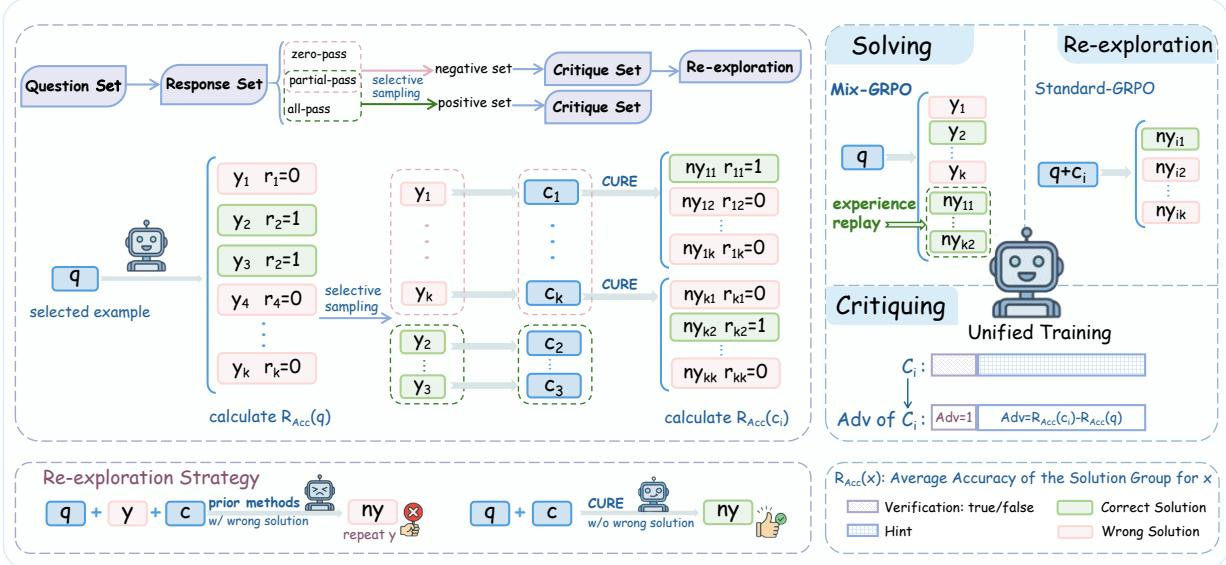
作者提出了批判驱动的统一强化学习(CURE)框架,将求解、批判和批判引导的再探索整合到单个统一策略中。该设计通过训练模型验证自身输出并生成策略性提示来实现自主自我改进,且不依赖外部监督。如框架图所示,训练过程通过迭代的在线强化学习循环运行,联合优化这些能力。
每次训练迭代分为三个不同阶段。在初始解答生成阶段,策略针对给定查询采样一组K个响应,并使用结果验证器对其进行评估以获得二元奖励。随后,批判生成阶段采用选择性采样策略来构建批判批次。系统根据组级准确率对查询进行分类,优先处理零通过和部分通过的实例,在这些实例中模型要么完全失败,要么表现出不一致性。为保持训练稳定性并防止琐碎的验证模式,批次强制保持正确与错误样本的均衡比例。对于每个选定的样本,模型生成一条批判,包含一个验证判断和一个策略性提示。
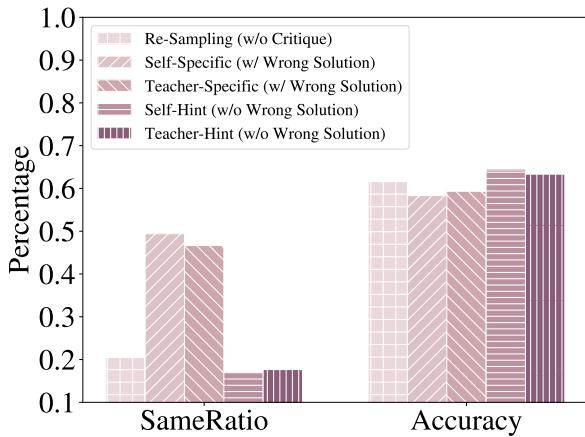
第三阶段,即批判引导的再生成,利用策略性提示作为探索的脚手架。系统通过将原始查询与生成的提示拼接来构建引导提示,同时有意丢弃初始的错误解答。这种方法减轻了锚定偏差,这是自我纠正范式中的一个常见问题,即附加有缺陷的推理轨迹会导致重复性错误。如下图所示,移除错误上下文显著减少了错误答案的重复,并提高了整体再生成的准确率。
为优化模型,作者构建了一个统一的训练目标,使用组相对策略优化(GRPO)将标准求解、批判和引导求解任务结合起来。求解目标引入了经验回放机制。来自再探索阶段成功的引导解答被选择性地合并回初始解答组。这种增强通过提高组平均奖励来重新校准优势函数,从而为原始错误解答分配强负优势,为回放轨迹分配正优势。
批判目标采用了自适应于token段的混合优势函数。对于验证段,分配固定的正优势,有效将任务转化为监督优化以确保准确的判断基准。对于提示段,通过从总批判奖励中减去基线平均准确率来计算居中优势。这种对比信号仅在提示带来性能提升时产生正优势,从而有效抑制无帮助文本的生成。最后,引导求解目标优化策略以生成以提示为条件的推理路径,确保遵循模型自身的策略性建议。整体优化在每个子任务组内独立计算优势,对生成的tokens上的损失取平均,并以相等权重对各任务损失求和,以防止联合训练中的破坏性干扰。
实验
CURE在数学推理和代码生成任务上使用指令微调模型和基础模型进行评估,以GRPO基线为对照,并为两个领域采用统一的训练设置。该方法在单轮准确率上与基线持平或略有提升,但其主要优势在于实现有效的推理时自我改进,其中迭代式精炼在基线趋于停滞的情况下持续获得增益。分析表明,CURE在训练过程中逐步将困难失败转化为成功,消融实验证实验证和提示优化对于扩展都至关重要,而仅回放来自先前零通过组中成功的引导解答可提供最佳的稳定性和性能。
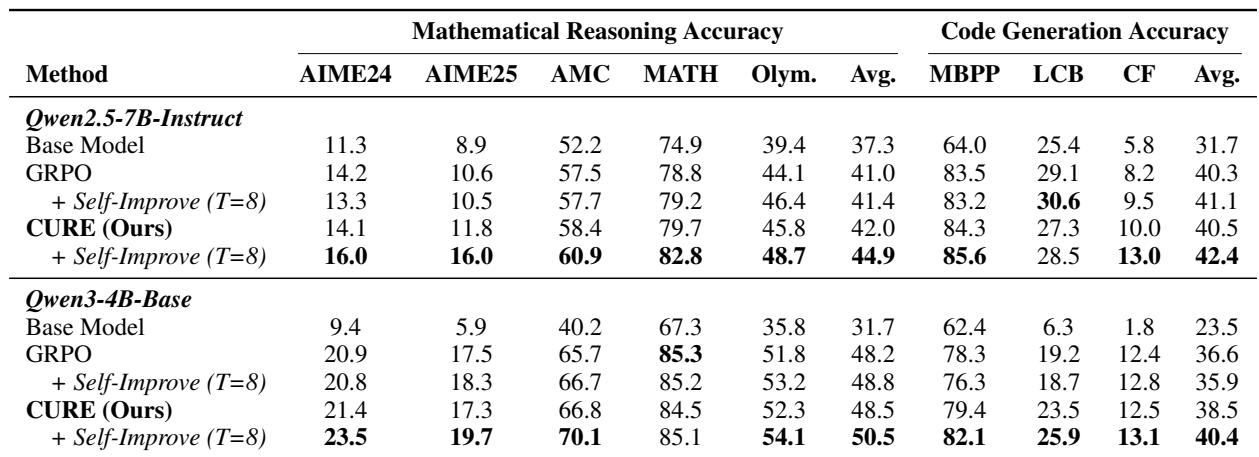
CURE在数学和代码基准上实现了与GRPO基线相当或更优的单轮准确率,其主要优势来自推理时自我改进带来的持续提升。在Qwen2.5-7B-Instruct上,迭代自我改进将CURE的平均数学准确率从42.0%提升至44.9%,超越了基线的扩展上限。这些增益与领域无关,在CodeForces上的提升相比GRPO尤为显著。CURE通过自我改进将平均数学准确率从42.0%提升至44.9%,超过了GRPO基线41.4%的上限。在CodeForces上,CURE通过自我改进获得+3.0%的提升,而GRPO仅为+1.3%,这表明其具有更强的测试时扩展能力。CURE在保持有竞争力单轮准确率的同时,在数学和编程任务上均实现了有效的迭代精炼。
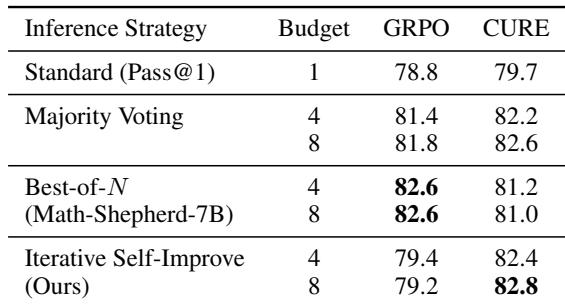
在匹配的预算下,CURE在标准解码、多数投票和迭代自我改进方面始终优于GRPO。然而,在使用外部奖励模型的Best-of-N设置下,CURE的性能低于GRPO,这可能是由于奖励模型的分布偏移所致。CURE的迭代自我改进在最大预算下取得了最高准确率。在多数投票和迭代自我改进中,CURE在两个预算水平上的表现均优于GRPO。在使用Math-Shepherd-7B的Best-of-N设置下,CURE的表现不如GRPO,准确率随预算增加而下降。整体最佳结果为预算为8的CURE迭代自我改进,达到了82.8%。
在相同的最大生成预算下,采用迭代自我改进的CURE相比采用Best-of-N的GRPO实现了略高的准确率,同时生成的tokens数量大幅减少,延迟相当。这表明CURE将额外的推理时计算用于高效的自我精炼,而非增加并行采样。CURE的迭代精炼相比使用外部奖励模型的Best-of-N获得了略优的准确率。CURE生成的tokens数量远少于Best-of-N,但在该设置下延迟几乎相同。token效率优势表明计算被更有效地转化为有针对性的改进。
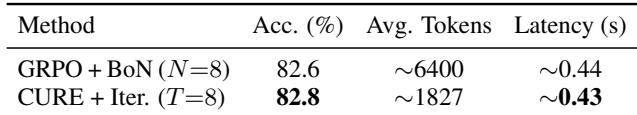
CURE在单轮数学和代码任务上与GRPO基线相当或更优,同时通过推理时自我改进带来了显著提升,将平均数学准确率从42.0%提升至44.9%,而GRPO的上限为41.4%,且在CodeForces上表现出更强的增益。在受控预算下,CURE在标准解码、多数投票和迭代自我改进中均优于GRPO,尽管由于分布偏移,在使用外部奖励模型的Best-of-N设置下有所落后,预算为8的迭代自我改进取得了整体最佳结果(82.8%)。此外,CURE相比采用Best-of-N的GRPO实现了相当或更优的准确率,同时生成的tokens数量大幅减少且延迟相似,这表明其计算资源被用于高效的自我精炼,而非扩展并行采样。