Command Palette
Search for a command to run...
像人一样阅读:通过并行化精读与略读压缩上下文
像人一样阅读:通过并行化精读与略读压缩上下文
摘要
大型语言模型(LLM)在多种任务中展现出卓越的能力。然而,它们在长上下文场景中的部署面临着计算效率低下和信息冗余两大挑战。我们提出了 RAM(Read As HuMan),一种采用自适应混合阅读策略的上下文压缩框架,以应对这些挑战。受人类阅读行为(即精读重要内容而略读不太相关的内容)的启发,RAM 将上下文划分为多个片段,并将它们与输入查询并行编码。高相关性的片段被完全保留(精读),而低相关性的片段则通过查询引导压缩为紧凑的摘要向量(略读)。显式的文本片段和隐式的摘要向量被拼接后送入解码器,以实现优越的性能和自然语言格式的可解释性。为了优化精读与略读之间的决策边界,我们进一步引入了一种基于正负查询-片段对的对比学习目标。实验表明,RAM 在两个主干网络上的多个问答和摘要基准测试中优于现有基线,同时在长输入(平均长度 16K;最大长度 32K)上实现了高达 12 倍的端到端加速。
一句话总结
来自清华大学、阿里巴巴和东北大学的研究人员提出了 RAM,一种上下文压缩框架,采用受人类启发的混合阅读策略,将上下文划分为多个分段并与输入查询并行编码,完全保留高相关分段(精读),同时将低相关分段压缩为查询引导的摘要向量(略读),并通过对比学习目标优化精读/略读的决策边界,在两个主干模型上的问答和摘要基准测试中取得了优越性能,在长输入上实现了高达 12× 的端到端加速(平均长度 16K;最大长度 32K)。
核心贡献
-
RAM 是一种上下文压缩框架,通过将上下文划分为分段并与输入查询并行编码每个分段,将显式文本分段和隐式摘要向量相结合,完全保留高相关分段,同时通过查询引导的摘要压缩低相关分段。
-
对比学习目标通过正负样本对建模查询-分段相关性,使得精读和略读之间的决策边界更加稳健,并提升了压缩质量。
-
在两个主干模型上的多个问答和摘要基准测试中,RAM 优于现有基线方法,与轻量级基线 Provence 相比,在长输入上实现了高达 12 倍的端到端加速(平均长度 16K;最大长度 32K)。
引言
大语言模型(LLMs)已经变革了自然语言处理领域,但检索增强生成(RAG)等提示工程技术的日益普及使得输入提示现在通常包含数万个token。在这些长上下文场景中部署大语言模型会带来两个核心问题:Transformer 架构中自注意力的二次时间复杂度使计算效率越来越低,而且自然语言固有的冗余性在长文本中会被放大,从而降低模型性能。
上下文压缩作为一种有前景的解决方案应运而生,通过缩短序列长度和过滤不相关内容来解决问题。现有方法分为两类。任务无关方法在没有查询引导的情况下进行压缩,这可能会丢弃与查询相关的信息。任务感知方法使用查询来引导压缩并保留关键信息,但它们面临自身的障碍:大多数方法要么一次处理整个长上下文,要么依赖自回归压缩,这两种方法计算成本都很高,而且在保留关键细节和保持输出可解释性之间难以权衡。一些方法直接剪除低相关token,这牺牲了信息,而另一些方法则将上下文压缩为隐式语义向量,失去了用户可以检查的自然语言格式。
作者借鉴认知科学,模拟人类阅读行为来解决这些局限性,人类会精读与当前目标相关的内容,同时略读背景信息。他们提出了 RAM(Read As HuMan),将上下文压缩形式化为一种混合阅读策略。RAM 将长上下文划分为多个分段,并与输入查询并行处理所有分段,避免了全序列加载或自回归压缩的效率瓶颈。然后,它根据查询相关性自适应地处理每个分段:高相关分段以自然语言完整保留以保存关键信息,而低相关分段则被压缩为紧凑的、查询引导的隐式摘要向量,仅捕获语义要点。这些显式和隐式表示被拼接为供解码器使用的混合上下文表示。为了区分两种阅读模式,作者引入了基于标注的正负查询-分段对的对比学习目标。在两个主干模型的不同压缩预算下,RAM 在多个问答和摘要基准测试中取得了优越性能,与轻量级基线相比,在长输入上实现了约 12 倍的端到端加速(平均长度 16K,最大长度 32K)。
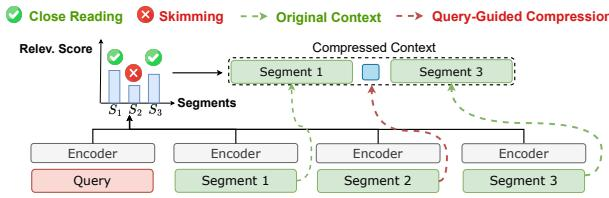
方法
作者提出了 RAM,一种新颖的上下文压缩框架,模拟人类阅读行为:对高相关分段进行精读,同时通过查询引导的压缩对低相关分段进行略读。RAM 在编码器-解码器架构内运行,包含两个核心阶段:查询感知的上下文分段并行编码,以及自适应压缩和训练。这种设计避免了全序列注意力的二次成本,也消除了迭代压缩的需要。
3.1 查询感知并行编码
给定查询 Q 和划分为 N 个等长块 {S1,S2,…,SN} 的长上下文 C,RAM 使用共享编码器并行处理所有分段与查询。原始输入序列 {S1,S2,…,SN,Q} 通过可训练的大语言模型编码器(例如 LLaMA 或 Qwen)获得上下文相关的隐藏状态。设 H 为最后一层隐藏状态。
对于每个文本序列,通过对其最后隐藏状态进行均值池化来构建紧凑表示。对于长度为 Lseg 的分段 Si,其表示为:
ri=Lseg1j=1∑Lseghi,j,其中 hi,j 是 Si 中第 j 个token的最后一层隐藏状态。查询表示 rq 通过对查询token的隐藏状态进行均值池化来类似地获得。这种并行编码步骤确保查询与每个分段独立地进行上下文关联,无需全序列注意力即可提供相关性信号。
3.2 自适应压缩与训练
基于与查询的相关性,RAM 动态决定是逐字保留每个分段("精读")还是将其压缩为单个向量("略读"),由可学习的选择机制引导。
查询引导注意力
每个分段与查询的相关性通过 rq 与每个 ri 之间的余弦相似度计算,随后通过 softmax 获得分段概率:
pi=∑jexp(rq⊤rj/τ)exp(rq⊤ri/τ),其中 τ 是温度参数。给定采样的压缩率 α(从 {2,4,8,16,32} 中采样),完全保留的分段数量 k 由以下公式确定:
k=⌊αLsegLorg⌋,其中 Lorg 是原始输入的token长度。具有最高 pi 的前 k 个分段被选择用于逐字保留;其余分段被压缩。
查询引导压缩(略读)
对于标记为略读的分段,计算查询感知的token隐藏状态加权平均:
wi,tci=softmaxt(cos(hi,t,rq)),=t=1∑Lsegwi,thi,t,其中 cos(⋅,⋅) 表示余弦相似度。这为每个略读分段产生单个嵌入 ci∈Rd,其中 d 是隐藏维度。
混合压缩表示构建
设 K⊆{1,…,N} 表示被选为精读的分段索引集合,Kˉ 为其补集。对于每个分段 i,对压缩上下文表示的贡献为:
M~i=I{i∈K}⋅e(Si)+I{i∈Kˉ}⋅Walignci,其中 e(⋅) 表示解码器大语言模型中的词嵌入查找,ci 是查询引导的压缩向量,Walign∈Rd×d 是仅应用于略读分段的可训练语义对齐矩阵,用于弥合显式token与隐式向量之间的表示差距。指示符 I{⋅} 为每个分段选择适当的表示路径。通过按原始顺序拼接所有分段表示来形成最终的压缩上下文:
M=[M~1;M~2;…;M~N]∈RLc×d,其中 Lc=∑i∈KLseg+∣Kˉ∣ 是压缩后的总长度。这种混合表示保留了高相关分段的逐字token,同时将低相关分段替换为紧凑的查询引导摘要,实现了保真度和效率的双重目标。
训练目标
压缩记忆 M 与查询嵌入和答案token拼接,然后输入解码器进行标准的教师强制语言建模。设 Y=[y1,…,yNa] 表示答案token序列。语言建模损失为:
Lnll=−Na1t=1∑NalogP(yt∣y<t,M,Q),其中 P(yt∣⋅) 从 softmax 归一化的 logits 中导出,损失仅在答案位置上计算。
为了提高相关性判别能力,在训练中引入了对比损失。给定真实的正/负分段标签(例如,来自答案跨度标注),该损失鼓励查询与正分段之间的相似度更高,与负分段之间的相似度更低:
Lcon=−∣P∣1i∈P∑log∑j=1Nexp(cos(rq,rj)/τ)exp(cos(rq,ri)/τ),其中 P 是正分段索引的集合,τ 是与查询引导注意力中使用的相同温度参数。总训练目标结合了两项:
LRAM=Lnll+Lcon.这种设计使 RAM 能够实现高压缩效率、强任务性能和自然语言格式的可解释性。
效率分析
通过将长上下文分段化并与查询并行编码每个分段,然后通过轻量级压缩"略读"低相关分段,RAM 从根本上避免了传统方法的瓶颈,这些传统方法要么一次性处理完整输入,要么依赖自回归迭代。整个流水线由两个阶段组成:(1) 压缩阶段,包括查询感知并行编码和自适应压缩,以及 (2) 解码阶段,其浮点运算(FLOPs)可以分别建模。
压缩阶段
该阶段涉及两个核心组件。首先,长度为 Lorg 的原始上下文 C 被分割为 N 个分段,每个分段与查询 Q(长度为 Lq)并行编码。其次,查询引导注意力机制为每个分段计算相关性分数,以决定是原样保留还是将其压缩为紧凑向量。压缩的分段通过轻量级操作(例如,加权平均)聚合成单个摘要向量。设 Lc 表示输入到解码器的总有效长度(即保留的token长度与略读向量数量之和),α=Lc/Lorg 为压缩比。该阶段的 FLOPs 为:
FLOPscomp=FParaEnc(Q,C)+FQueryAttn(Q,R),其中 FParaEnc(Q,C) 表示并行编码的成本。由于每个分段的长度为 Lseg 并且独立处理,其复杂度为 O(N⋅Lseg2)=O(Lseg⋅Lorg),这远低于全序列编码的 O(Lorg2) 成本(注意 N⋅Lseg=Lorg 且 Lseg≪Lorg)。同时,FQueryAttn(Q,R)(在 N 个相关性分数上执行查询引导注意力的成本)仅产生 O(N) 的计算开销,与分段数量呈线性关系。
解码阶段
假设生成的答案长度为 La,解码需要 La 次前向传播。第 i 次传播的 FLOPs 取决于压缩上下文长度 Lc 和查询长度 Lq:
FLOPsiforward=FDecoder(M,Q,i),其中 M 表示混合输入(保留的token和略读向量)。因此,总 FLOPs 为:
FLOPs=i=1∑LaFLOPsiforward+FLOPscomp.实验结果表明,在相同压缩比下,RAM 与任务相关基线相比实现了显著更低的端到端延迟。
实验
实验在问答和摘要基准测试上,使用 LLaMA-3.1-8B 和 Qwen3-4B 主干模型,评估了 RAM 与任务特定和任务无关压缩基线的对比。RAM 在各种压缩比(2 倍到 32 倍)和不同模型架构下始终优于所有基线,同时在超出其训练长度的输入上保持强劲性能,展示了稳健的长度外推能力。效率分析表明,RAM 通过并行编码和查询引导的自适应压缩降低了推理成本,消融研究证实每个组件(包括略读、精读、查询感知压缩和对比学习)对其有效性都是必不可少的。总体而言,RAM 被证明既准确又高效,在基线方法性能下降的各种压缩设置下保持稳定性能。
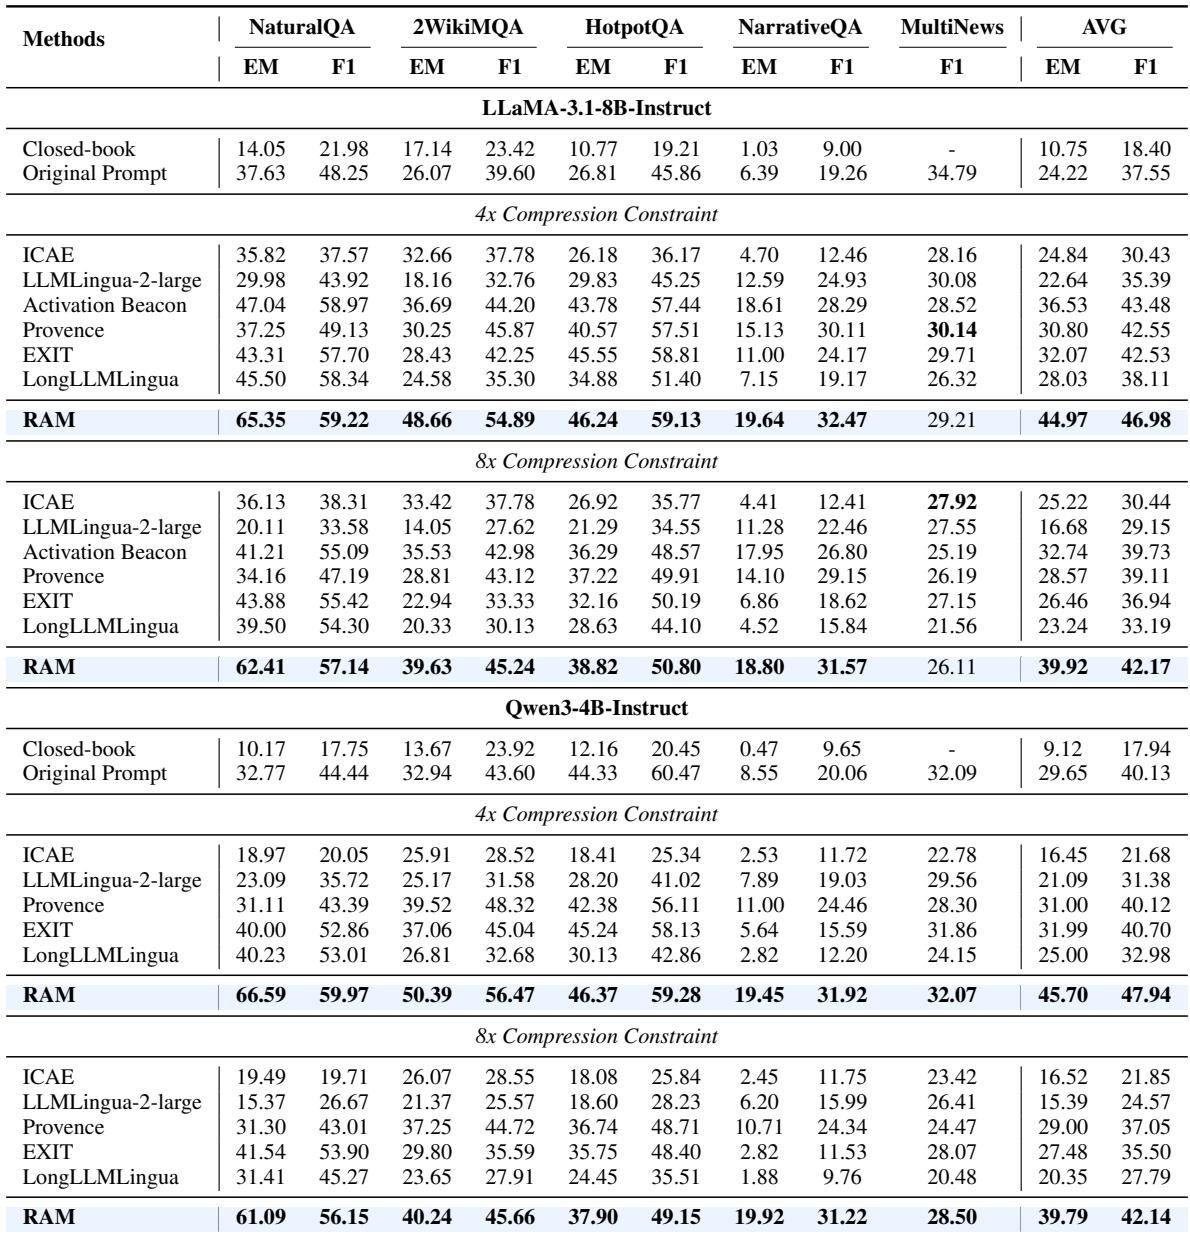
RAM 在不同压缩约束下的多个问答基准测试和一项摘要任务上始终优于现有压缩基线,在大多数设置中实现了最先进的精确匹配和 F1 分数。它还在不同主干模型上保持稳定性能,表明对模型选择的鲁棒性。RAM 在 4 倍和 8 倍约束下的所有基准测试中均超过压缩基线,在大多数情况下取得最佳精确匹配和 F1。RAM 在 LLaMA-3.1-8B 和 Qwen3-4B 主干模型上的性能稳定,显示出鲁棒性。即使略低于微调后的原始提示,RAM 在微调后仍能击败任务相关基线。
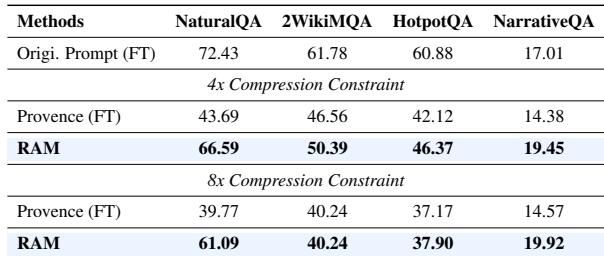
在使用 Qwen3-4B 主干模型的四个问答基准测试中,RAM 在 4 倍和 8 倍压缩约束下始终优于微调后的任务特定基线,并且经常接近或超过微调后的原始提示。其相对基线的优势在更高压缩比下增长,表明强大的语义保留能力和鲁棒性。RAM 在 4 倍和 8 倍压缩下均超过微调后的 Provence 解码器,覆盖所有基准测试。即使 RAM 落后于微调后的原始提示,它仍然具有竞争力,并且在 NarrativeQA 上,它在两个压缩级别都超过了原始提示。在 8 倍压缩下,RAM 的分数下降幅度小于基线,显示出对激进压缩的更强韧性。
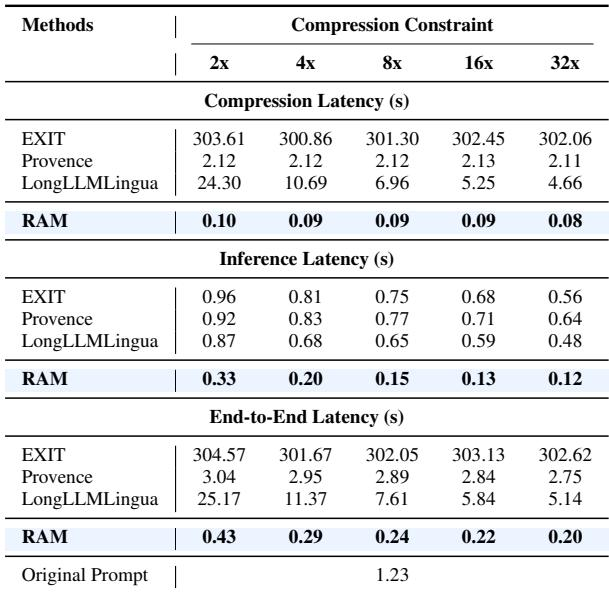
RAM 在所有压缩比下实现极低且稳定的压缩延迟,大幅优于基线方法。无论压缩约束如何,其压缩延迟保持在 0.1 秒左右,而 EXIT 等基线需要数百秒,LongLLMLingua 虽随压缩比下降但仍高得多。这种效率源于并行分段编码和查询引导的自适应压缩。RAM 的压缩延迟在所有压缩约束下约为 0.1 秒,比所有基线低数个数量级。EXIT 显示出持续较高的压缩延迟,约为 300 秒,而 Provence 保持在约 2.1 秒,LongLLMLingua 随着压缩变得更加激进,从 24.3 秒降至 4.7 秒。RAM 的压缩延迟几乎不受压缩比影响,表明即使在高压缩级别下也具有稳健的效率。
在两个数据集上的消融研究表明,移除任何核心组件都会降低性能,其中精读机制造成的下降最大。查询引导的略读优于平均池化,对比学习对于区分需要不同处理的分段至关重要。移除精读会导致最剧烈的性能下降,尤其是在 NaturalQA 上,EM 从 62.41 降至 46.40。将查询引导的略读替换为平均池化会降低分数,确认查询感知压缩保留了更多相关信息。省略对比学习也会显著损害结果,表明其在防止重要内容被过度压缩方面的作用。
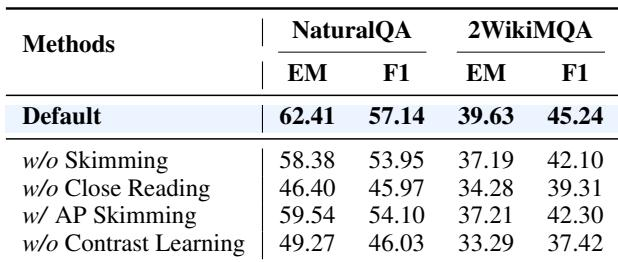
在 4 倍和 8 倍压缩下,RAM 在问答和摘要基准测试上始终优于现有压缩基线,在大多数设置中实现最先进的精确匹配和 F1 分数,同时在不同主干模型上保持稳定性能。无论压缩比如何,其压缩延迟保持在 0.1 秒左右,比基线快数个数量级,这归功于并行编码和查询引导的自适应压缩。消融研究表明每个核心组件都是必不可少的,其中精读最为关键,查询引导的略读优于平均池化,对比学习防止了重要内容的过度压缩。