Command Palette
Search for a command to run...
GeoRA:面向 RLVR 的几何感知低秩适配方法
GeoRA:面向 RLVR 的几何感知低秩适配方法
Jiaying Zhang Lei Shi Jiguo Li Jun Xu Jiuchong Gao Jinghua Hao Renqing He
摘要
可验证奖励强化学习(RLVR)是提升大规模推理模型的关键范式。与监督微调(SFT)不同,RLVR 具有独特的优化动态,并且对预训练几何结构的保持较为敏感。然而,现有的参数高效方法在这一范式下面临关键局限。低秩适配方法(如 PiSSA)主要面向监督微调设计,未考虑 RLVR 独特的优化动态和几何结构。另一方面,直接微调 RLVR 所偏好的非结构化稀疏参数子空间在现代硬件上会遭遇效率瓶颈。为应对这些挑战,我们提出 GeoRA(Geometry-Aware Low-Rank Adaptation),一种面向 RLVR 定制的低秩适配方法。具体而言,GeoRA 利用 RL 更新子空间的各向异性和可压缩结构,通过奇异值分解(SVD)提取其主方向以初始化低秩适配器,同时在训练期间将残差分量冻结为结构锚点。该设计在保持预训练结构的同时实现了高效稠密计算。在参数规模从 1.5B 到 32B 的 Qwen 和 Llama 模型上,实验表明 GeoRA 在数学、医学和编程等 RLVR 场景中持续优于强低秩基线方法,同时在域外任务上展现出更强的泛化能力和更少的遗忘。
一句话总结
美团与北京大学提出 GeoRA,一种面向 RLVR 的几何感知低秩适配方法,该方法利用 RL 更新子空间的各向异性与可压缩结构,通过 SVD 初始化低秩 adapter,同时将残差组件冻结为结构锚点,从而保留预训练几何结构,并在数学、医学和代码任务中实现高效稠密计算。
核心贡献
-
论文提出 GeoRA,一种面向可验证奖励强化学习的几何感知低秩适配方法,将参数高效训练与 RL 更新的优化结构对齐。
-
GeoRA 通过奇异值分解从各向异性且可压缩的 RL 更新子空间中提取主方向,用于初始化 adapter,并冻结残差组件作为结构锚点,以在支持高效稠密计算的同时保留预训练结构。
-
在 Qwen 和 Llama 1.5B 到 32B 参数模型上的数学、医学与代码实验表明,GeoRA 提升了训练稳定性,优于强低秩基线,并在域外任务上展现更强泛化性与更少遗忘。
引言
大型推理模型使用可验证奖励强化学习来增强数学和代码推理,但 RLVR 通过放大已有潜在行为而非注入新知识来发挥作用,因此更新必须保持稳定并与预训练模型几何结构对齐。这一点很关键,因为过度激进的微调可能破坏推理、损害通用能力或导致遗忘。已有参数高效方法在这一场景下存在困难:面向 SFT 的低秩适配会将更新偏向可能与 RLVR 偏好方向冲突的主成分,而稀疏微调虽可匹配 RLVR 行为,但通常缺乏硬件效率。作者基于这一洞察提出 GeoRA,一种几何感知低秩适配框架,使用 SVD 从几何约束子空间中提取主导可训练方向,将残差组件冻结为结构锚点,并保留稠密计算以实现稳定且硬件高效的 RLVR 训练。
方法
作者提出一种面向可验证奖励强化学习的低秩适配框架,命名为 GeoRA。其设计动机在于观察到强化微调不应全局覆盖预训练模型,而应将更新集中在稳定且具有可塑性的参数区域。GeoRA 因此引入一种面向 RL 的结构化低秩参数化,并配有残差锚点,在初始化时保持原始函数,同时将优化限制在几何对齐子空间内。与通常从随机 adapter 参数开始的标准低秩适配不同,GeoRA 从预训练权重矩阵的几何约束视图初始化 adapter。参见框架图。如下图所示:
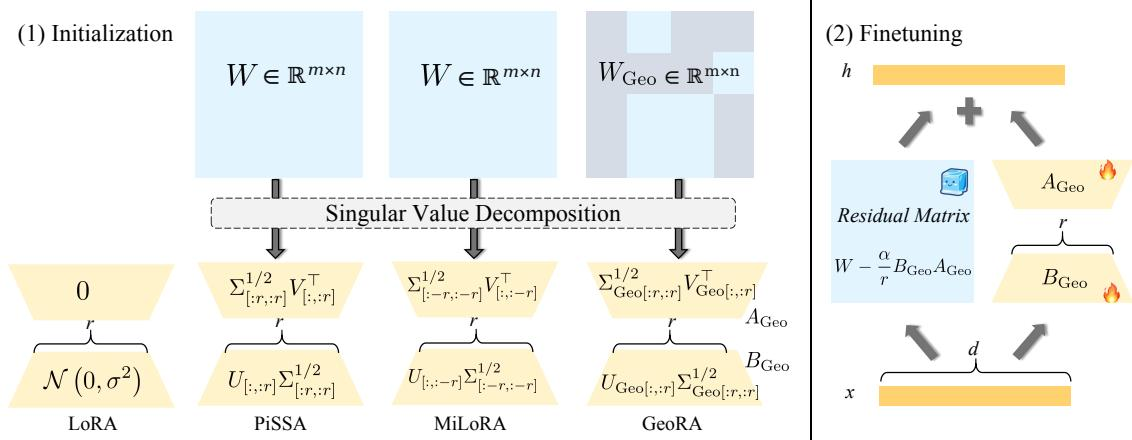
设 W 表示预训练权重矩阵,WGeo 表示其几何约束视图。作者对该矩阵执行奇异值分解,
WGeo=UGeoΣGeoVGeo⊤.随后仅保留前导的 rank r 方向。若 Ur 和 Vr 分别表示 UGeo 和 VGeo 的前 r 列,且 Σr 表示 ΣGeo 的前导 r×r 块,则可训练 adapter 初始化为
AGeo=Σr1/2Vr⊤,BGeo=UrΣr1/2.借助该构造,乘积 BGeoAGeo 近似 WGeo 所捕获的 rank r 几何结构。为在初始化时保持原始模型输出,作者计算残差矩阵
Wres=W−rαBGeoAGeo.在前向传播过程中,Wres 保持冻结,而 adapter 分支可训练,
h=Wresx+rαBGeoAGeox.初始化时,两个分支之和为 Wx,因此模型保持函数不变。在优化过程中,梯度更新只能作用于低秩 adapter,迫使适配保持在几何对齐流形内部,同时冻结的残差矩阵保护预训练表示。
几何约束矩阵 WGeo 通过轻量级掩码过程获得。作者构造两个互补先验。谱先验从 rank r 近似 W^r 中选择低幅值元素:
(MSpec)i,j=I(∣(W^r)i,j∣≤τSpec(ρ)),其中 τSpec(ρ) 是 W^r 中绝对值的第 ρ 分位数。该掩码抑制主导的高能量方向,并将适配聚焦于更稳定的谱区域。欧氏先验从原始矩阵中选择低幅值权重:
(MEuc)i,j=I(∣Wi,j∣≤τEuc(ρ)).最终掩码是这两个区域的并集,几何约束矩阵通过掩码加权形成:
WGeo=W⊙(MSpec∪MEuc).参见掩码工作流程图。如下图所示:
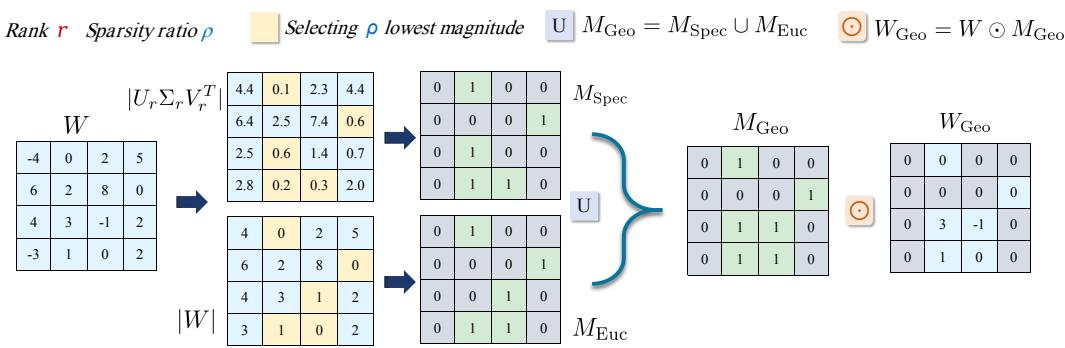
该掩码策略在 adapter 初始化之前定义更新位置。谱组件通过选择 rank r 几何结构的低能尾部来保护主子空间,而欧氏组件暴露接近零的权重,这些权重可以吸收由奖励驱动的扰动。并集产生一个在强化学习更新下稳定但仍有足够表达力进行适配的区域。由此得到的 WGeo 提供用于初始化可训练低秩 adapter 的奇异结构,从而将先验构造、adapter 参数化和冻结残差计算连接为一个训练架构。
实验
实验在数学、医学和代码 RLVR 任务上将 GeoRA 与 LoRA 变体以及全量或稀疏微调进行比较,使用多个骨干模型、域内与域外基准、训练动态、消融实验和谱分析。GeoRA 始终提升数学推理能力,保留更广泛的通用能力,能够迁移到其他领域,收敛更快,在具有挑战性的优化设置下保持稳定,并大幅减少可训练参数。分析表明,其几何感知初始化、谱掩码和欧氏掩码,以及与 RLVR 更新几何的对齐是关键,同时学习到的子空间捕获可压缩的低秩结构,并最小化对预训练特征的扭曲。
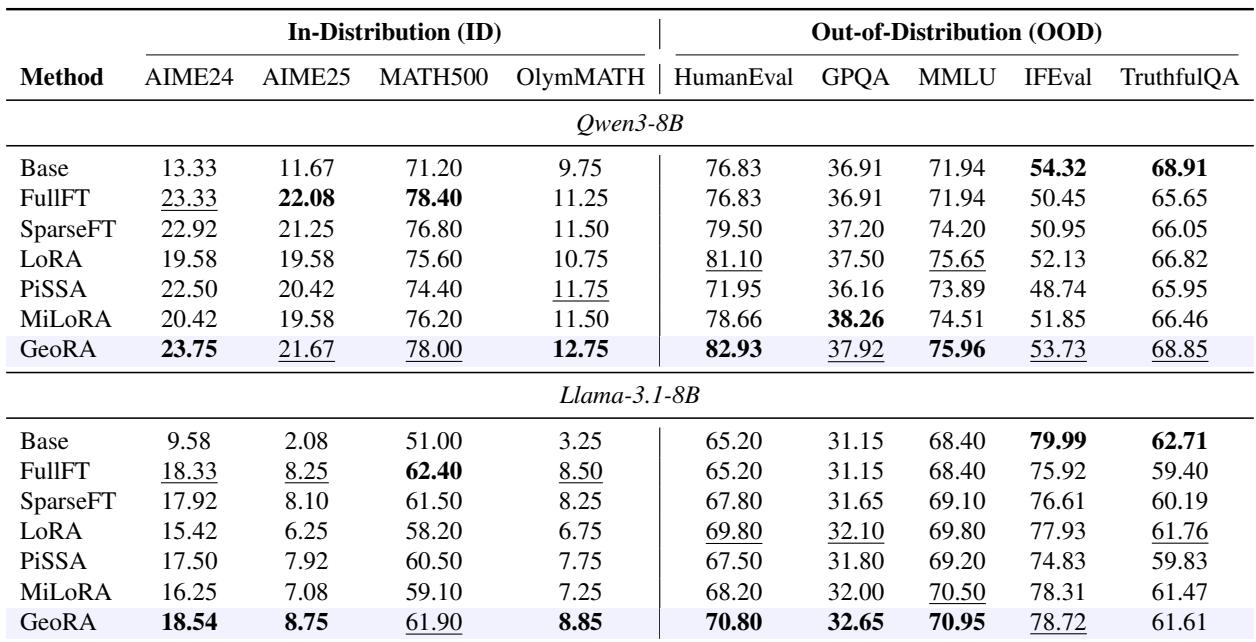
GeoRA 在数学推理基准上展现最强整体增益,在更困难的竞赛风格任务上优势明显,在更广泛数学评测中也具有竞争力。它还保持强分布外能力,在代码、科学知识和通用问答相关指标上优于低秩基线,同时避免在指令遵循和真实性上的大幅损失。GeoRA 在多数数学推理设置上优于 LoRA、PiSSA 和其他对比变体,表明几何感知初始化有助于 RLVR。该方法也能很好地迁移到数学之外,在分布外结果中取得最佳或接近最佳表现,并且比若干微调基线更好地保留通用能力。
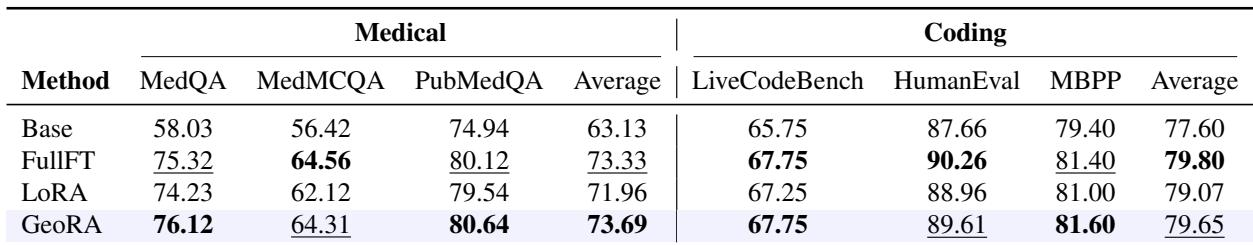
该方法在额外的医学和代码 RLVR 任务上表现强劲,相较于基座模型有所提升,并在两个领域的平均分上均优于 LoRA。它也接近全量微调,在医学平均分上领先,在代码平均分上仅略微落后。这些结果支持该方法能够超越数学推理任务进行泛化的论断。在所显示的所有医学任务和代码任务上,它均优于 LoRA。它在对比方法中取得最佳医学总体平均分,同时在代码上接近全量微调。
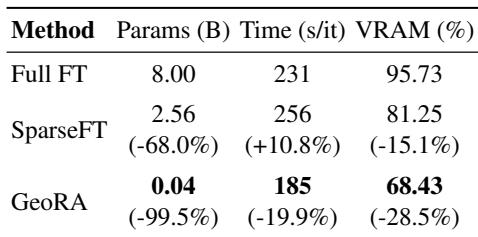
GeoRA 是对比方法中最高效的,仅更新 Full FT 参数的一小部分,同时降低显存和每次迭代训练时间。SparseFT 相比 Full FT 减少了参数和内存使用,但速度更慢;而 GeoRA 通过避免非结构化稀疏计算的开销,将强参数效率转化为实际硬件效率。GeoRA 相比 Full FT 大幅减少可训练参数,同时改善内存占用和速度。SparseFT 相比 Full FT 降低了参数和显存,但没有减少每次迭代训练时间。GeoRA 在速度和内存使用上都比 SparseFT 更高效,其一次性初始化成本相对训练可忽略不计。
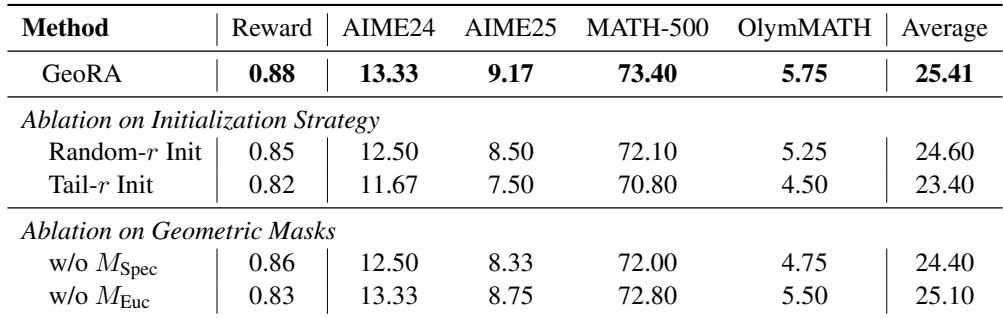
Qwen3-4B 的消融结果表明,当保留几何感知初始化和两种几何掩码时,GeoRA 表现最佳。将所提出初始化替换为随机或仅尾部变体会降低奖励和数学推理准确率,而移除谱掩码或欧氏掩码任一者都会导致性能持续下降。完整 GeoRA 在消融变体中取得最高奖励和平均数学推理分数。Tail-r 初始化性能最弱,表明仅选择低能方向并不足够。谱掩码和欧氏掩码均必要,移除任一者都会降低平均性能。
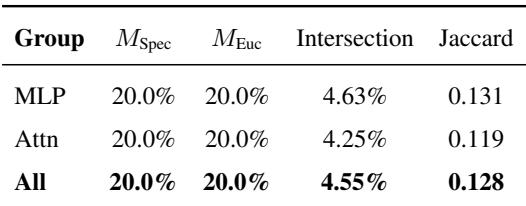
谱先验和欧氏先验在受测 8B 模型上各自选择约 20% 的参数,但二者仅轻微重叠。总体交集很小且 Jaccard 相似度较低,表明掩码识别出明显不同的参数子集。MLP 和 attention 组中呈现相同模式,支持两个几何先验起互补作用的观点。每个先验覆盖相近比例的参数,但只共享很小子集。MLP 和 attention 层之间有限重叠表明这些先验是互补而非冗余的。
实验在数学推理基准、分布外任务以及专门医学和代码 RLVR 设置上评估 GeoRA。结果表明,几何感知初始化持续提升数学推理,并能良好迁移到其他领域,同时比若干微调基线更好地保留通用能力。消融和掩码分析表明,谱掩码和欧氏掩码均必要且互补,而效率测试表明 GeoRA 以更少的可训练参数实现强硬件效率。