Command Palette
Search for a command to run...
超越 N-gram:重新思考多语言抽象式摘要的评估指标与策略
超越 N-gram:重新思考多语言抽象式摘要的评估指标与策略
Itai Mondshine Tzuf Paz-Argaman Reut Tsarfaty
摘要
基于 N-gram 的自动评估指标(如 ROUGE)被广泛用于摘要等生成任务的评估。尽管这些指标在英语中被认为能够反映(即便不完美)人工评估结果,但它们在其他语言上的适用性仍不明确。为解决这一问题,本文系统地评估了生成任务的评估指标——包括基于 N-gram 的和基于神经网络的指标——以检验其在不同语言和任务中的有效性。具体而言,我们设计了一个涵盖八种语言的大规模评估套件,这些语言来自四个类型学语系——黏着语、孤立语、低屈折语和高屈折语——同时涵盖低资源和高资源语言,以分析这些指标与人工评估结果之间的相关性。我们的研究结果揭示了评估指标对目标语言类型的敏感性。例如,与孤立语和黏着语相比,基于 N-gram 的指标在屈折语中与人工评估的相关性更低。我们还证明,分词策略的优化可以显著缓解这一问题,对于形态丰富的屈折语甚至能够逆转这种负相关。此外,我们发现专为评估任务训练的神经网络指标(如 COMET)始终优于其他神经网络指标,并且在低资源语言中与人工评估的相关性也优于 N-gram 指标。总体而言,我们的分析揭示了 N-gram 指标在屈折语上的局限性,并倡导加大对面向评估任务的神经网络指标的研发投入。
一句话总结
一项来自巴伊兰大学的研究系统评估了 n-gram 指标和神经指标在多语言生成式摘要任务中的表现,涵盖来自四个类型学家族的八种语言。研究发现,n-gram 指标与人工判断在融合语中的相关性较差,tokenization 考量可以缓解这种形态敏感性,而 COMET 等神经指标在低资源环境中通常稳定优于 n-gram 指标。
核心贡献
-
面向自动生成分母指标构建了大规模多语言评估套件,覆盖来自四个类型学家族的八种语言,并使用众包排名标注和统计显著性报告来分析指标与人工判断之间的相关性。
-
研究证明语言类型学会影响指标可靠性:对于融合语,n-gram 指标与人工评估的相关性低于孤立语或黏着语,而 tokenization 变体可以缓解这一问题,甚至在形态丰富的融合语中逆转负相关。
-
面向评估训练的神经指标,包括 COMET,比其他神经指标和 n-gram 指标与人工判断的相关性更强,尤其在低资源语言中如此,这支持使用神经模型进行多语言摘要评估。
引言
作者面向多语言生成式 LLM 讨论了一个实际问题:当 BLOOM、GPT-4o、Gemini 和 LLaMA 等模型在许多语言中被提示和部署时,开发者需要可靠的自动指标来判断超越英语的摘要质量。既有评估方法面临困难,因为 BLEU、ROUGE 和 METEOR 等 n-gram 指标假定以空格分隔且以完整词为单位,而许多语言具有丰富形态、歧义形式和非拉丁文字 tokenization 需求;此外,BERTScore 等神经指标在低资源或形态复杂语言中也可能表现不佳。既有研究还缺乏类型学广度、指标多样性、适配研究,以及与人工判断之间统计上可靠的相关性。作者利用来自四个类型学家族的八种语言中的约 20,000 条人工标注,在不同 tokenization 和词形还原条件下,系统比较 n-gram 指标和神经指标,包括专门的多语言评估模型。
数据集
-
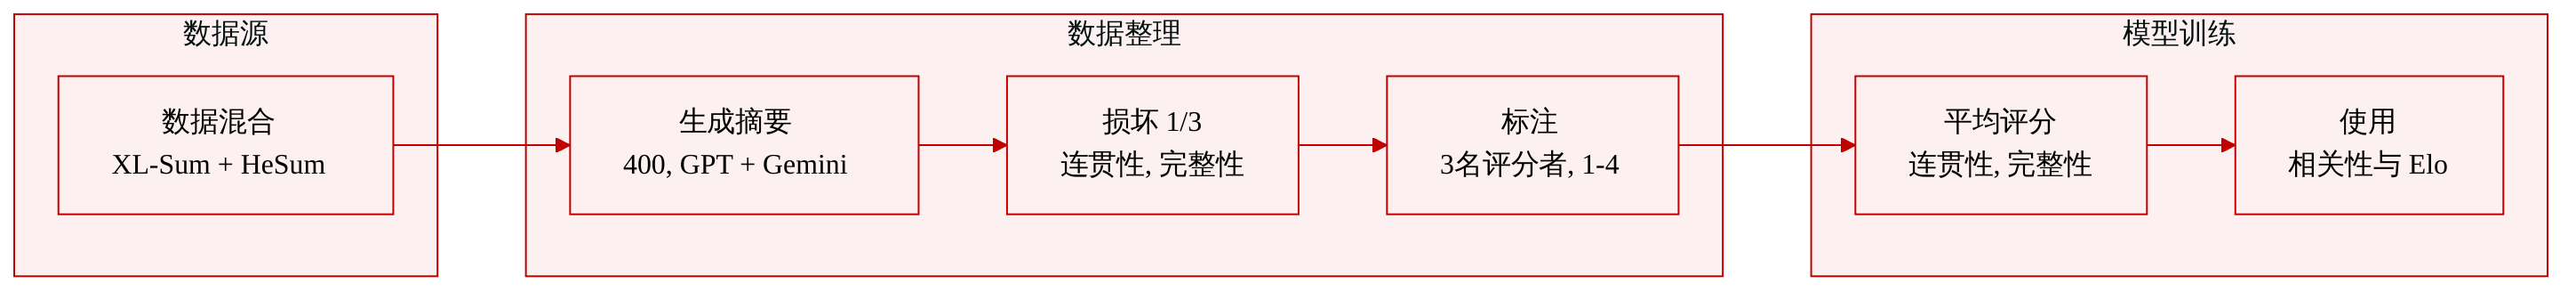
作者为多语言生成式摘要构建了一个人工评估数据集,覆盖八种语言,所选语言属于四个类型学家族,并且这些组别中同时包含低资源语言和高资源语言。
-
底层源文本和参考摘要主要来自 XL-Sum,这是一个多语言新闻摘要数据集,其中文章与人工撰写的摘要配对。对于希伯来语,作者使用 HeSum。
-
对于每种语言,作者从测试划分中采样 400 篇文章。对于每篇被采样文章,作者生成两个并行摘要,一个由 GPT-3.5-Turbo 0125 生成,另一个由 Gemini 1.0 Pro 生成。这样得到的模型生成摘要与源数据集提供的原始源文章和参考摘要信息配对。
-
为了拓宽摘要质量分布,作者人为破坏三分之一的生成数据。连贯性被削弱的方式包括:将名词和动词替换为词形还原形式,从而产生语法性更低的句子;对不相邻句子进行重排,以打断语篇流。完整性被削弱的方式包括:将摘要中的命名实体替换为源文章中的其他实体,并插入随机无关句子。
-
标注任务要求评分者在阅读源文章的同时比较一对生成摘要。评分者首先回答一个由 Gemini 创建的关于文章的理解性问题,以过滤未体现理解的贡献者所提交的标注。
-
每份摘要按两个质量维度进行评分,即连贯性和完整性。连贯性衡量语法性和可读性,而完整性衡量摘要对源文本主要思想的捕捉程度。评分采用 1 到 4 的 Likert 量表。
-
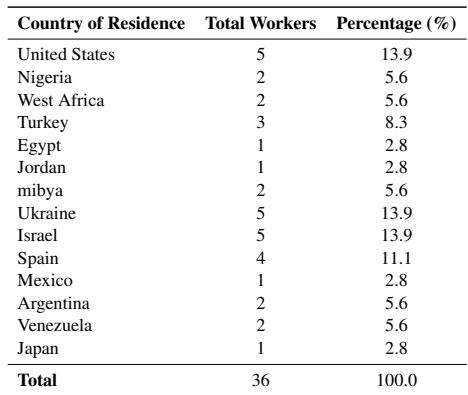
该数据集由来自 13 个地区的 36 名评分者标注。评分者通过 Amazon Mechanical Turk 招募,并在可能情况下将地理约束与目标语言对齐;同时还包括通过匹配问卷的合格学生。对于约鲁巴语和日语,当无法在目标国家本地招募时,使用了居住在预期国家之外的母语者。
-
可靠性通过以下方式控制:要求 MTurk 评分者拥有超过 100 个已批准 HITs,且批准率高于 90%。每个模型生成摘要由三名不同评分者评估,并使用平均分数进行相关性分析。作者还报告了 Krippendorff 的 α,其平均一致性为中等水平,连贯性为 0.4,完整性为 0.47。
-
所得数据集可以表示为以语言为条件的摘要评估记录,内容包括源文章、两个模型生成摘要、源模型身份、摘要是否为干净数据或被破坏数据、三个连贯性人工评分、三个完整性人工评分,以及推导得到的平均分数。
-
作者使用该数据集研究自动评估指标与人工判断之间的相关性,并生成模型的相对排名。每对人工比较也被转换为 Elo 风格排名,用于按语言和维度分别评估模型在连贯性和完整性上的质量。
方法
作者设计了一个受控的多语言评估流程,用于将自动摘要指标与人工判断进行比较。该框架旨在捕捉语言多样性与资源层面多样性,覆盖来自四个类型学家族的八种语言,并在每个家族中配对高资源语言和低资源语言。当某种语言在广泛多语言参考分布中的 token 份额 <0.1% 时,被视为低资源语言;当 token 份额 ≥0.1% 时,被视为高资源语言。这种分层允许作者考察指标行为是否在不同形态类型学和数据可得性水平之间保持一致。
对于每种语言,该流程首先从相应测试划分的随机样本开始,由大型语言模型生成两个并行的候选摘要。为了创造更丰富的质量分数分布,作者随后合成削弱三分之一的生成摘要,并且每次只针对一个评估标准。对于连贯性,名词和动词被替换为词形还原形式,从而产生语法性更低的文本;不相邻句子被重排,以打断语篇流。对于完整性,命名实体被替换为源文章中的其他实体,并插入无关句子。这一破坏过程有意创造出不仅由模型生成、而且质量存在差异的摘要变体。
指标评估模块比较通用分数与多语言或语言特定变体。指标池包括具有不同词单位界定定义的 ROUGE、依赖多语言或单语编码器的 BERTScore 变体,以及作为多语言评估神经框架的 COMET。对于每个语言与指标配对,该流程计算与人工评分的相关性,并跨所测试维度评估统计显著性。这种系统的配对分析对于确定某个指标在英语之外以及结构不同的语言中是否仍然可靠至关重要。
人工标注被纳入评估,以提供可信参考判断。每个生成摘要由三名不同标注者评估,该条目的人工分数计算为三个评分的平均值,即 savg=31∑j=13sj。标注者从经过审核的候选池中选择,通常具备母语或流利水平,并在可能情况下与目标语言匹配。为了降低噪声,标注者完成源自源文章的资格问题,仅保留合格贡献者的响应。标注一致性使用区间评分的 Krippendorff 的 α 进行衡量,这支持相关性分析中所使用人工评分的可靠性评估。
实验
这些实验构建了一个受控的多语言摘要评估设置,结合大量人工标注以及八种语言的生成摘要,所选语言覆盖不同类型学家族和资源水平。它们验证了评估可靠性取决于语言形态、词或 token 边界是否被良好处理、神经指标或 n-gram 指标的选择,以及指标是否经过广泛预训练或专门针对生成质量训练。研究发现,标准 n-gram 指标在非英语语言中往往不稳定,除非经过仔细适配;而神经指标,特别是任务特定或单语专门化的指标,比通用多语言方法或大型语言模型评审方法更紧密地与人工判断对齐。
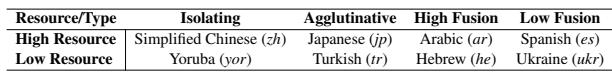
表格从两个维度对语言进行分类:形态类型学和资源可得性。它包括孤立语、黏着语、高融合语和低融合语,并在高资源和低资源类别中均提供代表性示例。这种分组支持跨不同语言结构和数据可得性条件进行比较。该分类覆盖四种形态类型:孤立语、黏着语、高融合语和低融合语。每种形态类型都由高资源和低资源语言示例代表。高资源示例包括简体中文、日语、阿拉伯语和西班牙语,而低资源示例包括约鲁巴语、土耳其语、希伯来语和乌克兰语。
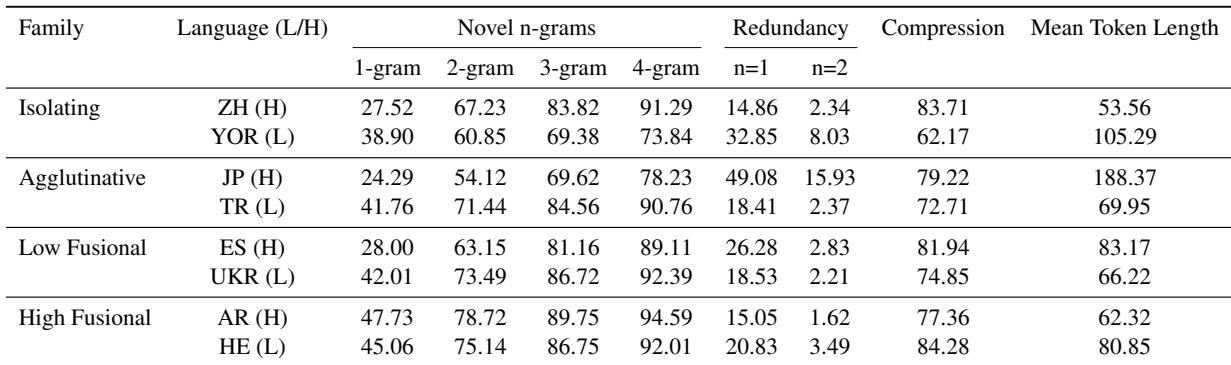
摘要在语言家族和资源水平之间差异很大。低资源语言通常比其高资源对应语言表现出更高的新增 unigram 比率,这表明摘要可能更抽象或更精炼,并且对基于重叠的评估更困难。高资源语言往往实现更强的压缩,而日语和约鲁巴语表现出更高冗余,并且日语具有明显更长的平均 token 长度。在 unigram 层面的更高新颖度主要出现在约鲁巴语、土耳其语和乌克兰语等低资源语言中。高资源语言通常比其低资源对应语言更大幅压缩源文章。冗余程度不均衡,日语和约鲁巴语比其他许多语言显示出更多重复 n-grams。
贡献者样本集中在美国,其中包含所报告的最大群体。其余参与者分布于若干较小的国家和地区分组中,土耳其的规模看起来大于这些其他组中的大多数。若干国家和地区由非常小且数量相近的贡献者群体代表。美国拥有分布中最大的贡献者群体。土耳其是所报告的最大非美国群体。埃及和约鲁巴语相关组别之一?这里按原文:埃及和约旦出现在最小的被代表群体中。
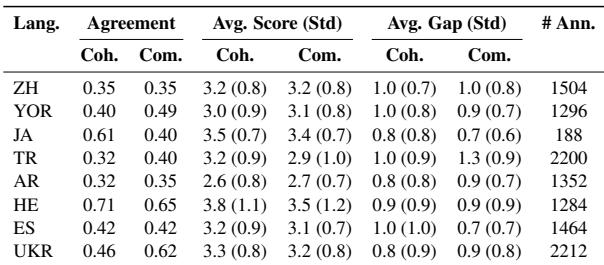
标注数据显示整体人工一致性为中等,连贯性和完整性在不同语言间判断不一致,但两个生成摘要来源之间存在一致的质量差距。平均人工评分大体相当,尽管阿拉伯语低于多数其他语言,而希伯来语高于多数其他语言。标注数量不均衡,土耳其语和中文的受审样本远大于日语,这意味着某些语言层面的趋势得到更好的支持。希伯来语的一致性最强,日语连贯性的一致性也相对较强,而阿拉伯语的连贯性一致性较低。Gemini 与 GPT 摘要之间的分数差距在各语言中保持接近,支持被破坏输出在质量上有所区分。土耳其语和中文的标注数量显著多于日语、希伯来语和约鲁巴语,造成跨语言样本支持不均衡。
与人工判断的相关性随类型学家族而变化,其中 n-gram 指标最受语言形态影响。融合语,特别是高融合语,表现出更弱或负向的 n-gram 相关性,而神经指标对类型学不那么敏感,并且通常具有更好的相关性。多语言 tokenizers、语言特定 tokenizers 和词形还原等适配措施可以改善一些形态丰富情形,但在某些评估标准下可能降低孤立语或黏着语的性能。神经指标通常比 n-gram 指标更好地与人工判断对齐。高融合语对标准 n-gram 指标而言最困难。形态感知或多语言适配可以提高融合语的相关性。
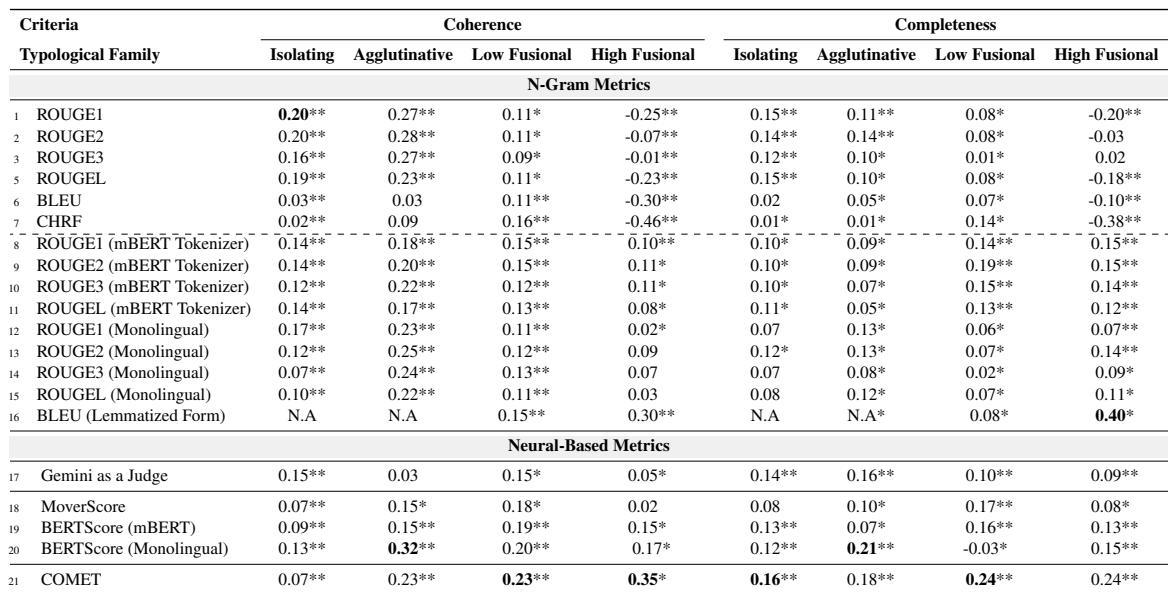
实验评估了跨越多种语言的多语言摘要任务,这些语言经过选择以覆盖不同形态类型学和资源水平,研究内容包括摘要属性、标注者分布、人工质量判断,以及指标与人工评估之间的对齐程度。研究发现,低资源语言往往产生更新颖的摘要,而高资源语言通常表现出更强压缩;尽管一致性和样本量可变,人工评分始终能够区分两个生成摘要来源。标注者覆盖集中在美国贡献者中,评估相关性显示 n-gram 指标尤其受形态影响,在融合语中表现最弱,而神经指标与人工判断的对齐更一致。