Command Palette
Search for a command to run...
Llama See, Llama Do: A Mechanistic Perspective on Contextual Entrainment and Distraction in LLMs
Llama See, Llama Do: A Mechanistic Perspective on Contextual Entrainment and Distraction in LLMs
Jingcheng Niu Xingdi Yuan Tong Wang Hamidreza Saghir Amir H. Abdi
摘要
We observe a novel phenomenon, contextual entrainment, across a wide range of language models (LMs) and prompt settings, providing a new mechanistic perspective on how LMs become distracted by "irrelevant" contextual information in the input prompt. Specifically, LMs assign significantly higher logits (or probabilities) to any tokens that have previously appeared in the context prompt, even for random tokens. This suggests that contextual entrainment is a mechanistic phenomenon, occurring independently of the relevance or semantic relation of the tokens to the question or the rest of the sentence. We find statistically significant evidence that the magnitude of contextual entrainment is influenced by semantic factors. Counterfactual prompts have a greater effect compared to factual ones, suggesting that while contextual entrainment is a mechanistic phenomenon, it is modulated by semantic factors. We hypothesise that a circuit of attention heads — the entrainment heads — that corresponds to the contextual entrainment phenomenon. Using a novel entrainment head discovery method based on differentiable masking, we identify these heads across various settings. When we "turn off" these heads, i.e., set their output to zero, the effect of contextual entrainment is significantly attenuated, causing the model to generate output that capitulates to what it would produce if no distracting context were provided. Our discovery of contextual entrainment, along with our investigation into LM distraction via the entrainment heads, marks a key step towards mechanistic analysis and mitigation of the distraction problem.
一句话总结
多伦多大学、TU Darmstadt 与 Microsoft Research 识别出上下文吸引(contextual entrainment):这是一种机制性现象,语言模型会给在上下文提示词中较早出现的 tokens 分配异常偏高的 logits,而不论其语义是否相关;该效应可通过可微掩码方法定位到特定注意力头,并证明消融这些注意力头会显著削弱干扰。
核心贡献
-
该工作识别并刻画上下文吸引:语言模型会给提示词中较早出现的 tokens 分配更高的 logits,即使是随机 tokens;并且相对于事实上下文,反事实上下文会增强该效应。
-
论文提出一种基于可微掩码的方法来发现上下文吸引头,相比孤立分析注意力头,该方法能更有效地揭示与上下文吸引相关的注意力头电路。
-
通过将所发现上下文吸引头的输出置零进行消融,可以显著降低上下文吸引,并使输出更接近没有干扰上下文时生成的输出,从而提供机制解释和潜在的干扰缓解策略。
引言
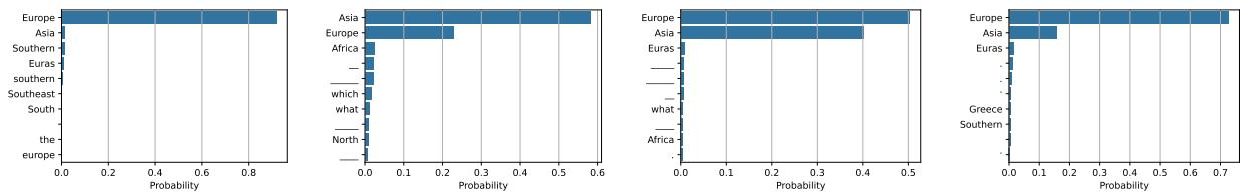
大语言模型可以通过上下文内学习利用提示词上下文,这对检索增强生成很重要,因为添加的上下文既可能帮助也可能扭曲模型输出。先前工作主要将干扰描述为无关上下文,但该定义过于粗糙,无法解释不同无关提示词为何有不同影响,也无法解释模型在内部如何误用上下文。作者识别出上下文吸引:提示词中较早出现的任何 token 都会获得更高 logits,无论其是否相关;反事实内容会放大该现象。他们还使用可微掩码定位出一小组吸引头,并证明禁用这些头会抑制该效应。
方法
发现上下文吸引头
作者利用可微电路发现方法来识别哪些注意力头负责上下文吸引。他们不是孤立分析每个注意力头,而是将问题表述为:找到一个小型注意力头子集,移除这些头后,模型会更难跟随上下文中的反事实信息,即使被评估问题与该反事实信息没有直接关联。
从高层看,该方法通过在预训练 transformer 语言模型中选择性禁用注意力头,并学习哪些头最有助于在网络中传播上下文信息。对于每个注意力头,作者引入一个可学习掩码,以控制该头是否贡献于残差流。当掩码激活时,该头正常运作;当掩码未激活时,其贡献会被有效移除。
对于某个 transformer 块,被掩码控制的头贡献可写为:
zi=hj∈Hi∑mjhj(xi),其中 hj 表示第 j 个注意力头,Hi 是块或层 i 中的注意力头集合,xi 是该块的输入,mj 是与注意力头 hj 关联的二值掩码。
由于二值掩码不可微,作者使用带直穿估计器的 Gumbel sigmoid 松弛。每个掩码由可学习 logit li、温度 τ 和两个均匀随机变量生成。采样掩码计算如下:
si=σ(τli−loglogU2logU1), mi=[1si>21−si]detach+si.其中 σ(⋅) 是 sigmoid 函数,τ∈(0,∞) 控制采样掩码的锐度,li 是第 i 个头掩码的可学习 logit,U1,U2∼Uniform(0,1) 为掩码采样提供随机性。第一项 1si>1/2 在前向传播中产生硬二值掩码,而第二项允许梯度在反向传播中通过 si 流动。
优化目标包含两个相互竞争的目标。第一目标是抑制上下文吸引信号,即掩码模型应减少或消除反事实上下文对目标输出的影响。第二目标是保持发现电路的稀疏性,使得只有少量重要注意力头被选中。这些目标被组合为以下损失:
L=Logits Δℓmasked−ℓbaseline+Sparsity Lossλ⋅∣H∣1i=1∑∣H∣σ(li).在该公式中,ℓmasked 表示应用学习掩码时的相关 logits,ℓbaseline 表示对应基线设置下的相关 logits,Δlogits 捕捉禁用所选注意力头的影响。稀疏项惩罚使用过多活跃头,其中 ∣H∣ 是候选注意力头总数,li 是头 i 的掩码 logit,λ 控制稀疏惩罚强度。通过优化该目标,方法学习出一组紧凑注意力头,其贡献与上下文吸引强相关。
训练过程将原始 transformer 参数固定,并学习注意力头的掩码 logits。该方法分别应用于每个任务配置,使发现出的头集合能够反映该特定吸引设置的结构。在报告设置中,作者使用 Llama 3.1 8B,该模型包含 1024 个注意力头,组织为 32 层,每层 32 个头。每种关系类型划分为训练、开发和测试划分,比例分别为 80%、10% 和 10%。
头掩码在训练集上优化 500 个 epoch。该过程会考虑多个检查点,并根据性能和简洁性选择最终吸引头集合。选中的检查点是表现出最强吸引抑制效应且使用最少活跃头的检查点。随后在留出测试集上评估得到的吸引头,该测试集不用于掩码优化、超参数搜索或检查点选择。
实验
实验在关系提示上评估多个语言模型,使用相关、无关、随机和反事实上下文,衡量这些上下文如何改变干扰 tokens、正确 tokens 和反事实 tokens 的 logits 与概率。结果表明,模型始终更偏好出现在上下文中的 tokens,即使上下文是随机的,这表明存在机制性上下文吸引效应;语义内容会调节该效应,反事实上下文导致更强干扰。进一步干预识别出任务特定注意力头,移除它们可显著抑制吸引,而对事实召回或上下文内学习损失很小,支持上下文吸引是可分离的内部机制并可针对性缓解。
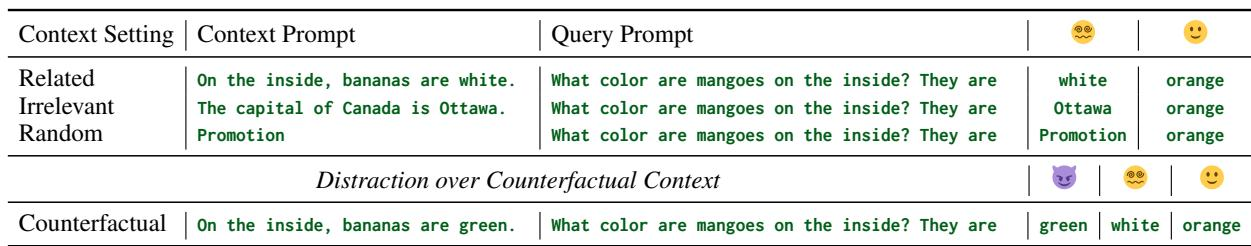
提示词设置将上下文事实与事实问题组合,以测试不同上下文类型如何影响答案空间。它对比相关、无关、随机和反事实上下文,并为每个问题标记正确、干扰和反事实目标 tokens。相关上下文共享与问题相同的关系类型,而无关上下文使用不同关系,随机上下文使用单个 token。反事实上下文引入一个被修改的事实,支持一个与事实答案竞争的目标 token。
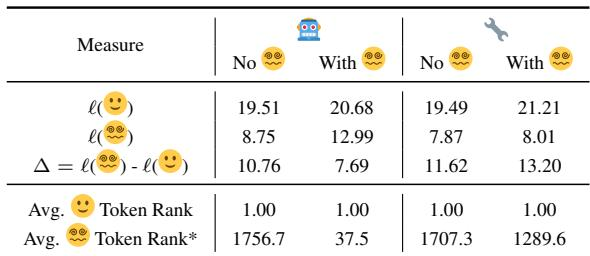
移除识别出的上下文吸引头会大幅削弱国家首都城市任务中干扰性反事实上下文的影响。正确答案仍排名第一,而干扰 tokens 在 token 分布中明显下移,并与正确答案被更大的 logits 间距分离。这表明吸引头专门支持上下文干扰,而非一般事实召回。在国家首都城市测试集中关闭吸引头会减弱上下文吸引。干扰答案 tokens 在头移除后排名急剧下降。正确 tokens 与干扰 tokens 的 logits 差异大幅增加。报告所述效应在配对检验下具有统计显著性。
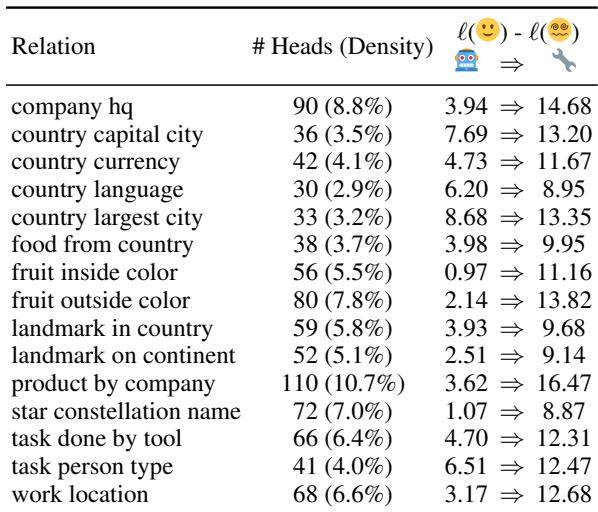
在多种 LRE 关系中,一小部分注意力头在其输出被禁用时即可显著扩大正确 tokens 与干扰 tokens 之间的 logits 差距。该效应出现在多种关系中,但头的数量和选择会随关系变化,表明存在关系特定的吸引,而非固定的全模型头集合。移除这些头主要降低上下文吸引,而事实召回和上下文内学习基本保持不变。禁用识别出的头会显著减弱干扰,并提高正确 tokens 的 logits 优势。不同 LRE 关系需要不同数量的吸引头,表明存在任务特定机制。这些头的作用相对孤立,对其他语言模型能力只有较小影响。
移除国家首都吸引头后,其他关系上的性能大体保持不变。无论严格评估还是轻信评估,准确率都保持较高,原始模型与修改后模型之间只有轻微变化。结果表明,这些头主要影响吸引,而非一般事实召回。移除头后,其他关系上的准确率仍保持较高。严格和轻信结果均未出现明显大幅下降。国家首都任务性能保持完美。其他事实能力仅受轻微影响。
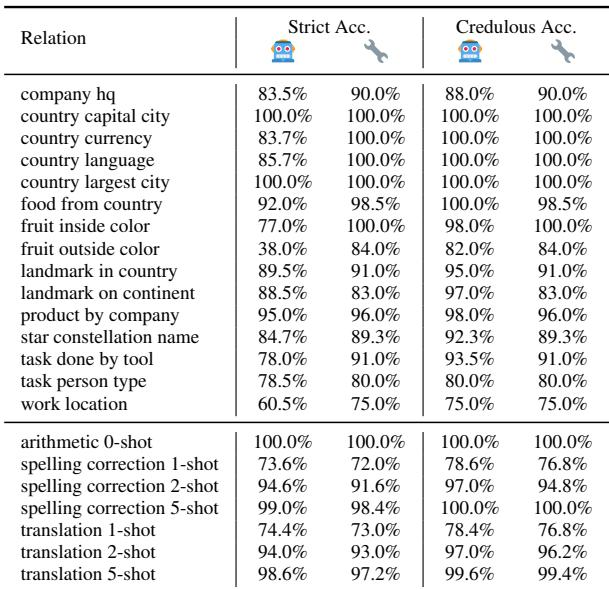
实验使用将事实问题与相关、无关、随机和反事实上下文配对的提示词,检验上下文如何影响答案预测。移除一小部分关系特定注意力头会急剧削弱模型对干扰或反事实上下文的敏感性,并增加正确 tokens 与竞争 tokens 之间的分离程度。这些效应在多种关系类型上均可观察到,同时基本保留事实召回和其他语言功能,表明这些头主要中介上下文吸引,而非核心知识。