Command Palette
Search for a command to run...
基于上下文多样性的 Zipf 意义-频率定律的新表述
基于上下文多样性的 Zipf 意义-频率定律的新表述
Ryo Nagata Kumiko Tanaka-Ishii
摘要
本文提出将 Zipf 的意义-频率定律(即词频与义项数之间的幂律关系)表述为词频与上下文多样性之间的关系。所提出的公式化方法将义项数量量化为上下文多样性,该多样性基于从语言模型(LM)获得的上下文化词向量的方向。这一表述为该定律提供了新的诠释,并使我们能够在比先前研究更广泛的词语和语料库上对其进行检验。此外,本文表明当所使用的语言模型规模较小时,该定律变得不可观测,且自回归语言模型需要比掩码语言模型多得多的参数才能观测到该定律。
一句话总结
来自甲南大学、RIKEN 和早稻田大学的研究者将 Zipf 的词义频率定律重新表述为:把词义数量量化为由语言模型中语境化词向量方向派生出的语境多样性,这使得可在更广泛的词和语料上检验该定律,并表明自回归语言模型需要比掩码语言模型多得多的参数才能观察到该定律。
核心贡献
- 该工作将 Zipf 的词义频率定律重新表述为词频与语境多样性之间的关系,语境多样性由语言模型生成的语境化词向量方向测量得到,不使用词典义项数量。该表述可在比基于词典的研究更多的词类型和语料上进行分析。
- 该无词典表述被应用于更广泛的语言数据,包括历史语料和学习者语料,并报告该定律成立的词范围比先前研究可评估的范围更广。
- 实验将该重新表述的定律与语言模型规模和架构联系起来,表明小型语言模型不呈现该定律,并且自回归语言模型需要比掩码语言模型多约 14 倍的参数才能呈现该定律,这表明该定律可作为词汇能力的健全性检查。
引言
该研究针对 Zipf 的词义频率定律,该定律指出更常见的词往往具有更多词义,并遵循幂律。这一关系对计算语言学、词汇语义学和语言建模具有重要意义,因为它将词语使用与自然语言数据中的词义多样性联系起来。
先前工作依赖词典或人工标注来统计词义数量。这导致不同资源间的词义计数不稳定、词义缺失或不均衡、词汇覆盖有限,并常常排除功能词、高频词和屈折形式。这还使大规模研究变得困难,并引发如何比较词义数量相同但使用分布不同的词的问题。
该研究利用语言模型产生的语境化词向量,将词义数量重新表述为语境多样性。这一做法消除了对词典的依赖,将该定律与 Harris 的分布假设联系起来,并使该定律可在更广泛的词集和语料库上接受检验。还表明,新的表述可作为语言模型词汇能力的诊断工具。
数据集
-
该研究分析经典语言语料库,而不是单一的新训练集。主要来源为:
- 英语:英国国家语料库(BNC)以及美国英语历史语料库(COHA)中经过清洗的 2000s 子语料库(CCOHA)。
- 日本语:青空文库日本语文学语料库和当代日语书面语平衡语料库(BCCWJ)。
- 多语言圣经数据:来自五个语系的 24 种语言的 27 个语料库。
- 详细语料规模和其他来源信息见附录 A.2,未在该摘录中说明。
-
每个语料子集都使用与任务匹配的 BERT 编码器处理,以获得语境化词向量:
- 英语语料库使用
bert-large-uncased的最终隐藏层。 - 日本语语料库使用
cl-tohoku/bert-large-japanese-v2的最终隐藏层。 - 圣经语料库使用
bert-base-multilingual-uncased的最终隐藏层。
- 英语语料库使用
-
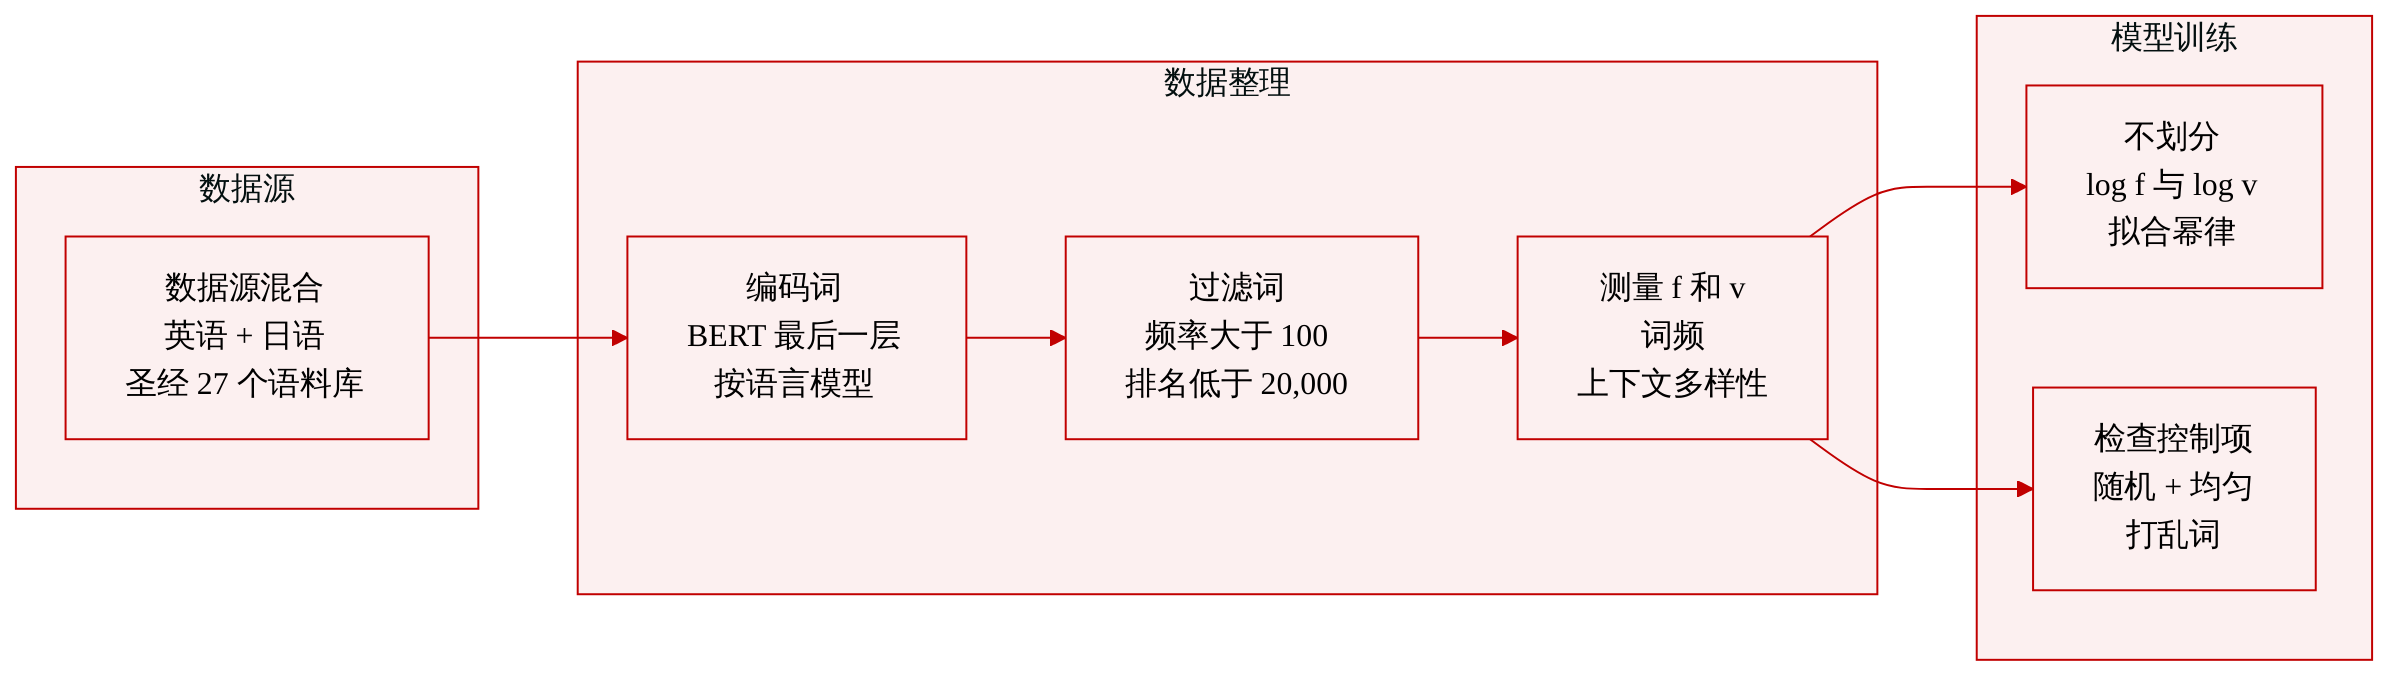
该研究不直接使用所有 tokens 或词汇项。它使用两个语料频率条件过滤目标词:
- 频率计数大于 100;
- 频率排名位于前 20,000。
- 对于由多个子词表示的词,排除中间和末尾的子词片段。
- 保留的词包括高频词、功能词以及屈折或变位形式。
-
主要派生数据集变量为:
f:语料库中的词频;v:由语境化词向量估计得到的语境多样性。 这些变量用于拟合幂律回归,并检验词义-频率或语境-频率关系。
-
论文未报告这些语料库的训练划分、混合比例、裁剪策略或丰富的元数据 schema。这些数据用于分析:从 BERT 提取词向量,对过滤后的 tokens 进行计数和测量,并评估频率-多样性关系。
-
经典语料库用于检验词频和语境多样性是否遵循幂律。对于圣经语料库,报告的平均拟合
R^2为 0.85,平均斜率系数为 0.043。 -
还基于 CCOHA 2000s 子语料库构造三个人工合成对照数据集:
- 打乱语料,其中词序被随机化,但词表和词频保持不变;
- 均匀采样语料,其中词从原始词表中均匀抽取,以匹配原始语料规模;
- 虚拟随机向量语料,其中在单位高维球面上生成单位向量,生成向量数量与 CCOHA 2000s 子语料库中的词频相匹配。
-
这些合成数据集仅用于计算
f和v,并将人类语言语料库与非语言学统计对照进行比较。
方法
该方法提出对词义频率定律的分布重述。它不使用词典中列出的词义数量,而将词语出现的每个语境视为潜在不同词义的证据。核心思想是:词义差异体现为语境使用差异,而这些差异可通过词向量方向来测量。这将分析从符号化词义计数转向连续向量几何。
第一个关键模块将词语使用转换为单位球面上的方向变化。对于给定词型,该方法使用上下文相关或语境化向量表示词在局部环境中的每次出现。由于向量间语义相似性通常通过余弦相似度评估,该方法忽略向量范数,只关注方向。因此,它将每个词向量归一化为单位长度。在这种表示下,若某词的上下文向量几乎指向同一方向,则该词语义集中;若某词的向量散布于许多方向,则该词表现出更多样的语境使用。
为量化这种方向散布,该方法将某一词型的归一化向量建模为来自 von Mises-Fisher 分布的样本。该分布定义于高维球面上的单位向量,并以平均方向和集中参数为参数。对于某词型,令 x 表示归一化词向量。该分布写作:
f(x;μ,κ)∝exp(κμTx)此处,μ 是向量的平均方向,且 ∥μ∥=1,而 κ≥0 控制向量围绕该平均方向聚拢的紧密程度。较大的 κ 表示向量强烈集中于某个方向,意味着相对稳定的语境行为。较小的 κ 表示向量广泛分布,意味着更高的语境变化性。
由于该方法旨在测量词义多样性而非集中程度,它使用集中参数的倒数作为语境多样性的代理指标:
v≡1/κ这一反向关系很重要。若 κ 较大,则 v 较小,意味着该词仅在较窄的语境集合中使用。若 κ 较小,则 v 较大,意味着该词出现在更多样的语境中。标量 v 因此用作传统基于词典词义计数的操作性替代量。
为从观测向量估计 κ,该方法使用近似最大似然表达式。对于具有 d 维归一化向量的词型,令 l 表示这些单位向量平均向量的范数。于是:
κ≈1−l2l(d−l2)该估计量与向量的几何结构直接相关。当所有向量几乎指向同一方向时,它们的平均向量范数接近 1,因此 l 接近 1,κ 变大,v 变小。当向量广泛分散时,l 减小,κ 减小,v 增大。因此,v 的计算将某词的全部上下文向量归约为一个表示语义或语境多样性的标量测度。
获得该量后,词义频率定律被重新表述为词频与语境多样性之间的幂律。令 f 为语料库中某词的频率,令 v 为其语境多样性得分。所提议的关系为:
v∝fα这表达了一个假设:更常见的词往往获得或表现出更广泛的语境意义。为了检验该关系是否遵循幂律并估计指数 α,该方法对两边取对数:
log(v)=αlog(f)+c其中 c 是与语料规模相关的常数。α 为正表示更高频率与更大语境多样性相关联,而拟合质量和斜率系数的统计显著性决定该定律在给定语料库中是否得到支持。
该流程通过按频率分箱的回归流程应用这一表述。在语料库中统计原始词频,并为待分析词型提取词向量。然后将向量归一化为单位长度。对于每个词型,计算平均向量及其范数 l,并使用上述近似公式估计 κ。由此,通过 1/κ 得到语境多样性得分 v。
为降低单个词带来的噪声并稳定回归,词语按频率排名被分入各个分箱。在每个分箱内计算平均频率和平均语境多样性,并使用对数线性方程对这些分箱平均值进行回归。典型设置使用大小为 100 的频率排名分箱,因此具有连续排名的词会在回归前被汇总。最终评估依赖斜率系数 α、决定系数 R2 以及检验斜率系数是否非零的 Student t 检验。这样,该方法将高维向量变化转换为单个词级统计量,并检验该统计量是否按词义频率定律随词频缩放。
实验
实验通过从 BERT 词向量估计词频和语境多样性,在经典、历史、学习者、随机以及模型规模设定下检验该定律的新表述。该定律在标准语料库中较为稳健,尽管较老文本和学习者文本中的低频案例显示偏差,表明对词义的敏感性有限。随机对照显示,这一模式依赖结构化人类语言,而非表面的频率顺序;在较小或自回归模型中,该模式会减弱,除非模型足够大。总体来看,这些发现支持跨语言的广泛规律,并表明该定律可用作模型编码意义能力的诊断工具。
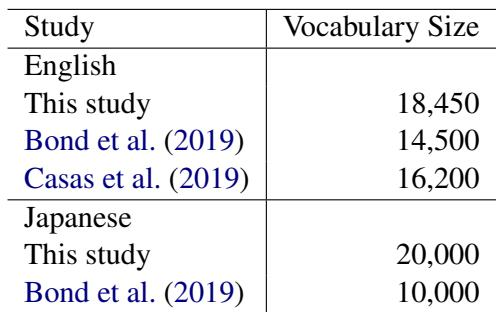
该表比较了英语和日本语分析中使用目标词数量。当前英语研究使用的目标词汇量大于较早研究,尤其是 Bond 等人。在日语中,当前研究使用的目标词汇量远大于所列的先前研究。该研究的英语目标词汇量大于被比较研究中的目标词汇量。日语目标词汇量也显著大于先前的日语计数。
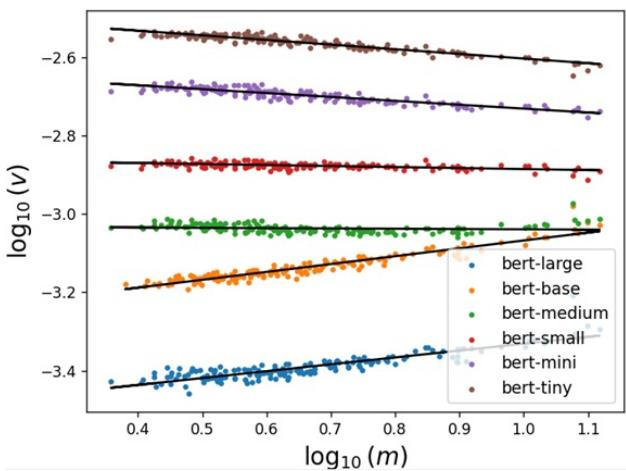
较大的掩码语言模型显示出更清晰的词义-频率关系,而较小的 BERT 模型表现出更弱甚至为负的频-多样性趋势。自回归 GPT-2 medium 虽然参数数量与 BERT-base 相当或更大,但没有显示该关系,只有大得多的自回归模型才恢复这一趋势。结果表明,模型规模和双向上下文有助于区分词义的细微差异。随着 BERT 模型规模增大,词义-频率趋势变得更清晰。小型 BERT 模型显示弱或负的频-多样性斜率。自回归 GPT-2 medium 尽管模型规模与 BERT-base 相当,仍未能显示该趋势。
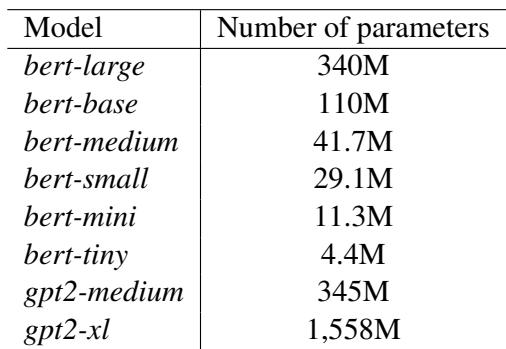
该表显示,较大的 BERT 模型产生更大的正斜率系数,而较小模型产生弱或负值。这些模型还显示语境多样性与 WordNet 义项计数之间更强的关联,以及更高的 MNLI 准确率。斜率系数与这两种度量之间的强相关表明,斜率反映了词汇质量和下游性能。斜率系数从大型 BERT 模型到微型 BERT 模型逐步下降,并在最小模型中变为负值。语境多样性与 WordNet 词义之间的相关随模型规模增大而增强。斜率系数与 MNLI 准确率呈强正相关。
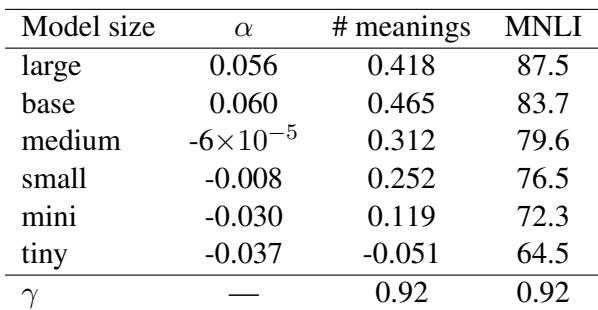
实验比较了不同研究中的目标词汇覆盖,并评估模型规模、架构和双向上下文如何与词义-频率模式相关联。较大的 BERT 模型显示更清晰的正频-多样性趋势,而较小模型和 GPT-2 medium 产生弱、负或缺失的关系,表明足够的容量和双向上下文支持更细粒度的意义区分。这些斜率模式也与语境多样性和义项清单之间更强的关联以及下游语言理解一致,表明它们反映了词汇质量和实际 NLP 能力。