Command Palette
Search for a command to run...
MiniLongBench:面向大语言模型的低成本长上下文理解基准
MiniLongBench:面向大语言模型的低成本长上下文理解基准
Zhongzhan Huang Guoming Ling Shanshan Zhong Hefeng Wu Liang Lin
摘要
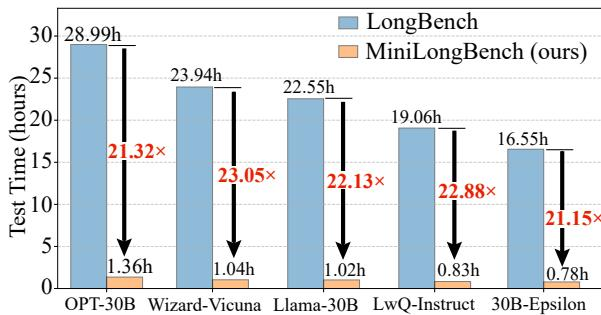
长上下文理解(LCU)是当前大语言模型(LLMs)领域的重要研究方向。然而,由于长文本数据本身篇幅较长,现有的面向大语言模型的 LCU 基准往往导致极高的评估成本,如测试时间和推理费用。通过大量实验,我们发现现有的 LCU 基准存在显著的冗余性,导致评估效率低下。本文提出了一种面向信息稀疏长文本数据的简洁数据压缩方法,通过对知名 LCU 基准 LongBench 进行剪枝,构建了 MiniLongBench。该基准仅包含 237 个测试样本,涵盖六大任务类别和 21 个不同任务。通过对 60 多个大语言模型的实证分析,MiniLongBench 将平均评估成本降低至原始基准的 4.5%,同时与 LongBench 的结果保持 0.97 的平均秩相关系数。因此,MiniLongBench 作为一个低成本基准,具有显著推动未来大语言模型长上下文理解能力研究的潜力。代码、数据及教程请参见 GitHub。
一句话总结
中山大学与鹏城实验室提出 MiniLongBench,这是一个压缩的长上下文理解基准,通过针对稀疏长文本数据定制的数据压缩方法剪枝 LongBench 而创建,将评估成本降至原始成本的 4.5%,同时与 LongBench 结果保持 0.97 的平均秩相关系数。
核心贡献
- 该论文引入 MiniLongBench,这是一个从 LongBench 提炼出的紧凑长上下文理解基准,包含六大任务类别和 21 个不同任务下的 237 个测试样本。
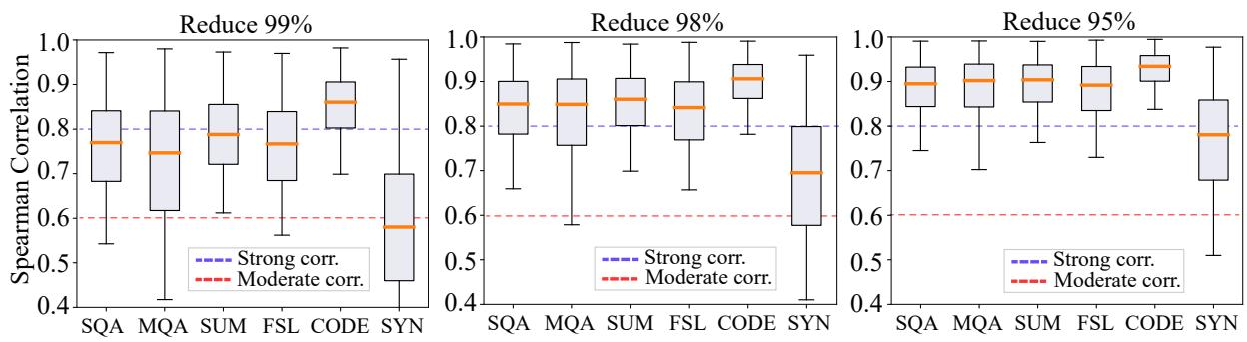
- 该论文提出了一种针对信息稀疏的长文本数据的简洁数据压缩方法,并通过随机采样实验验证了 LongBench 中存在显著冗余,从而支持低成本测试。
- 对 60 余个大语言模型的实证评估显示,MiniLongBench 与 LongBench 保持约 0.97 的平均秩相关系数,同时将评估成本降至原始成本的 4.5%。
引言
长上下文理解对大语言模型很重要,因为书籍与论文摘要、文档问答、仓库级代码生成等应用需要模型处理数千或数万 tokens。诸如 LongBench 等现有长上下文基准提升了评估质量,但它们运行成本很高,因为每个示例包含许多 tokens,并且基准包含大量测试样本,导致较高的 GPU 时间与内存开销。作者发现这些基准样本存在显著冗余,并提出紧凑替代方案 MiniLongBench。它在保留模型排名的前提下剪枝长文本评估数据。在 60 余个大语言模型上的评估表明,MiniLongBench 将评估成本降至 LongBench 的约 4.5%,同时保持接近 0.97 的平均排名相关性。
数据集
-
作者从 LongBench 构建了 MiniLongBench,这是一个紧凑的长上下文理解基准。LongBench 是一个广泛使用的长上下文理解基准,包含六大任务类别中的近 5000 个测试样本:单文档问答、多文档问答、摘要、少样本学习、代码补全和合成任务。
-
MiniLongBench 保留了与 LongBench 相同的任务多样性,覆盖六大类别和 21 个不同任务。压缩后包含 237 个测试样本,基准规模约减少 95%,同时保留长上下文评估覆盖范围。
-
压缩子集以 p = 0.95 的压缩率生成。所得基准的平均输入长度为英文数据 6193 个词,中文数据 10344 个字符,这表明保留样本在激进剪枝后仍维持相近的长上下文规模。
-
数据集来源是原始 LongBench 评估语料库。作者首先通过随机子采样实验观察到 LongBench 具有高度冗余,因为即使大幅移除样本,子集仍能与完整基准排名结果强相关。这促使采用更稳定的压缩流程。
-
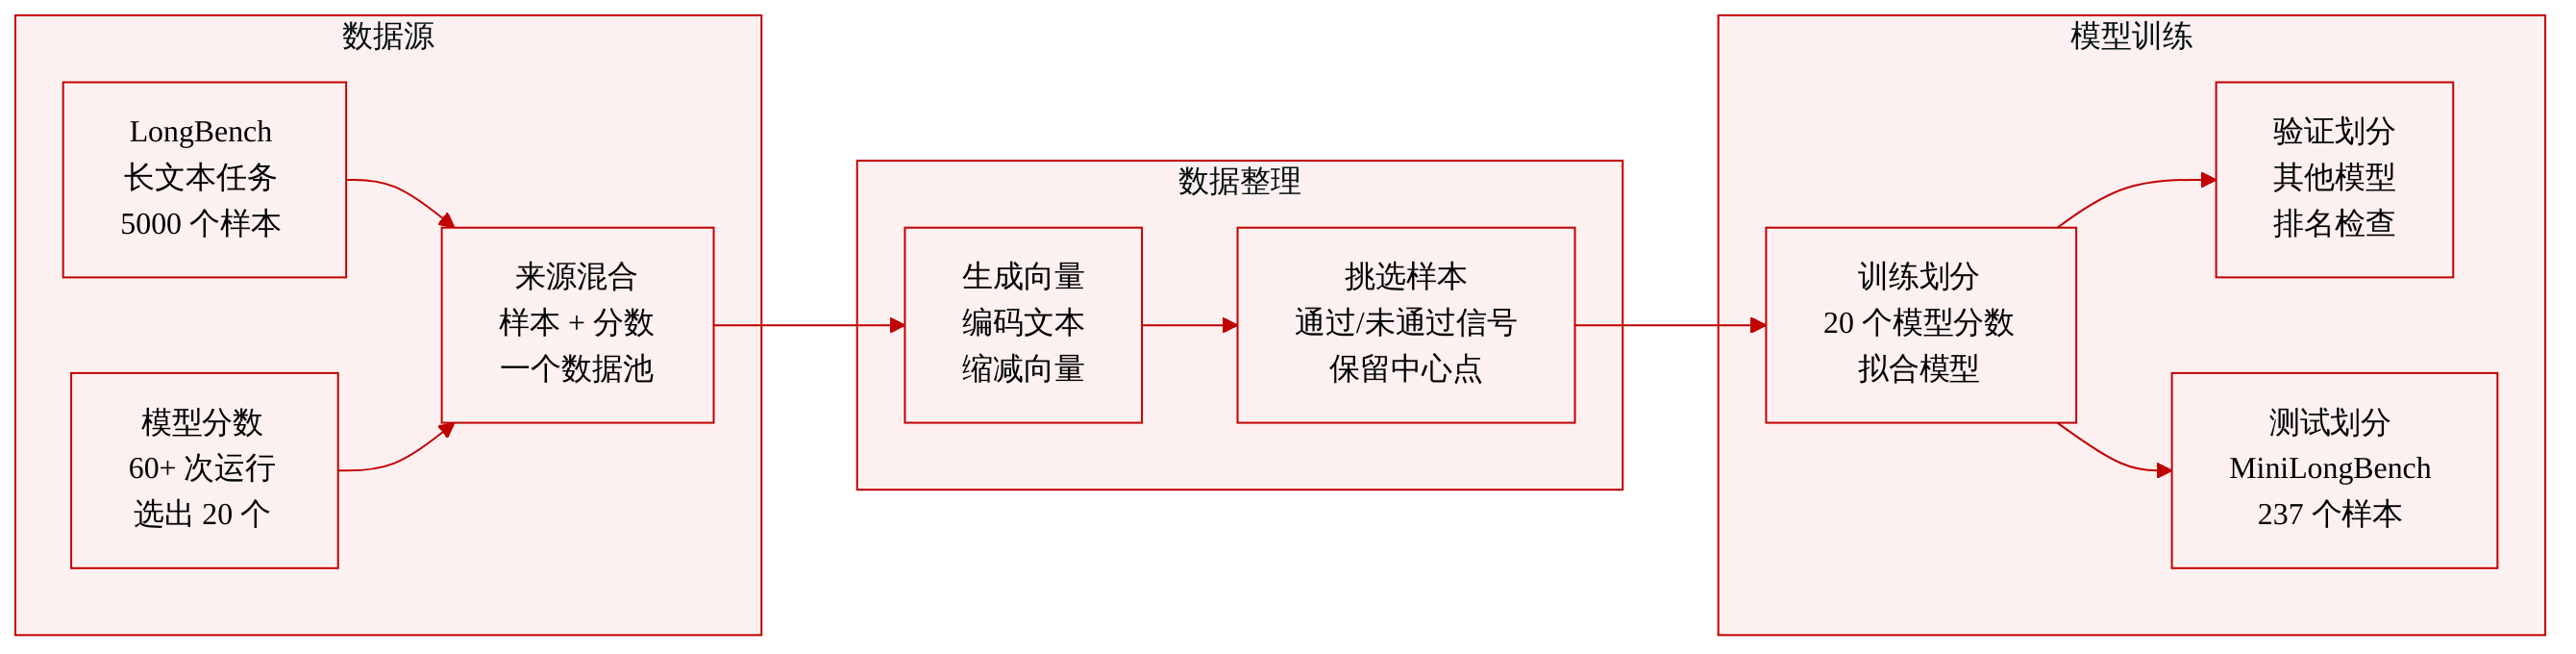
作者使用语言模型在 LongBench 上的性能记录来指导样本选择。整体上考虑 60 余个大语言模型,并选择 20 个大语言模型用于构建 MiniLongBench。其余大语言模型用于验证。作者手动选择总体表现强且覆盖面广的大语言模型,因为样本表示高度依赖模型性能记录。
-
在数据集构建过程中,原始长文本样本首先使用文本编码器嵌入,并通过主成分分析进行降维,以获得更密集的低维表示。论文将表示维度设置为 d = 10。
-
LongBench 的连续评估指标通过阈值搜索转换为二值正确性信号。这样,每个样本学到的表示都能反映模型在其上成功还是失败,随后用于识别代表性样本。
-
作者使用 K-Means 对学到的样本表示进行聚类,并保留聚类中心作为最终 MiniLongBench 测试样本。文中未描述文本裁剪或内容改写;压缩主要是样本级剪枝,其中选中的聚类中心替代更大的原始样本池。
-
构建的 MiniLongBench 用作低成本评估集,用于估计模型的长上下文能力。作者将其与完整 LongBench 排名进行比较,以表明该压缩基准能够在大幅减少输入 token 数量和计算开销的同时保持评估有效性。
方法
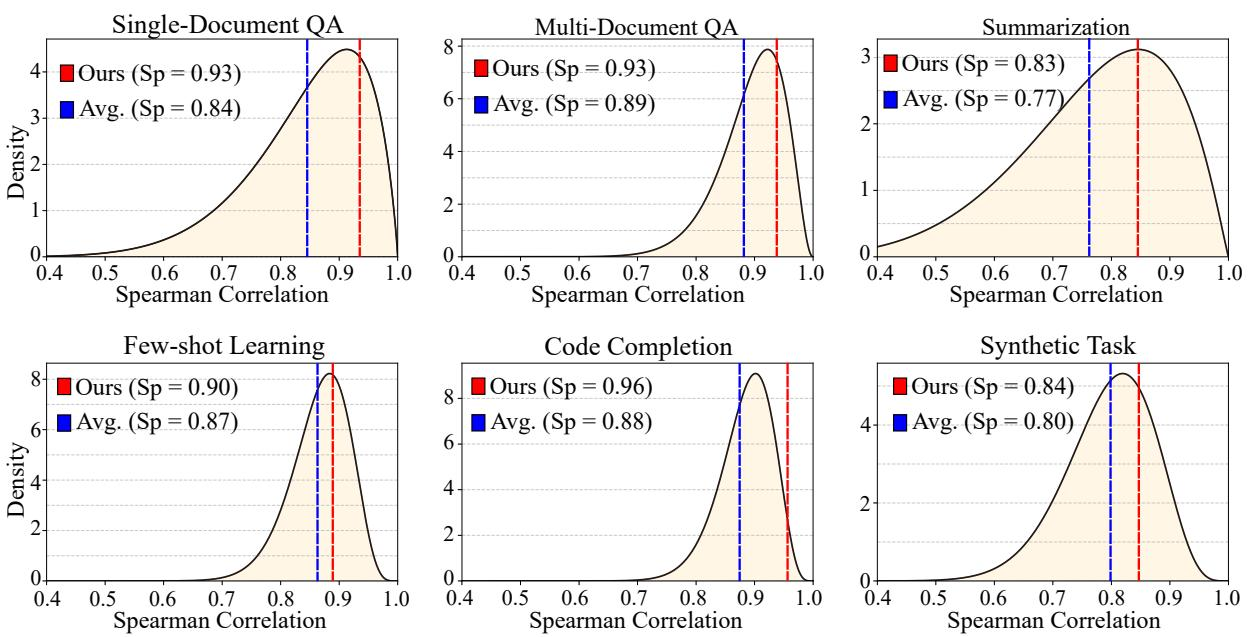
作者利用一组大语言模型在长上下文理解基准上的性能记录,构建更小且更稳定的评估子集。初始观察是,许多测试样本具有冗余性,大幅随机缩减仍可能保留排名相关性,但由此得到的估计具有较高方差。这促使采用确定性压缩流程,而不是纯随机采样。见下图:
整体方法被组织为三阶段流程。它首先将稀疏长文本输入稠密化,然后从大语言模型性能中学习样本表示,最后对样本进行聚类和剪枝,以获得紧凑基准。见框架图:
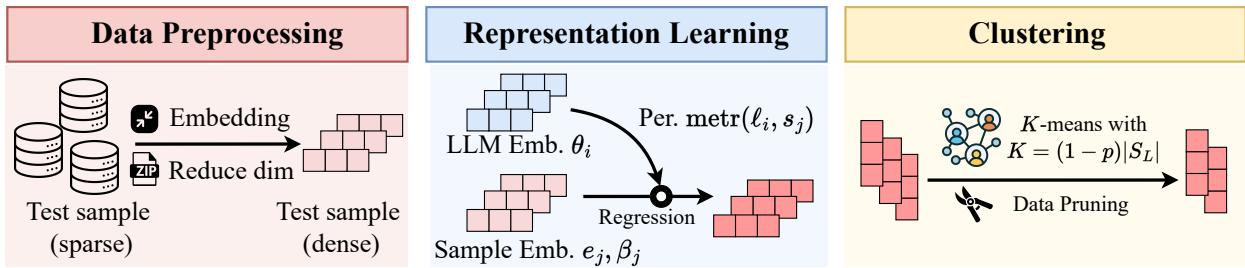
在数据预处理阶段,长文本样本的有效信息高度稀疏。为避免不稳定的表示学习,该方法首先使用长上下文文本编码器,例如 OpenAIEmbedding,对每个测试样本进行嵌入,然后应用主成分分析以获得更低维度的稠密初始化。给定测试集 SL={sj}j=1∣SL∣,初始样本表示为
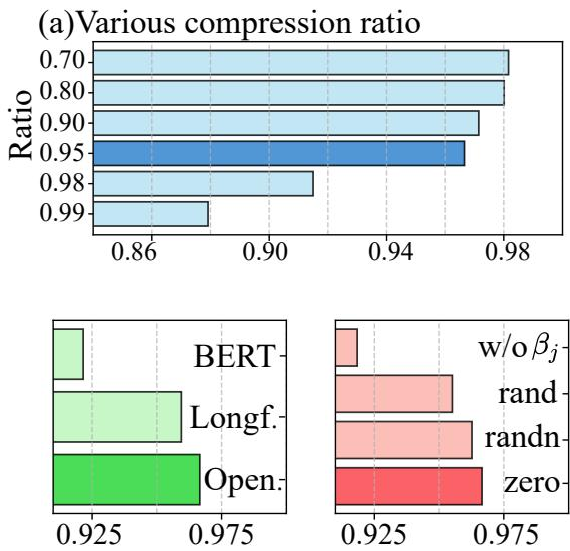
{ej}j=1∣SL∣=PCAd[{κtext(sj)}j=1∣SL∣],其中 d 在论文中设为 10。下图总结了相关设计选择,包括长上下文文本嵌入的优势,以及使用以零初始化的可学习样本偏置。
在文本侧表示初始化之后,该方法采用受项目反应理论启发的逻辑回归公式进行表示学习。对于每个大语言模型 ℓi 和每个测试样本 sj,该大语言模型正确回答该样本的概率建模为
P(metr(ℓi,sj)=1∣θi,ej,βj)=[1+exp(−ej⊤θi+βj)]−1.其中,θi 是大语言模型 ℓi 的可学习嵌入,由标准正态分布初始化。参数 ej 和 βj 是测试样本 sj 的可学习表示,其中 ej 从 PCA 得到的稠密嵌入开始,βj 初始化为零。
当原始评估指标为连续值时,例如 F1 分数或编辑距离,该方法首先归一化该指标,然后将其转换为二值标签。它通过求解近似优化问题选择阈值 c:
cmini=1∑mj=1∑∣SL∣metr(ℓi,sj)−i=1∑mj=1∑∣SL∣1[metr(ℓi,sj)≥c].找到 c 后,连续指标被替换为
metr(ℓi,sj)′=1[metr(ℓi,sj)≥c],从而使所有指标都能在相同的二值逻辑回归框架内处理。
参数 θi、ej 和 βj 通过逻辑回归训练同时更新。大语言模型嵌入作为可学习锚点,同时样本参数被推向由每个大语言模型在每个样本上的表现所塑造的表现空间。由此形成一种表示,既反映长文本样本内容,也反映参与大语言模型贡献的行为信号。
选择参与的大语言模型至关重要,因为学习得到的样本表示直接依赖于性能矩阵。选择不当的大语言模型可能无法将样本投影到有意义的表现空间。下图总结了这种敏感性,并支持选择若干总体能力较强的大语言模型来构建紧凑基准。
收敛后,每个测试样本由其学习得到的嵌入和偏置的拼接表示,即 (ej,βj)。随后,该方法使用带欧氏距离的 K-Means 进行聚类。聚类数量由期望压缩率 p 确定。具体而言,该方法保留
K=(1−p)∣SL∣个聚类中心,这些聚类中心成为压缩基准 Smini 的代表性样本。默认压缩率为 0.95,这意味着仅保留原始样本的一小部分。
对于使用该紧凑基准评估新大语言模型 ℓ0 的情况,该方法首先测量其在 Smini 中所有样本上的表现。这些分数也采用相同的归一化和离散化流程处理。然后,从标准正态分布为 ℓ0 初始化一个 d 维特征向量 θˉ,并使用来自迷你基准的学习样本参数 (ej,βj) 对其进行微调。当 θˉ 适应样本表示空间后,原始完整基准上的表现估计如下
∣SL∣1j=1∑∣SL∣[1+exp(−ej⊤θˉ+βj)]−1.该评估步骤只需要很小的已存储表示和很少计算,因为主要工作仅限于微调低维大语言模型向量,而不是在完整长基准上重新评估新模型。
实验
实验首先评估长上下文理解基准是否包含冗余,并使用 LongBench 的随机子集表明紧凑样本通常能够保留原始模型排名。随后,基于文本嵌入、降维、已评估大语言模型上的表示学习以及聚类,构建选择代表性测试案例的压缩流程。大量大语言模型上的验证表明,紧凑基准在很大程度上复现了 LongBench 排名,同时显著降低计算开销。消融实验进一步表明,足够的降维、更长的上下文嵌入、适中的压缩、可学习样本偏置以及足够的训练模型数量,对于稳定可靠的评估很重要。
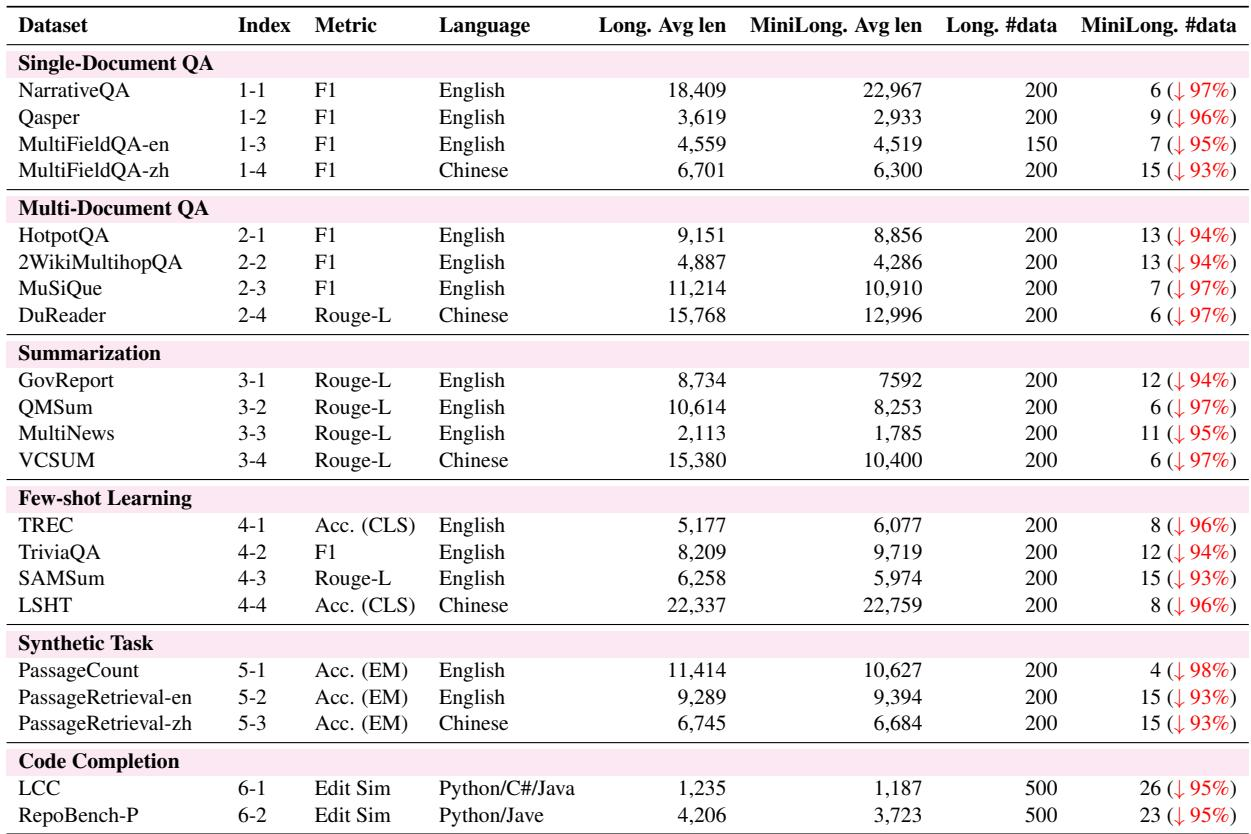
MiniLongBench 是 LongBench 的紧凑版本,通过剪枝测试样本同时保留六大任务类别和 21 个任务创建。压缩后的基准数据点数量显著更少,平均输入长度总体更低,同时仍保持相近量级的长文本输入。该设计减少了长上下文模型评估中的 token 数量和计算开销,并保留英文与中文任务的多样性。MiniLongBench 大幅减小数据集规模,与 LongBench 相比,所展示任务样本数量约下降 95%。平均输入长度通常更小,但仍处于相近规模,表明该紧凑基准仍覆盖长文本场景。
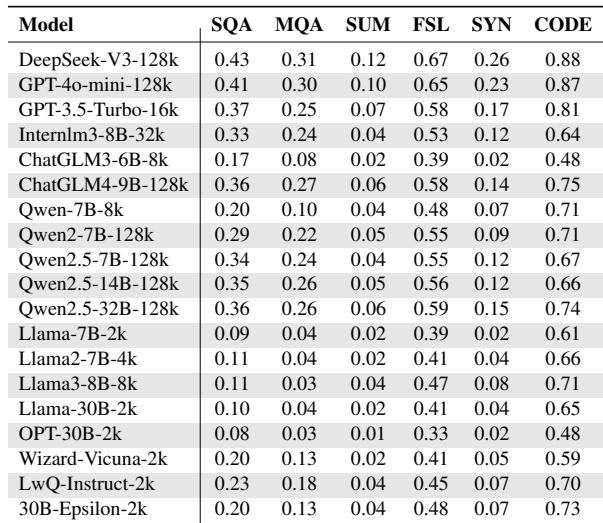
评估结果表明,MiniLongBench 能够反映紧凑长上下文任务中的模型相对优势,表现更强的 128k 模型优于更小规模或更短上下文的模型。模型能力差距在摘要与合成等推理密集任务上最大,而代码任务在各模型之间相对更容易。结果支持这一观点:MiniLongBench 能够以更低计算开销捕捉广泛的评估趋势。DeepSeek-V3-128k 和 GPT-4o-mini-128k 稳定保持任务排名领先,而更小或更旧的 8k 模型明显落后。面向代码的评估为大多数模型带来最强分数,而摘要与合成任务最具挑战性。
MiniLongBench 作为紧凑评估基准被提出,它在保留 LongBench 多样性和长输入特性的同时,大幅降低样本规模和计算开销。实验验证表明,该基准保留了长上下文模型的相对性能趋势,在 128k 高能力模型上呈现更强结果,并在摘要与合成等推理密集任务上表现出更明显的差距。