Command Palette
Search for a command to run...
Pre³:启用确定性下推自动机以加速结构化 LLM 生成
Pre³:启用确定性下推自动机以加速结构化 LLM 生成
Junyi Chen Shihao Bai Zaijun Wang Siyu Wu Chuheng Du Hailong Yang Ruihao Gong Shengzhong Liu Fan Wu Guihai Chen
摘要
大规模 LLM 应用需要高效的受约束生成能力,尤其是针对 LR(1) 文法,以生成指定格式(如 JSON)的输出。现有方法主要将 LR(1) 文法解析为下推自动机(PDA),导致运行时上下文相关词元处理存在执行开销,在大规模推理批次下尤为低效。针对这些问题,我们提出 Pre³,利用确定性下推自动机(DPDA)优化受约束 LLM 解码效率。首先,通过在预处理阶段预计算前缀条件边,Pre³ 实现了编译时的边分析,从而使并行状态转移处理成为可能。其次,利用前缀条件边,Pre³ 引入了一种新方法,将 LR(1) 转移图转换为 DPDA,消除了运行时路径探索的需要,实现了以最小开销完成边转移。Pre³ 可无缝集成到标准 LLM 推理框架中,在我们的实验中,每输出词元时间(TPOT)最多降低 40%,吞吐量最多提升 36%。我们的代码已开源在 https://github.com/ModelTC/lightllm 。
一句话总结
来自上海交通大学、北京航空航天大学与 SenseTime Research 的研究人员提出 Pre³,其通过预先计算带前缀条件的边,将 LR(1) 转换图转换为确定性下推自动机,实现提前并行边分析,并消除运行期路径探索,从而在结构化 LLM 解码中使每次输出 token 的耗时最多减少 40%,吞吐量提升 36%。
核心贡献
- Pre³ 是一个面向使用 LR(1) 语法的受约束 LLM 生成的确定性下推自动机框架,它预计算带前缀条件的边,以支持提前边分析和并行转换处理。
- Pre³ 使用考虑循环的构造方法,将 LR(1) 转换图转换为 DPDA,利用带前缀条件的边消除运行期路径探索,并把 LR(1)-to-DPDA 解析引入 LLM 解码。
- 实验将 Pre³ 集成到标准 LLM 推理框架中,使每次输出 token 的耗时最多降低 40%,吞吐量提升最多 36%,在大批量规模下相比以往结构化生成方法具有更大优势。
引言
大语言模型越来越多地需要结构化输出,例如用于函数调用、工具使用和具身 AI 的 JSON。受约束解码通过在生成期间遮蔽非法 token 来支持这一需求,而 LR(1) 语法能够灵活处理复杂递归格式。然而,XGrammar 等先前加速方法将 LR(1) 语法转换为非确定性下推自动机,导致运行期回溯、推测性检查、栈管理以及大批量规模下扩展性不足。作者利用 LR(1) 语言的确定性特性,提出 Pre^3,一种直接从 LR(1) 语法构建确定性下推自动机的受约束解码方法。该方法消除了非确定性转换,支持更充分的预处理,支持并行转换验证,并在不牺牲模式保真度的情况下改善每次输出 token 的耗时和吞吐量。
方法
作者提出 Pre3,一种在生成前将给定 LR(1) 语法转换为确定性下推自动机的受约束解码框架。该流程首先从语法推导 LR(1) 状态转换图,然后构建一个 DPDA,其转换编码解析进度和栈操作,最后利用该自动机在运行期从 LLM 中遮蔽非法 token。参考下方框架图。
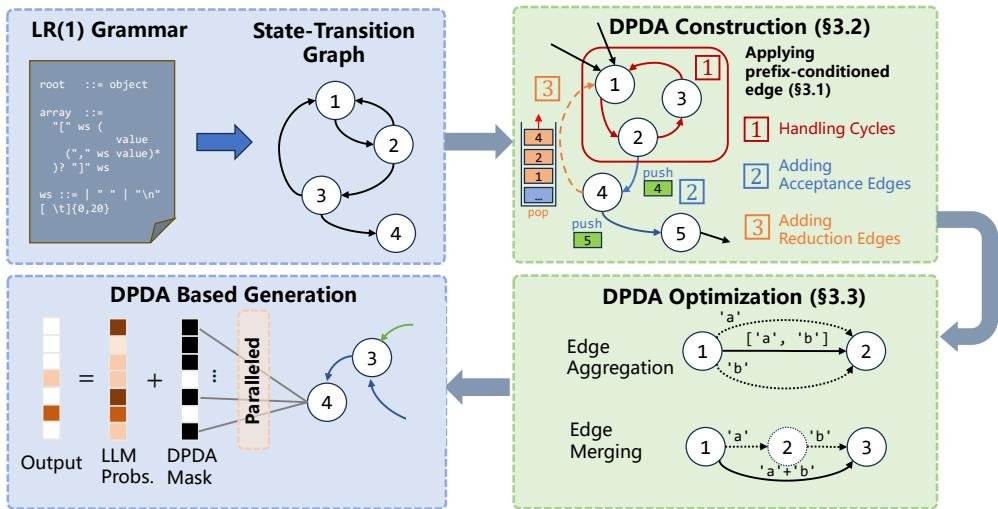
由于该构造仅执行一次并可缓存,复杂语法的语法预处理仅需数秒,简单语法不到一秒。在解码时,DPDA 维护解析器状态和栈,确定合法下一步动作,并将相应 token 约束提供给 LLM 生成循环。
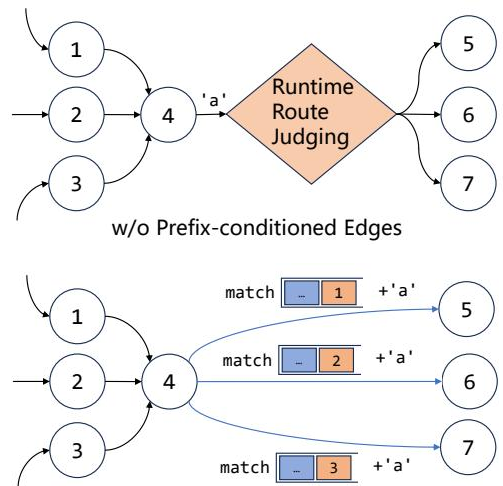
核心设计选择是消除非确定性,否则解码期间需要推测性探索和持续栈检查。作者利用 LR(1) 语法的一个性质:当前栈配置和下一个前瞻符号唯一决定下一个解析动作。因此,他们用带前缀条件的边机制标注每个转换,其中一条边由接受符号、必须匹配的栈条件以及转换期间执行的栈操作来标识。在确定性结构生成后,并行检查可验证多个栈条件,从而消除歧义。如下图所示,原本需要运行期路径判断的 token 在边携带显式栈匹配条件后变为确定性。
自动机由 LR(1) 状态转换图构建,其中每个节点代表一个 LR(1) 项目集,原始边代表接受符号的移进转换。该构造保留这些状态,但将转换分为接受边和归约边。接受边对应移进:消费输入符号,将新状态压入栈,并移动到目标状态。归约边直接编码归约端点之间的归约转换,在涉及嵌套语法规则时避免重复的低层归约步骤。每种边的作用见下图。
接受边从 LR(1) 状态图继承,且不需要额外确定性处理,因为 LR(1) 构造防止同一状态出现重复的相同转换。当此类边被采用时,目标状态信息会被压入运行期栈。归约边通过两阶段过程添加。首先,识别无条件 epsilon 归约,并沿状态图递归传播,沿路径弹出状态,直到到达归约目标。由于这些边不消费输入符号,它们可能引入歧义,因此随后与兼容的接受边合并,对齐栈操作和归约目标,同时分配必要的接受 token 或前缀条件。
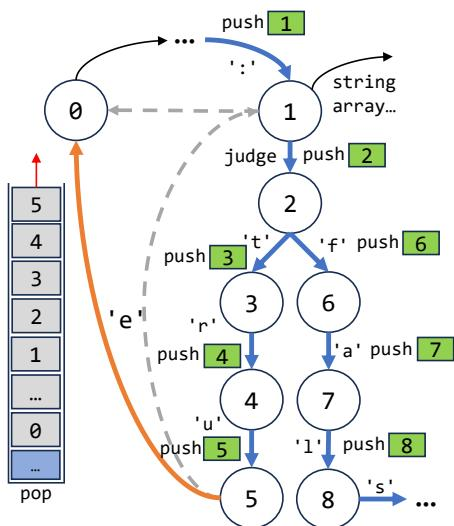
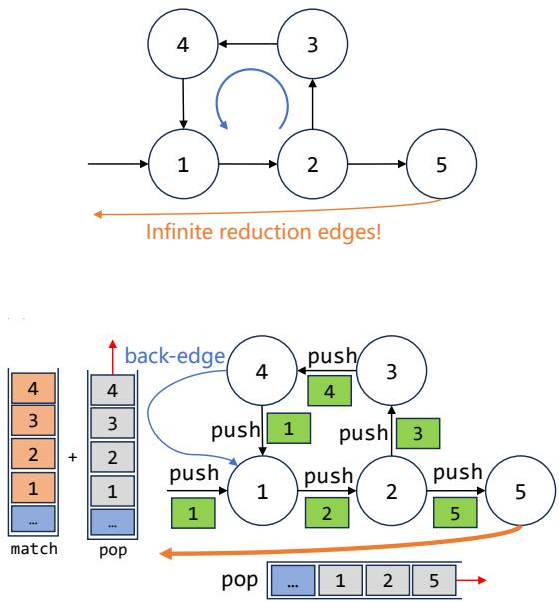
主要构造挑战是 LR(1) 状态图中存在环。如果简单展开归约边,重复遍历环可能生成无限多条归约路径。作者观察到,对于一次归约,指定入口节点和出口节点即可唯一确定相关归约上下文,与环被遍历多少次无关。对于环 C=(s1,s2,…,sn,s1) 及后向边 sn→s1,他们修改后向边,使其在检测到完整遍历时弹出环状态序列 (s1,s2,…,sn)。自动机检查是否某次遍历的所有状态均已存在于栈中;如果是,则移除冗余的环上下文,确保重复遍历不会累积不必要状态。环处理机制见下图。
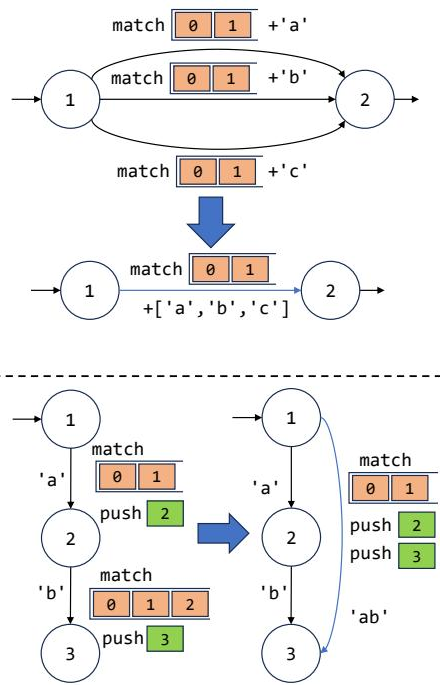
一旦 DPDA 具有确定性,且所有转换均由栈条件和输入符号完全指定,就可以进行额外预处理优化。具有相同栈匹配条件和栈操作、仅接受符号不同的边可以被聚合,例如将多个数字转换合并为一个 token 类。在兼容条件下可连续执行的边也可以合并为更长的跳转,减少自动机必须访问的中间状态数量。这些操作缩小最终 DPDA 并提升受约束解码效率。优化模式见下图。
实验
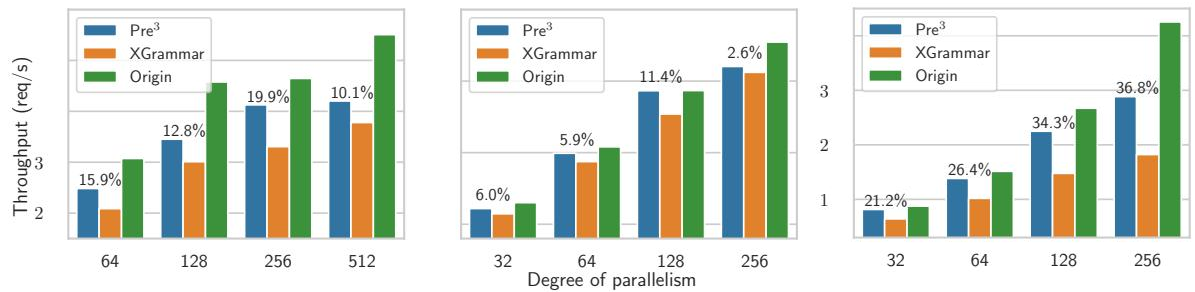
评估将该实现集成到 LightLLM,并在 H800 GPU 服务器上使用以 JSON 为主的提示词和额外私有数据,与 XGrammar、Outlines 和 Llama.cpp 进行比较。实验评估每步语法约束解码开销、大批量推理效率,以及不同并发度下的真实世界吞吐量,验证效率与部署可扩展性。定性上,Pre3 相比先前系统始终引入更少的语法相关开销,并在批量大小和并发度增加时保持竞争力,表明其在结构化生成中具有稳健的端到端可扩展性。
每次 token 延迟随着批量大小增加,无论无约束解码还是使用 XGrammar 的受约束解码都如此。受约束方法在所有测试批量大小下延迟均高于基线,并且随着批量大小增加,差距更加明显。这一趋势支持了受约束解码可能因不可并行验证开销而产生扩展瓶颈的论点。受约束解码在每个测试批量大小下仍比无约束解码慢。延迟差异随批量大小增加,表明受约束方法扩展性下降。
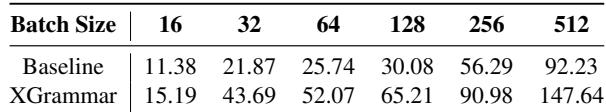
在测试模型和大批量规模下,Pre^3 在复杂 JSON 约束生成中的解码时间少于 XGrammar。该优势在高批量大小下依然可见,而某些极大批量情况无法在可用硬件设置上执行。在报告的大批量评估中,Pre^3 一致地提供比 XGrammar 更低的推理延迟。运行时收益尤其适用于大批量规模和更大的模型配置。
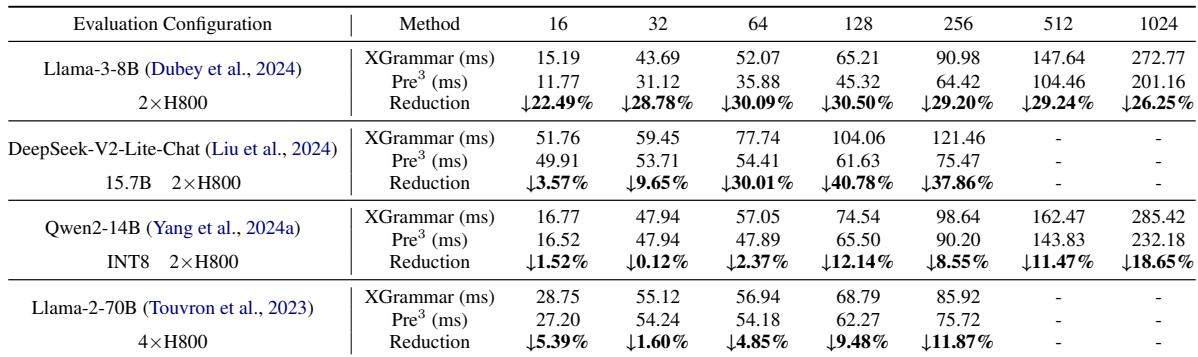
在测试的模型和批量大小中,Pre^3 的每步解码时间始终少于 XGrammar。优势在批量大小 1 时出现,并在批量大小 4 的 Llama-3-8B 上更明显。这些结果支持 Pre^3 比先前结构化生成系统引入更低约束解码开销的论点。对于 Llama-3-8B 和 Llama-2-70B,Pre^3 的每步解码时间均低于 XGrammar。对于 Llama-3-8B,批量大小 4 下的解码时间差距大于批量大小 1 下。
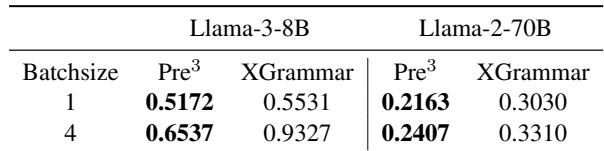
实验评估在无约束解码、XGrammar 受约束解码和 Pre^3 下,跨模型和批量大小进行 JSON 约束生成时的每次 token 延迟。结果表明,受约束解码在所有批量大小下仍比无约束解码慢,并且随着批量大小增加差距扩大,表明验证开销导致扩展瓶颈。相比之下,Pre^3 的每步解码时间始终低于 XGrammar,优势在更大批量大小和模型规模下更明显,支持更低结构化生成开销。