Command Palette
Search for a command to run...
从电路到乔姆斯基:基于形式语言的预预训练赋予模型语言归纳偏置
从电路到乔姆斯基:基于形式语言的预预训练赋予模型语言归纳偏置
Michael Y. Hu Jackson Petty Chuan Shi William Merrill Tal Linzen
摘要
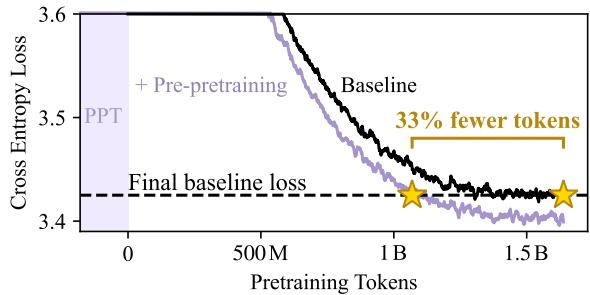
在形式语言上预训练语言模型可以提升其对自然语言的习得效果。究竟是形式语言的哪些特征注入了促成有效迁移的归纳偏置?结合语言学洞见与复杂性理论的启示,我们假设:当且仅当以下两个条件同时满足时,有效迁移才会发生——形式语言应捕捉自然语言中存在的依赖结构,且不应超出模型架构的计算限制。我们在 Transformers 上实验了预预训练(即在自然语言训练之前先于形式语言上训练),发现捕捉层级依赖的形式语言确实能使语言模型在自然语言上实现更低的损失和更好的语言泛化能力,相较于其他形式语言表现更优。我们也发现了有限的支持证据,表明形式语言应落在架构的计算限制范围内。值得注意的是,预预训练比在等量自然语言上训练能更高效地降低损失。对于一个在约 16 亿 token 的自然语言上训练的 10 亿参数语言模型,预预训练仅需减少 33% 的 token 预算即可达到相同的损失和更好的语言泛化能力。最后,我们还提供了从形式语言到自然语言迁移的机制性证据:预预训练阶段获得的注意力头对于模型在句法评测中的表现仍然至关重要。
一句话总结
纽约大学研究人员表明,在自然语言预训练之前,先于能够捕捉层级依赖的形式语言上对 Transformer 进行预预训练,可以使 1B 参数模型少用 33% 的 tokens 达到相同损失,而在此阶段获得的注意力头在句法评测中仍然至关重要。
核心贡献
-
论文引入了形式语言预预训练,其中 Transformer 在自然语言之前先在形式语言上训练,并提出一个迁移假设:形式语言应当在保持在 Transformer 计算限制之内的同时捕捉层级依赖,这一限制通过 C-RASP 进行分析。
-
实验表明,与形式语言相比,在具有层级依赖结构的形式语言上进行预预训练会降低自然语言损失并改善语言泛化;对于有效迁移取决于形式语言是否保持在 C-RASP 级计算限制之内的假设,支持证据有限。
-
对于在大约 1.6B 自然语言 tokens 上训练的 1B 参数模型,使用小 33% 的 token 预算即可通过预预训练达到相同损失和更好的语言泛化,并且在预预训练期间获得的注意力头对句法评测性能仍然至关重要。
引言
语言模型极其依赖数据,通常需要比人类多得多的示例才能达到强性能,这限制了低资源训练、习得的认知建模,以及在常见网页数据被大幅消耗之后继续扩展。先前工作引入了形式语言预预训练,作为教授有用归纳偏置的一种方式,并表明表达能力更强的 Chomsky 层级类别可以提供帮助;但 Chomsky 层级本身对 Transformer 而言只是不完整指南,因为一些形式上合法的语言无法被 Transformer 学习或进行长度泛化。作者对此提出,有效预预训练取决于形式语言表达能力与 Transformer 电路复杂度的交集,并使用 C-RASP 定义能够捕捉层级依赖且仍可被 Transformer 学习的语言。结果表明,在这些语言上进行预预训练可以改善自然语言 token 效率、复用已学习的注意力机制,并扩展至 1B 参数模型。
数据集
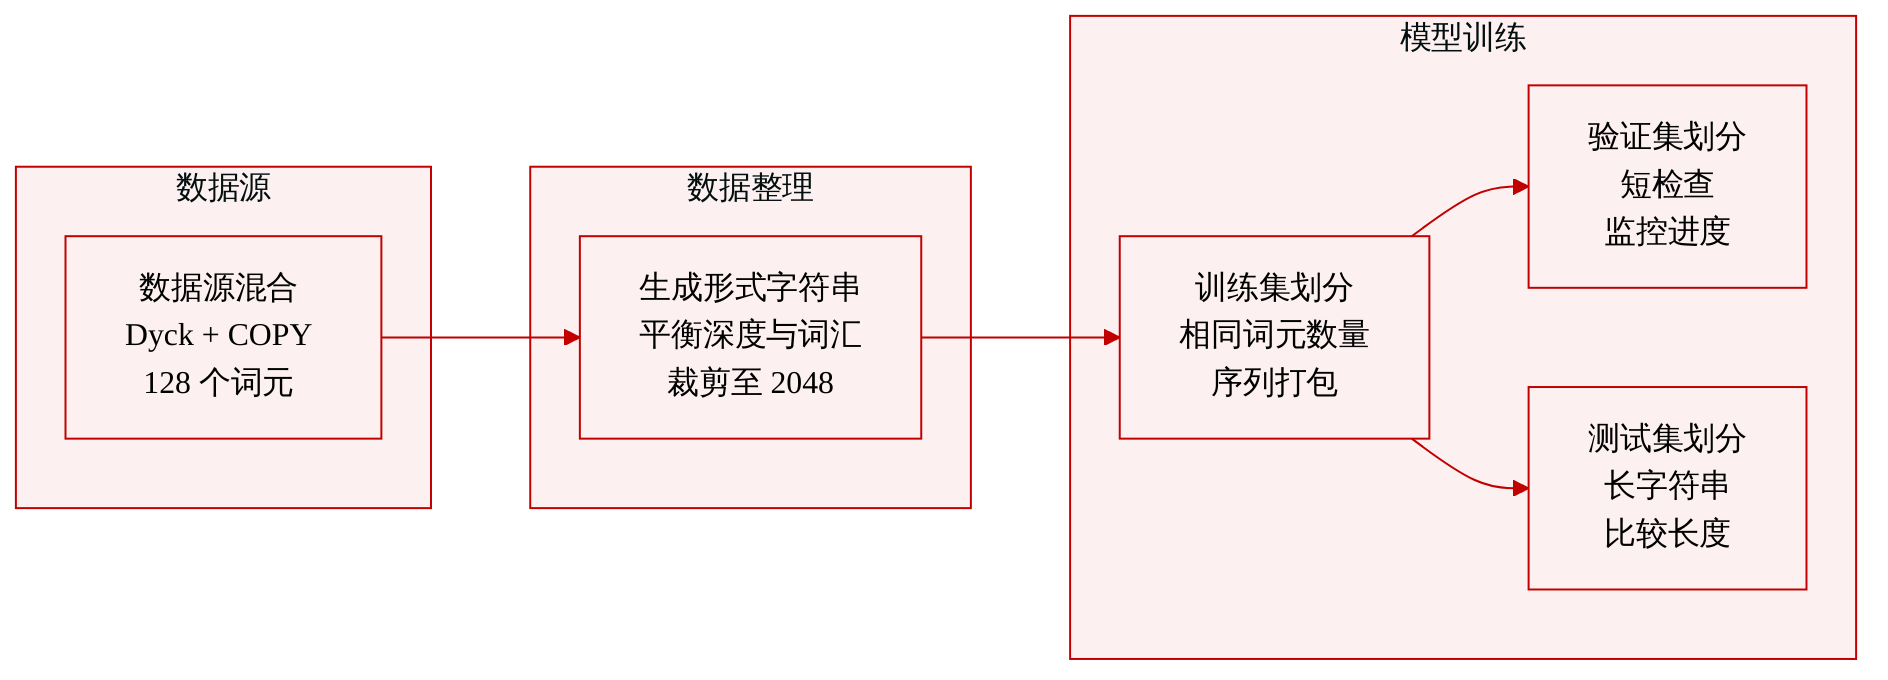
• 来源与组成:作者使用为 Transformer 语言模型预预训练而合成的形式语言语料。数据集包含四种形式语言:1-Dyck、k-Dyck、k-Shuffle Dyck 和 COPY。前三种建模嵌套层级结构,而 COPY 使用从字符串前半部分到后半部分的固定依赖。
• 1-Dyck:单一类型嵌套括号,上下文无关且可由 C-RASP 定义。字符串通过以概率 0.5 随机开启或关闭括号生成,产生调和深度分布,并在 2048 处截断。其深度分布在 Dyck 变体之间匹配。
• k-Dyck:k 种括号类型,上下文无关且属于 FO(M),但不属于 C-RASP。主要设置使用 k=64,产生 64 个括号对和 128 个独特词表 tokens。该语言通过把有效 1-Dyck 字符串中的成对括号替换为新括号对,作为 1-Dyck 的扩展来构造。
• k-Shuffle Dyck:带有交叉串行依赖的 k-Dyck,上下文相关且可由 C-RASP 定义。它也使用 k=64、64 个括号对和 128 个独特词表 tokens。可以将其视为交错多个 1-Dyck 序列,同时与其他 Dyck 语料保持匹配的深度统计。
• COPY:复制语言,上下文相关且属于 FO(M),但不属于 C-RASP。它使用 128 个独特词表 tokens,以及将字符串前半部分复制到后半部分的固定映射。它与 k-Shuffle Dyck 形成对比,因为其所有依赖都是交叉串行而非嵌套。
• 过滤与裁剪:所描述的生成规则包括随机开启或关闭括号、在各 Dyck 变体间匹配深度分布、在指定处将词表匹配为 128 tokens,以及截断到 2048 tokens。文本未说明整体语料规模、训练划分、验证划分或额外过滤规则。
• 使用方式:所有模型都在相同数量 tokens 上进行预预训练,并使用序列打包。这些语料用于测试同时可由 C-RASP 定义的层级结构语言是否为学习更长字符串提供了更好的归纳偏置。
方法
作者采用两阶段训练框架,在自然语言预训练之前使用形式语言预预训练来初始化 Transformer 语言模型。从高层视角看,训练被表示为一个优化过程 A(D,t,θinit),它在数据集 D 上经过 t 次梯度更新后返回模型参数 θt。该流水线被划分为两个连续阶段。首先,模型在形式语言数据集 Dppt 上预预训练 t0 步,得到参数 θt0。其次,这些参数直接迁移到自然语言预训练中,其中模型在 Dpt 上训练 t1 步,得到 θt1。
下游目标是固定的,与预预训练选择无关。预训练阶段寻求能够最小化自然语言预训练数据上期望语言建模损失的参数,
θt1⋆=argθt1minE[ℓ(Dpt,θt1)].由于预训练数据集 Dpt、预训练步长 t1 和优化器超参数保持固定,该方法将预预训练数据集 Dppt 和预预训练时长 t0 视为主要研究变量。这使得实验设计明确聚焦于:形式语言初始化能否比从一开始自然训练产生更好的起始权重。
作者将提出的形式语言预预训练与若干基线进行比较。一个基线通过设置 t0=0 完全移除预预训练。其他基线在随机二进制字符串或随机整数字符串上进行预预训练,在所报告的比较中 t0=500 步。最后一个基线在与最终预训练语料同分布的未见自然语言数据 Dpt∗ 上进行预预训练。作者指出,这个自然语言预预训练基线并不等同于简单地在 Dpt∗ 与 Dpt 的并集上训练更长时间,因为先预预训练再预训练会进行两次学习率预热,每个阶段各一次。
形式语言的选择受到表达能力假设的引导:一个有帮助的预预训练语言应当结合与自然语言相似的层级结构和 Transformer 式电路的可学习性,尤其是在所学结构需要泛化到比训练期间观测到的更长序列时。为验证这一点,该方法评估位于经典形式语言和电路复杂度层级中不同位置的形式语言。一个例子是 1-Dyck,即嵌套括号语言,它上下文无关且可由 C-RASP 定义。另一个是 k-Dyck,它包含 k 种不同括号类型;它上下文无关,位于带多数量词的一阶逻辑之内,但不在 C-RASP 内。第三个例子是 k-Shuffle Dyck,它引入交叉串行依赖,属于上下文相关,同时仍可由 C-RASP 定义。最后,该方法评估复制语言,这是一种上下文相关语言,与 k-Dyck 属于同一逻辑电路邻近类别,但不属于 C-RASP。
这些语言被刻意设计为相关。Dyck 变体强调层级嵌套。k-Dyck 语言可视为 1-Dyck 的扩展,其中单一括号类型被多种成对类型替换;而 k-Shuffle Dyck 可视为若干 Dyck 序列的交错,并带有交叉串行依赖。复制语言形成对比,因为其依赖具有强交叉串行性,并将字符串前半部分映射到后半部分,而不是形成嵌套层级模式。这种设计使该方法能够分离层级、交叉串行结构和电路表达能力的影响。
形式语言语料的构建目的是保持受控比较。对于 1-Dyck、k-Dyck 和 k-Shuffle Dyck,序列通过以概率 p=0.5 随机开启或关闭括号生成,产生深度上的调和分布。生成的序列在长度 2048 处截断。相关语料的词表大小也相匹配。k-Dyck、k-Shuffle Dyck 和复制语言语料各使用 128 个独特词表项。对于基于 Dyck 的语料,这对应 64 个独特括号对,得到 k=64。所有模型都在相同数量的 tokens 上进行预预训练并使用序列打包,因此验证损失和下游评测中的差异反映语言结构和初始化效应,而非 token 数量。
评测设计包含三个主要部分:验证损失、语法性判断和逐字检索。基于自然语言预训练目标的验证损失测试形式语言初始化是否改善模型预测最终预训练目标的能力。在语法性方面,使用仅在语法性上不同的最小对立体句子对模型进行评估。模型被评估为是否对合语法句子赋予比不合语法句子更高的似然。准确率计算为这种偏好正确的最小对立体比例。逐字检索评估模型能否在重复词表第二次出现时对其赋予非常高似然,较低损失表示更强的模式复现。这些评测共同探究模型是否学会识别并应用一致模式,而形式语言预预训练可能增强这一能力。
该方法还通过形式语言步数与自然语言预训练步数之间的边际替代率来量化预预训练的计算效率。该设置询问,在达到相同最终损失的情况下,固定数量的形式语言预预训练步数可以替代多少仅自然语言训练步数。令 x 表示预预训练步数,y 表示自然语言预训练步数。如果两个训练计划达到相近损失,则边际替代率为
MRS=∣x1−x2∣∣y1−y2∣.例如,如果计划 (x,y)=(0,10000) 和 (x,y)=(500,6000) 达到相同损失,则
MRS=∣0−500∣∣10000−6000∣=8.相应的 token 效率增益为
1−100006000+500=35%.因此,理想的预预训练语言应当在只需要少量预预训练步数的同时,降低自然语言预训练后达到的损失。因此,整体流水线将形式语言初始化阶段、固定的自然语言预训练阶段,以及旨在同时测量语言泛化和训练效率的受控评测指标结合在一起。
实验
实验在自然语言之前先用形式语言对小 Transformer 模型进行预训练,并比较验证损失、语法性、子网络消融、metamer 控制实验和扩展规模实验,以检验哪些迁移性质重要。结果发现,带有层级依赖的形式语言,尤其是 shuffle Dyck,相比可比自然数据或更简单的非层级字符串,更能改善自然语言建模和语法性;而复制语言和随机字符串没有帮助或有害。机理消融表明,在形式语言预训练后选择的注意力头在自然训练之后仍然重要,这暗示存在用于层级结构的可复用子网络;收益在 1B 参数下仍然存在,并且对 C-RASP 表达能力仅有有限证据。
该表格展示了用于预预训练的形式语言示例,包括嵌套括号结构和重复字符串。具有层级依赖的语言,尤其是基于括号的 Dyck 语言,与更好的语言建模和语言泛化相关。相比之下,重复复制语言缺乏层级,用作预预训练时与有害效应相关。示例包括嵌套括号、混合括号序列和重复字符串。层级括号语言往往比非层级字符串重复提供更强归纳偏置。shuffle 括号语言表现强劲,同时比其它测试语言需要更少的预预训练。
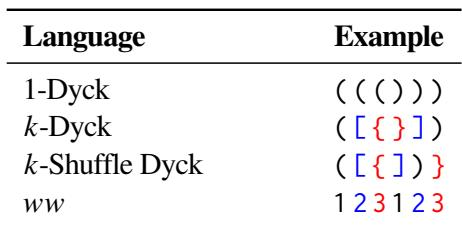
这些实验评估形式预预训练语言,将层级括号结构与非层级重复字符串模式进行比较。层级 Dyck 式括号语言提供更强的归纳偏置,并与更好的语言建模和语言泛化相关。相比之下,重复复制数据缺乏层级结构,可能有害,而 shuffle 括号语言表现强劲,并且比其它测试语言需要更少的预预训练。