Command Palette
Search for a command to run...
迈向犬类音标字母表的自动发现
迈向犬类音标字母表的自动发现
Theron S. Wang Xingyuan Li Hridayesh Lekhak Tuan M. Dang Mengyue Wu Kenny Q. Zhu
摘要
狗通过发声进行智能交流,然而其交流的语音特性仍鲜为人知。本文介绍了一种受人类语音发现过程启发的迭代算法,利用最小对立对来识别不同的犬类认知语音单元,并构建一个全面的犬类音标字母表。此外,该算法还推导出与特定环境和活动表现出结构化关联的犬类发声模式,暗示了潜在的有意义交流模式。我们的方法为分析非人类发声系统提供了一个新颖框架,并可能将应用扩展到犬类以外的其他动物物种,从而推进跨物种交流的研究。
一句话总结
德克萨斯大学阿灵顿分校和上海交通大学的研究人员提出了一种基于最小对立对的迭代算法,能够自动发现犬类语音字母表,识别不同的认知发声单元,并推导出与活动相关的发声模式,从而为分析非人类发声系统提供了一种新框架,具有推广至其他动物物种的潜力,并推动跨物种交流研究的发展。
核心贡献
- 提出了一种受人类语音发现过程启发的迭代算法,利用最小对立对从原始狗吠声中识别不同的犬类认知发声单元,并构建语音字母表。
- 推导出与特定环境和活动具有结构化关联的犬类发声模式,表明其可能存在有意义的交流模式。
- 实验结果显示,42%的发声单元经人工评估被验证为不同的认知单元,11%的模式具有较高的上下文特定似然度,且发现的模式符合齐普夫定律,该框架设计为可扩展至其他动物物种。
引言
理解动物发声交流是一项复杂的挑战,其中的关键环节在于识别动物叫声中可能存在的基本语音单元。这些单元虽然本身不构成完整语言,但却是探索发声中所蕴含的语法或语义结构的基础构件。近年来,机器学习的发展为这一"动物语言"研究领域带来了更细粒度、数据驱动的研究途径,但此前的尝试遇到了显著障碍。一些方法强行将动物声音映射到人类国际音标中,忽略了物种间根本的声学差异。另一些方法在数百种不同动物上训练跨物种转录系统,产生的粗粒度模型无法捕捉物种特有的发声特征。与此同时,将 HuBERT 等自监督模型应用于狗音频时,经常将背景噪声误判为真实发声,而针对抹香鲸咔嗒声的专门方法则过度局限于该物种独特的发声机制。
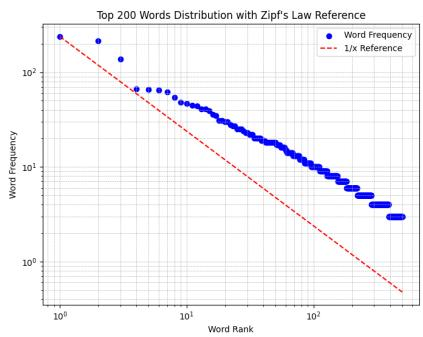
为弥补这些不足,作者提出了一种迭代方法,能够同时从大规模狗吠声语料库的含噪声、不精确符号转录中筛选出合格的犬类认知发声单元(类似于人类音位)和犬类发声模式(类似于词语)。该方法借鉴了人类语言学中的最小对立对原理,用于过滤非发声符号,并合并声学上和语义上相似的符号。作者的贡献包括构建了迄今最大的狗吠声数据集,包含来自六个品种的152小时纯净狗吠声,并提出了一种迭代发现算法,从6285小时的YouTube视频中提取出105个不同的犬类认知发声单元和69个发声模式。人工验证评估显示,42%的已发现发声单元是独立的认知单元,11%的发声模式极有可能出现在特定上下文中,且发现的模式分布紧密遵循齐普夫定律。
数据集
数据集构成与来源
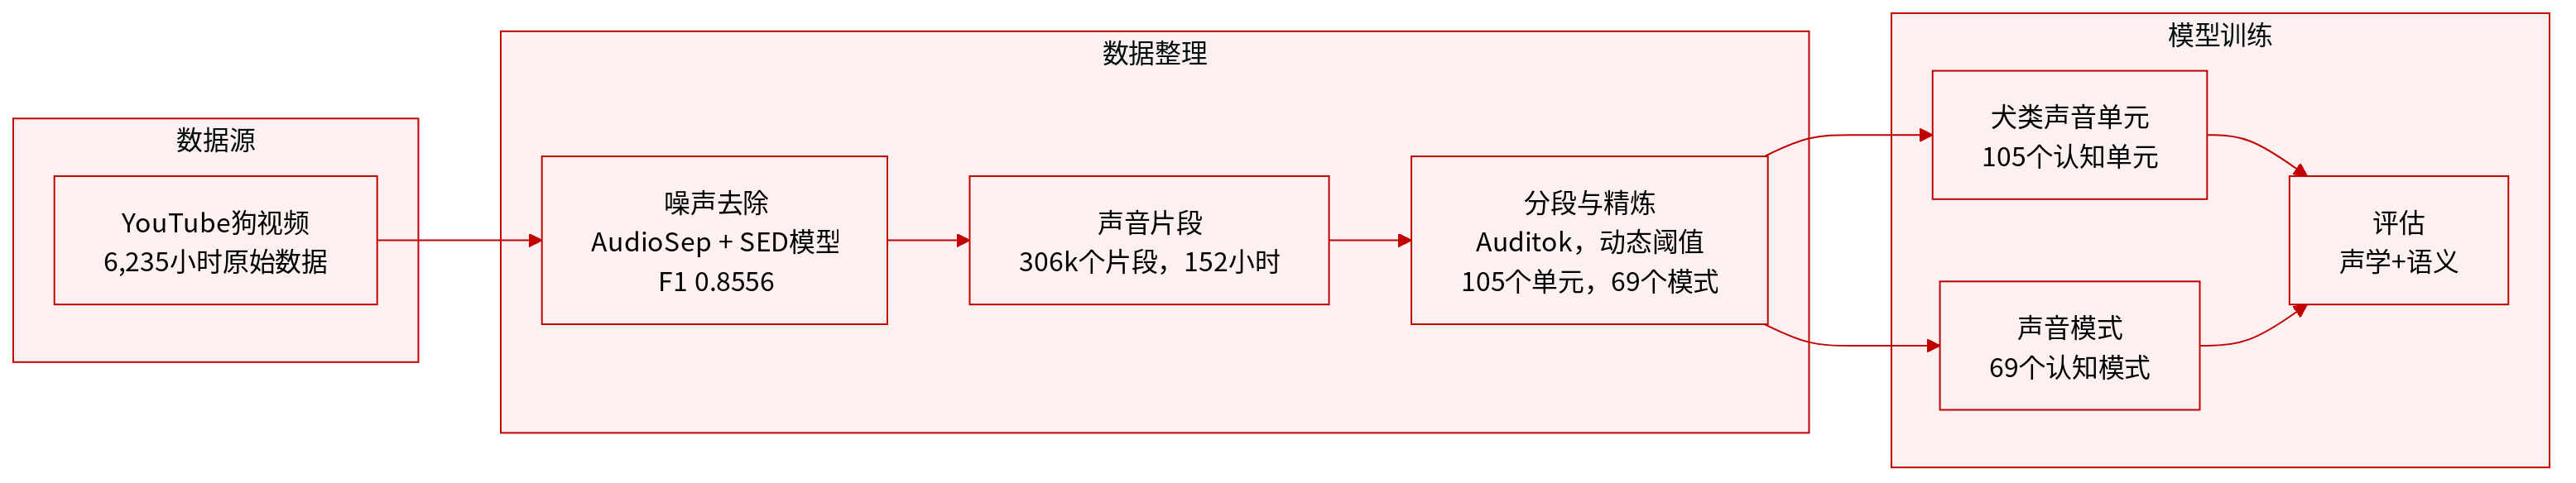
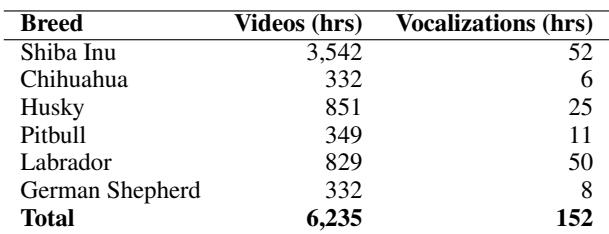
- 作者完全从YouTube狗视频构建数据集,原始素材总计6235小时。
- 由于这些视频通常包含背景音乐、人声和其他非犬类噪声,原始素材污染严重,在使用前需要大量清理。
预处理与过滤流程
- 噪声去除: 作者使用AudioSep去除视频数据中的杂散声音。
- 犬类发声检测: 使用微调后的DCASE2023 Challenge Task 4基线模型进行声音事件检测(SED),将默认编码器替换为预训练的BEATs编码器以提高检测性能。
- SED后训练: 为提升准确性,作者手动标注了超过9000秒的纯净狗发声数据,并用于对SED模型进行后训练,在测试集上达到0.8556的F1分数。
- 提取结果: 经过该流程后,作者从原始的6235小时中获得了306233个犬类发声片段,总计约152小时的纯净狗吠声。
发声模式切分
- 作者使用Auditok库通过检测基于能量的静音来切分连续的犬类发声,识别出自然的停顿边界并生成候选发声模式。
- 动态阈值: 对于每一段发声,切分阈值计算为可调系数ρ与完整音频片段的均方根(RMS)能量的乘积。作者经验性地探索了一系列ρ值,并手动选择在开发集上产生最一致切分效果的值。
- 由于动物发声不存在预定义的词典,这些基于能量的片段被用作发声模式的代理。
转录与精化结果
- 转录流程最初产生250个候选发声单元。
- 对每个单元随机抽取10个样本进行人工检查,将250个中的52个标记为噪声,198个标记为合法发声。
- 经过迭代精化后,单元库存缩减至105个认知发声单元(其中仅有22个仍被标记为噪声)和69个认知发声模式。
- 精化过程消除了26个噪声单元,另有4个在发声模式切分阶段被移除,证明了迭代去噪的有效性。
数据的使用方式
- 完整数据集经过预处理、切分和精化阶段,以构建最终的犬类语音字母表。
- 105个认知发声单元和69个认知发声模式是用于声学和语义评估的核心输出。
- 发声模式被检验其上下文显著性以支持最小对立对分析,但并非流程的主要输出。
方法
作者采用数据驱动的方法,通过多阶段流程揭示犬类语音字母表。整体框架包含三个主要步骤:预处理、转录和发声单元精化。
参考框架图
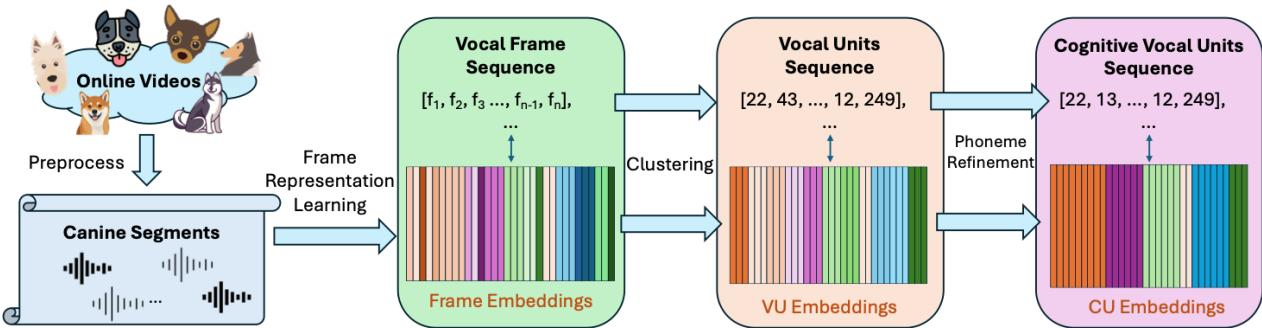
在预处理阶段,系统从原始音频轨道(如在线视频中的音频)中提取干净的犬类发声片段,这些原始音频通常含有背景噪声。作者使用AudioSep去除无关噪声,并使用基于DCASE2023 Challenge Task 4基线的微调声音事件检测模型。为提升检测性能,默认编码器被替换为预训练的BEATs模型,系统还在人工标注的犬类发声数据上进行了后训练。犬类发声片段定义为以超过0.5秒的停顿为边界的连续发声。
转录阶段将这些片段转换为表示犬类发声单元的符号序列。作者在犬类片段上训练自监督音频表示模型HuBERT,为每个20ms音频帧获取帧嵌入。这些帧被聚类为K个簇,K通过肘部法确定。簇中心作为唯一音位的特征嵌入,并分配唯一符号以形成初始认知发声单元。
最后阶段使用最小对立对方法将这些单元精化为最终的认知发声单元集合和发声模式。
参考精化算法
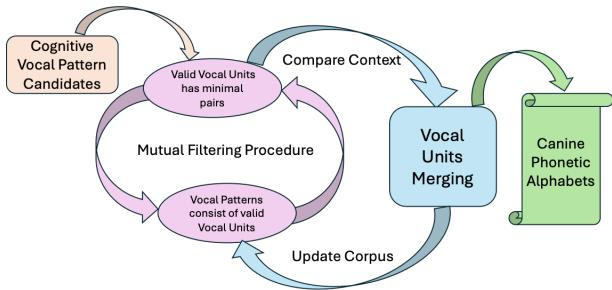
该算法的核心在于识别候选发声模式中的最小对立对。最小对立对定义为两个恰好相差一个认知发声单元且经验上可区分的发声模式。该过程生成发声单元和模式的初始候选集,然后识别有效的最小对立对。由于语义差异无法确定性地判定,作者引入了发声单元合并步骤。如果一对认知发声单元在相似发声环境中持续作为最小对立对中的对比单元出现,则被视为声学上和功能上等价,予以合并。算法仅保留在至少一个有效最小对立对中充当对比单元的发声单元,并过滤模式以仅包含由有效单元组成的模式。该迭代过程持续进行直至收敛。
为生成初始发声模式候选,作者使用Auditok库基于能量静音检测对连续犬类发声进行切分。
如下图所示:
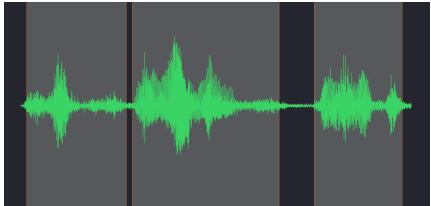
由此产生与高声学能量区域对应的候选模式。为应对不同片段之间的强度变化,采用动态阈值策略。切分阈值计算为可调系数ρ与完整音频片段均方根(RMS)能量的乘积。所得候选发声模式由该自适应阈值确定的低能量间隔分隔。
在最小对立对精化过程中,作者评估上下文相似性以应对潜在的过度切分或聚类伪影。他们基于前导和后随发声单元、共现模式以及局部N-gram结构提取上下文分布。对每对分布计算Jensen–Shannon(JS)散度。JS散度较低的对表明周围上下文高度相似,被假定为同一单元的过度聚类变体并予以合并。系统还丢弃在语料库中出现次数低于最小阈值K的罕见发声模式。这种迭代精化产生稳定的认知发声单元和发声模式集合,构成犬类语音字母表。
实验
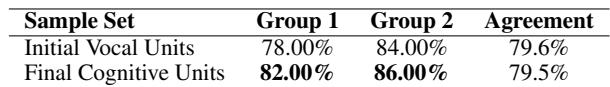
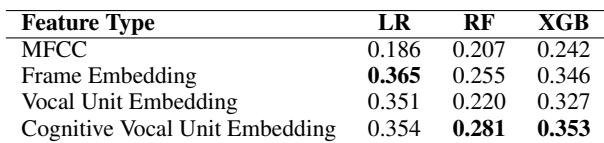
评估使用了6235小时的狗视频,产生了超过300000个发声片段,精化后得到105个认知发声单元和69个发声模式。声学测试(包括噪声去除检查和ABX听力测试)确认迭代精化消除了大部分噪声,并产生了声学上可区分且具有约80%标注者间一致性的单元。下游分类任务表明,认知发声单元嵌入在吠叫类型和上下文预测方面优于原始声学特征,表明其具有更强的语义基础。上下文分析显示,大多数高频发声模式与特定环境或活动强相关,支持其潜在指称性作用。
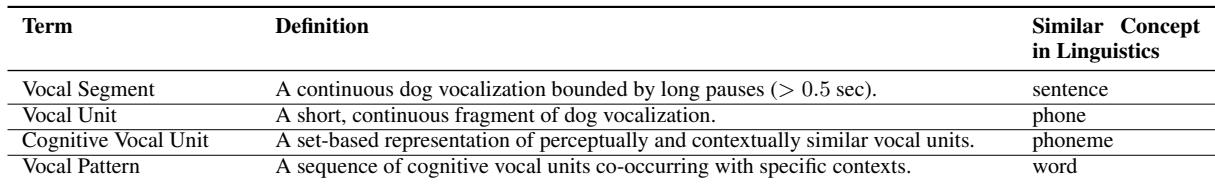
该表格定义了犬类发声分析框架中的关键术语,并与语言学概念进行对比:发声片段类似于句子,发声单元类似于音素,认知发声单元类似于音位,发声模式类似于词语。该方法采用数据驱动的预处理、转录和精化来识别这些单元,证据表明更抽象的特征能改善分类性能,且某些发声模式显示上下文关联性。发声片段是以超过0.5秒停顿为边界的连续狗发声,类似于人类句子。认知发声单元表示感知上和上下文上相似的发声单元,类似于音位。分类性能随特征从MFCC到认知发声单元变得越来越抽象而提升。69个高频发声模式中的大多数与一到两个语义类别呈强正相关或负相关。
数据集包含超过6000小时的狗视频,从中提取了约152小时的纯净发声片段。不同品种的视频时长和发声时长差异显著,其中柴犬贡献的视频量最大,但发声比例并非最高,而拉布拉多和哈士奇的发声占比相对较大。柴犬提供最大视频量,但其发声时长相对于视频长度较有限,表明发声密度较低。拉布拉多和哈士奇在视频时长之外均产生可观的发声时长,表明发声活动较高。总体而言,预处理流程将源视频压缩为小比例的纯净发声时间,支持了下游分析。
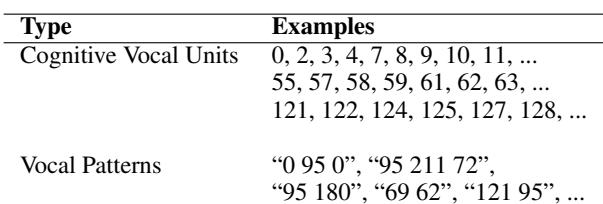
表格列出了从大规模狗发声数据集中提取的选定认知发声单元和发声模式。它支持以下发现:离散符号化发声表示可改善语义分类性能,且某些发声模式与特定环境或行为上下文表现出一致的相关性。该流程从超过300000个犬类发声片段中产生了105个认知发声单元和69个认知发声模式。分类性能随特征从MFCC变为认知发声单元而变得更加抽象和符号化,从而得到提升。69个高频发声模式中的大多数与一到两个语义类别呈强正相关或负相关,表明可能存在指称一致性。一个示例发声模式与室内和被动行为呈负相关,而与活跃的户外活动呈正相关。
两个独立的评估者组在最终认知发声单元上取得了比初始HuBERT派生单元更高的ABX准确率,同时保持约80%的组间一致性。这表明精化后的单元在声学上更可区分,并且被人类听者一致感知。两个评估者组在评估最终认知发声单元时,准确率均较初始集有所提高。两组在两组样本上的组间一致性均保持在80%左右,确认了测试的可靠性。最终认知单元的感知一致性更强,支持了精化算法的有效性。
表格比较了使用不同特征类型和分类器进行狗吠类型分类的Macro F1分数。随着特征变得更加抽象和符号化,性能总体提升,认知发声单元嵌入在大多数分类器上取得最高分数。这支持了离散发声表示为下游任务提供更强语义基础的观点。认知发声单元嵌入在所有分类器上均优于MFCC,在随机森林和XGBoost上提升最大。帧嵌入和发声单元嵌入表现出混合结果,但认知发声单元整体性能最佳。趋势表明,更抽象和符号化的特征带来更好的分类效果,强化了认知发声单元的语义价值。
实验验证了一种用于分析犬类发声的层次化框架,表明抽象和符号化特征(如认知发声单元)在语义分类上始终优于原始声学特征。人类感知测试确认精化后的单元在声学上更可区分且被可靠识别,而模式分析显示大多数高频发声模式与特定行为上下文强相关。总体而言,结果支持使用离散、数据驱动的发声表示来实现对狗发声的有意义的下游解读。