Command Palette
Search for a command to run...
Turning Trash into Treasure: Accelerating Inference of Large Language Models with Token Recycling
Turning Trash into Treasure: Accelerating Inference of Large Language Models with Token Recycling
Xianzhen Luo Yixuan Wang Qingfu Zhu Zhiming Zhang Xuanyu Zhang Qing Yang Dongliang Xu
摘要
Massive parameters of LLMs have made inference latency a fundamental bottleneck. Speculative decoding represents a lossless approach to accelerate inference through a guess-andverify paradigm. Some methods rely on additional architectures to guess draft tokens, which need extra training before use. Alternatively, retrieval-based training-free techniques build libraries from pre-existing corpora or by n-gram generation. However, they face challenges like large storage requirements, time-consuming retrieval, and limited adaptability. Observing that candidate tokens generated during the decoding process are likely to reoccur in future sequences, we propose Token Recycling. It stores candidate tokens in an adjacency matrix and employs a breadth-first-search (BFS)-like algorithm to construct a draft tree, which is then validated through tree attention. New candidate tokens from the decoding process are then used to update the matrix. Token Recycling requires <2MB of additional storage and achieves approximately 2x speedup across all sizes of LLMs. It significantly outperforms existing train-free methods by 30% and even a widely recognized training method by 25%.
一句话总结
哈尔滨工业大学与度小满科技有限公司提出 Token Recycling,这是一种免训练推测解码方法。它将 decoding 过程中生成的 candidate tokens 回收为邻接矩阵,并通过类广度优先搜索构造 draft tree,再借助 tree attention 进行验证。该方法在所有 LLM 规模下取得约 2× 的加速,额外存储低于 2 MB,相比现有免训练方法提升 30%。
核心贡献
-
Token Recycling 是一种免训练推测解码方法,它回收 LLM 推理过程中生成的 candidate tokens,以构建 draft token tree,且无需额外 draft model 或大型外部检索语料库。它可以集成到现有 LLM 中,无需针对模型进行训练。
-
candidate tokens 被存储在邻接矩阵中,并通过类似广度优先搜索的过程检索,以构造 draft tree,再通过 tree attention 验证,同时新的 decoding candidate 持续更新矩阵。这会形成一种自适应、低开销的检索结构,用于并行验证。
-
该方法所需的额外存储低于 2 MB,并在不同 LLM 规模下取得约 2 倍推理加速。相比以往免训练推测解码方法提升 30%,相比一种广泛使用的基于训练的方法提升 25%。
引言
LLM 驱动聊天机器人、代码助手和 agent,但逐 token 解码造成高延迟,因为每一步都必须把大量模型参数从内存搬运到加速器缓存。推测解码通过猜测 draft token 并并行验证它们来降低这种开销,并使用 tree attention 等技术一次检查多个延续。
以往工作通常依赖额外 draft model、从现有语料库检索,或简单复用此前文本。这些方法需要额外训练、大型静态库、慢速检索,或无法高效预测新 token。它们还会丢弃 decoding 过程中生成的有用 candidate tokens。
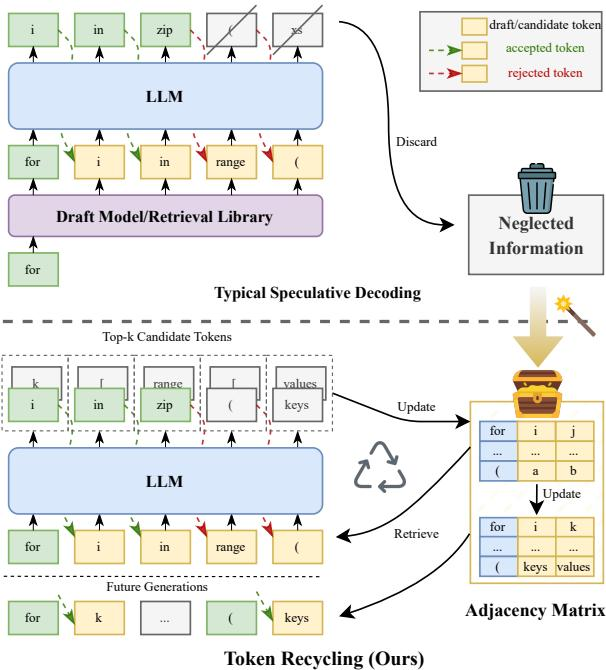
论文提出 Token Recycling,这是一种免训练推测解码方法,它复用这些 candidate tokens 作为 draft token。该方法将它们存储在一个小型邻接矩阵中,在每一步之前检索一棵 draft tree,通过 tree attention 验证,并用新 candidate 更新矩阵。由此得到约 2 倍加速,相比先前免训练方法提升超过 31%,并且需要低于 2 MB 的存储。
方法
论文将 Token Recycling 用作免训练且模型无关的推测解码框架。它复用 LLM 前向推理过程中已经产生的信息,把先前生成的 candidate token 转化为未来的 draft token。该流水线包含三个耦合模块:邻接矩阵初始化、draft tree 检索、以及验证和矩阵更新。参考框架图。
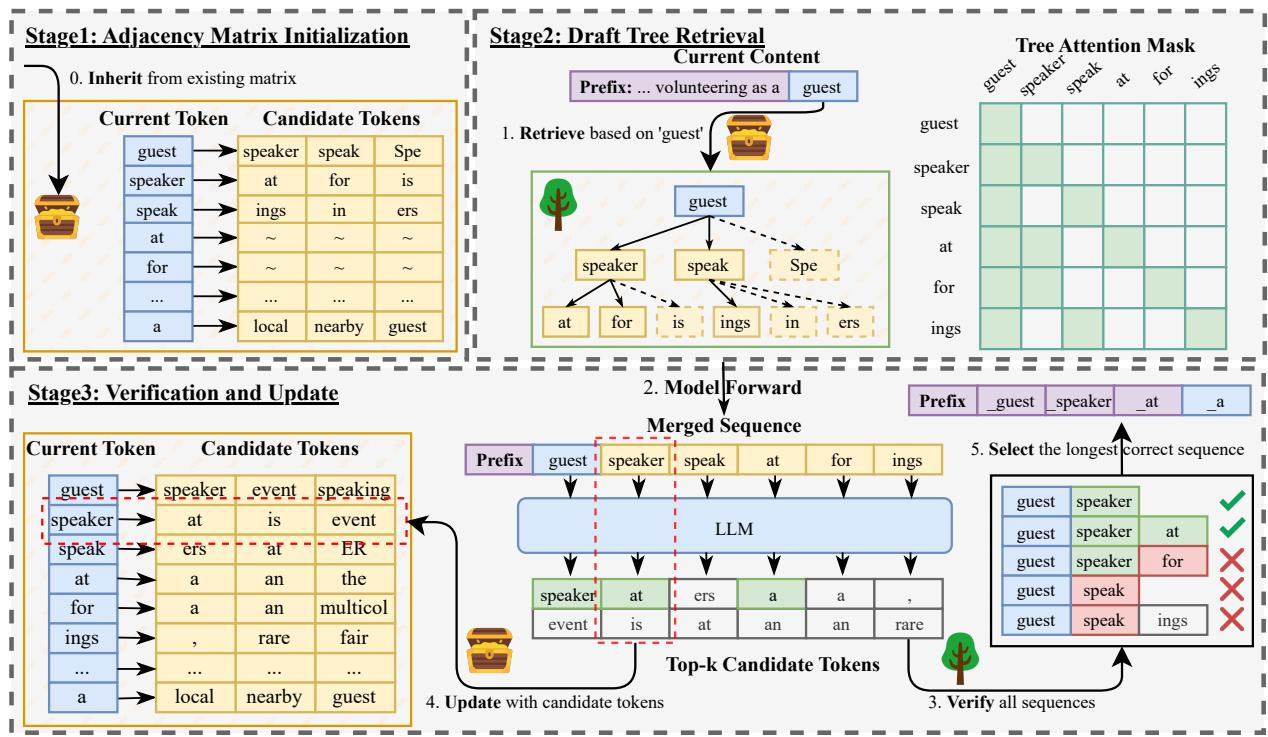
第一模块将 top k candidate token 存储在邻接矩阵中,记作 M∈V∣V∣×k,其中 V 是词表,k 是用户定义的超参数。每个元素 M[i,j] 表示 token VM[i,j] 是与 Vi 关联的第 j 个 candidate token。这种矩阵格式支持高效并行检索和并行更新,这对于相比基于 trie 的查找表等方案降低开销很重要。该模块并非从完全空矩阵开始,而是采用热启动策略,从先前推理中继承已有矩阵。这从最开始就保留常见表达和模式,为检索过程提供更广的初始搜索空间。
第二模块使用基于邻接矩阵的 BFS 风格遍历构造 draft tree。draft tree 的根是当前内容的最后一个 token。算法首先提取该 token 的 top k candidate,然后根据固定的树结构递归扩展每个 candidate。draft tree 是静态的,因为每个节点的子节点数量在所有 decoding step 中保持恒定,这允许预处理,并支持在 layer 遍历期间高效并行操作。draft tree 是不均衡的,因为概率较高、在每层中较早出现的节点会被分配更多子节点,并能向更深处延伸。该设计将计算资源导向最可能的延续,同时仍并行探索多个替代路径。
检索出 draft tree 后,其节点通过逐层遍历被排列成一个合并序列。合并序列会与现有 prefix 一起输入 LLM,并通过 tree attention 进行验证。tree attention 允许在单次前向推理中检查合并序列中的所有 candidate path,并选择最长的正确序列作为该 step 的输出。因为矩阵存储 top k candidate,验证阶段不需要只测试一条线性 draft continuation。相反,它可以评估多条并行 continuation,这些 continuation 通过扩展不同 candidate token 产生。
验证之后,论文使用模型产生的输出分布,在并行中更新邻接矩阵。对于已验证序列中的每个 draft token xi,矩阵条目根据最可能的下一个 token 更新:
M[x~i]=argtopk(p~i+1).这种更新会用新产生的 top k candidate token 覆盖当前 token 的先前 candidate。由于额外冲突解决逻辑可能降低总体性能,论文不为重复 token 添加额外冲突解决逻辑。因此,该更新过程使检索空间与当前内容保持一致,并允许矩阵持续适应局部上下文。这形成一种回收循环:candidate token 变成 draft token,而标准 LLM decoding 期间生成的输出分布会在后续 step 中刷新矩阵。
实验
实验在 SpecBench 和 MBPP 上评估一种免训练检索式推测解码方法,使用 Vicuna 和 Code Llama 的不同规模,并与 Lookahead、PLD、REST 和 Medusa 进行比较。主要结果显示,在通用、代码和上下文敏感任务上都取得稳定加速和较高 accepted token 比例,并在内存有限条件下保持高效。消融与分析证明,draft tree 的宽度与深度存在权衡,自适应更新和被拒绝 token 的反馈可提升 draft 接受率,初始化模式可以泛化,在采样条件下仍保持稳健,且附加开销很小。与 Eagle 的比较显示高效率,在极少内存占用下取得接近依赖训练方法的表现。
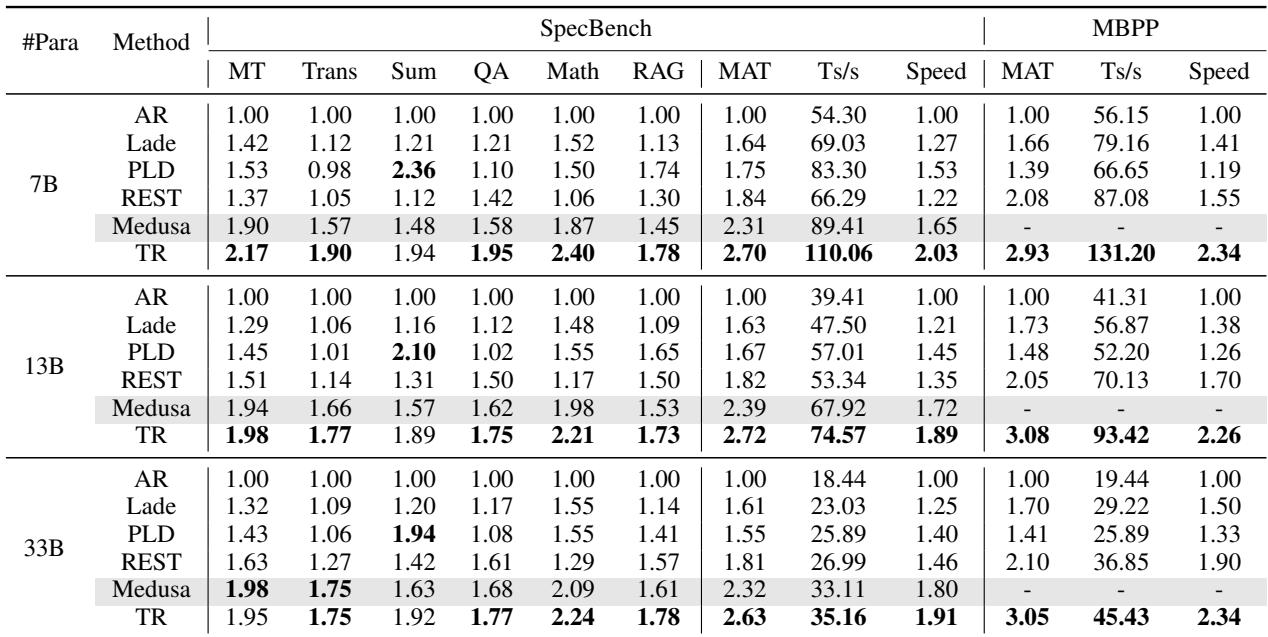
所比较的免训练方法在 SpecBench 和 MBPP 上均持续给出最强的总体加速,优于以往免训练方法,并在 SpecBench 上优于调优后的 Medusa baseline。其收益在任务类型和模型规模上大致一致,不过 PLD 在摘要任务上仍可能有竞争力,因为重复内容有利于基于先验的匹配。报告的 MAT 和吞吐量结果也表明额外解码开销较低。该方法在多数 SpecBench 任务和 MBPP 上取得最佳加速,而 MBPP 上没有 Medusa 结果。随着模型规模增大,其相对优势保持,且与 PLD 在 Sum 上的差距缩小。它在保持较强 token 吞吐量的同时记录最高 MAT,反映出高效的 self-drafting 和很短的检索开销。
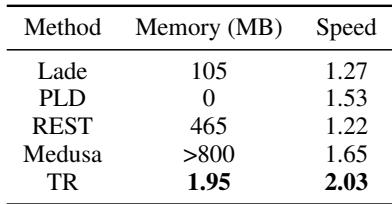
这一比较突出了不同推测解码方法在额外内存成本与加速之间的权衡。TR 以远低于 Medusa 的内存开销实现最高速度,而 PLD 不使用额外内存但在速度上落后于 TR。TR 仅增加少量内存开销便提供最佳速度。Medusa 比 TR 需要大得多的内存占用,速度仍落后。PLD 的额外内存成本为零,但加速效果不及 TR。
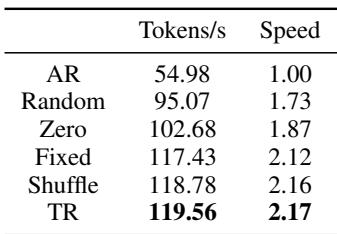
从先前邻接矩阵进行初始化,相比全零初始化可显著提升 decoding 速度。基于随机词表的初始化效果显著更差,说明无关 token 噪声会损害性能。固定、打乱和继承的矩阵设置取得相近增益,表明可复用的先前模式具有广泛泛化性。先前邻接矩阵能够捕获有助于后续查询的常见模式。随机初始化会引入有害噪声,降低吞吐量和加速比。固定、打乱和继承的初始化策略取得相近表现,表明存在与任务无关的有用模式。
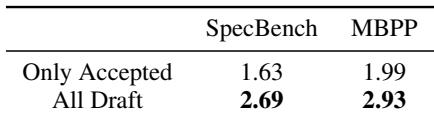
使用全部 draft token 更新 candidate token 会产生比仅使用被接受 draft token 更高的 mean accepted token。该趋势在两个基准上都出现,说明被拒绝的 draft token 仍为后续 decoding 提供有用信息。相比仅使用被接受 token 的更新,全部 draft token 可提升 mean accepted token。被拒绝的 token 对推测解码仍有用。
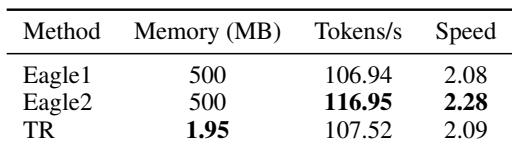
TR 是免训练且 self-drafting 的,却在吞吐量和加速比上略优于 Eagle1。与 Eagle2 相比,TR 依赖静态树,却仍保留大部分加速,并仅使用极少内存。TR 无需单独训练的 draft model 即可超越 Eagle1。TR 以更低的内存占用接近 Eagle2 的加速比。TR 即使使用静态树而非动态树构造仍然有效。
在 SpecBench 和 MBPP 上的实验通过端到端加速、内存成本、初始化选择、candidate token 更新以及与训练得到的 Eagle 方法的比较,来评估免训练推测解码。该方法仅以有限内存开销实现最强总体加速和高吞吐量,优于 Medusa 并接近训练得到的 baseline,同时在任务类型和模型规模上保持稳健。先前邻接矩阵初始化和使用全部 draft token 更新 candidate token 可进一步提升接受率,表明可复用的 token 模式以及被拒绝的 draft 都包含有用信息。