Command Palette
Search for a command to run...
通过推理时跨语言干预弥合大语言模型中的语言差距
通过推理时跨语言干预弥合大语言模型中的语言差距
Weixuan Wang Minghao Wu Barry Haddow Alexandra Birch
摘要
大语言模型(LLM)在自然语言处理任务中展现出卓越的能力,但在不同语言之间存在显著的性能差距。现有解决这些差距的方法大多依赖预训练或微调,资源消耗较大。为了在不产生显著成本的前提下克服这些局限,我们提出了推理时跨语言干预(INCLINE)框架,该框架在推理阶段通过将低性能(源)语言的内部表征与高性能(目标)语言的表征对齐来提升 LLM 在低资源语言上的表现。INCLINE 首先利用源语言和目标语言的平行句对,通过最小二乘优化学习对齐矩阵,然后在推理阶段应用这些矩阵将低性能语言的表征转换至高性能语言空间。在五个 LLM 上对九个基准数据集进行的大量实验表明,与近期强大的基线方法相比,INCLINE 在多种任务和语言上显著提升了性能。我们的分析表明,INCLINE 具有高度的成本效益,并适用于广泛的应用场景。此外,我们开源了代码以促进该方向的研究。
一句话总结
爱丁堡大学和莫纳什大学提出 INCLINE,一种推理时框架,它通过在平行句子上使用最小二乘优化学习对齐矩阵,将低性能语言表示映射到高性能语言表示空间,从而弥合 LLM 中的跨语言性能差距,并在九个基准和五个 LLM 上显著提升准确率,无需代价高昂的重训练。
核心贡献
- INCLINE 通过最小二乘优化从源语言和目标语言的平行句子中学习对齐矩阵,并在推理阶段应用这些矩阵,将低性能语言表示映射到高性能语言空间,无需对 LLM 进行微调。
- 在九个基准、五个 LLM、五个判别式任务、四个生成式任务和 21 种语言上的评估表明,INCLINE 显著提升下游性能,相比强基线平均准确率最高提升 +4.96。
- 分析表明,INCLINE 具有成本效益且适用性广泛,所需计算资源极少,同时在 LLM 主干模型、模型规模和上下文学习设置中保持稳健;发布的代码支持针对代表性不足的语言的进一步研究。
引言
LLM 在许多 NLP 任务上表现优异,但通常以英语为中心,并在不同语言之间表现出较大的性能差距,限制了低资源用户的访问能力。既有方法依赖昂贵的多语言训练数据、大规模微调,或可能不稳定且资源密集的提示策略。作者提出 INCLINE,一种推理时跨语言干预方法,它从平行句子中学习逐层对齐矩阵,并将低性能语言表示映射到高性能语言表示空间。这能在不重新训练或微调模型的情况下提升 LLM 在基准上的表现,为增强多语言能力提供低成本路径。
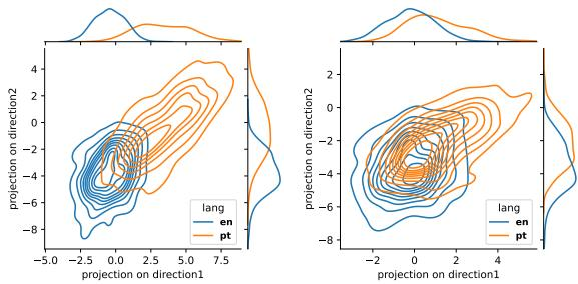
方法
作者将 INCLINE 设计为一种推理时跨语言干预框架,用于提升 LLM 在源语言任务上的表现。该方法不微调模型,而是冻结 LLM 参数,并引入轻量级对齐矩阵,将源语言隐藏状态投影到更强的目标语言表示空间。该流程包含两个核心阶段。如下方图示所示:
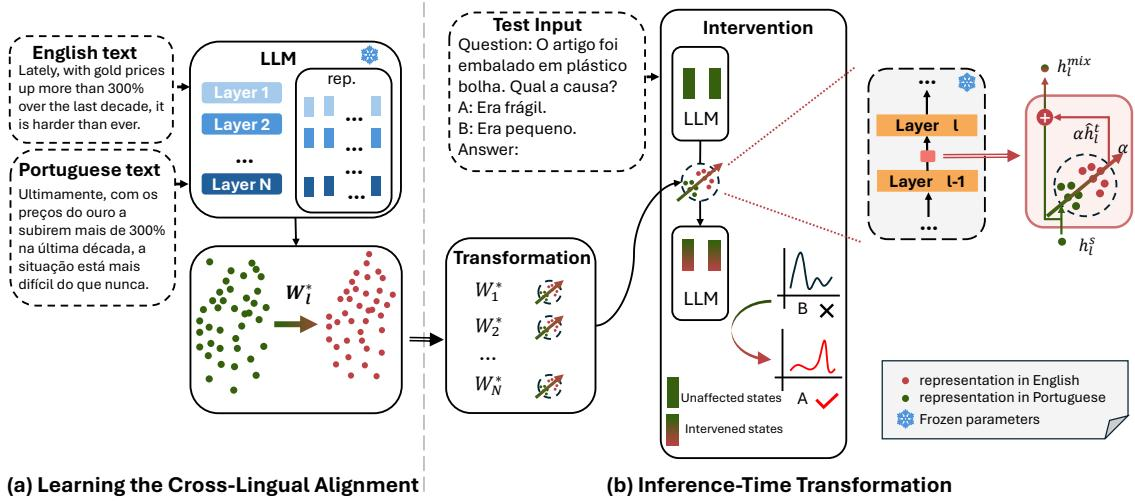
第一个阶段从平行语料中学习跨语言对齐。给定平行数据集 D={(xis,xit)}i=1N,其中 xis 是源语言句子,xit 是其目标语言译文,模型通过在每一层取最后一个 token 的表示来提取句子级隐藏状态。在第 l 层,这些表示分别记为源句子的 hi,ls∈Rd 和目标句子的 hi,lt∈Rd,其中 d 是隐藏状态维度。
对于每一层,该方法学习一个线性对齐矩阵 Wl,将源表示映射到目标表示。对齐目标被表述为一个最小二乘问题:
Wl∗=Wlargmini=1∑NWlhi,ls−hi,lt2该目标函数最小化投影后的源句子表示与对应目标句子表示之间的距离。由于该目标函数是线性最小二乘问题,最优对齐矩阵具有闭式解:
Wl∗=(i=1∑N(hi,ls)⊤hi,ls)−1(i=1∑N(hi,ls)⊤hi,lt)通过对每一层拟合一个这样的矩阵,该方法构造了一个从源语言表示到目标语言表示空间的逐层映射。这在不修改 LLM 权重的情况下缩小跨语言表示差距。
第二个阶段在推理阶段应用已学习的矩阵。对于源语言中的测试输入 qs,该方法取第 l 层最后一个 token 的隐藏状态,记作 hq,ls,并将其投影到目标语言空间:
h^q,lt=Wl∗hq,ls随后,通过残差相加将投影后的目标语言表示与原始源语言表示融合:
hq,lmix=hq,ls+αh^q,lt标量 α 控制干预强度,并平衡原始源语言表示和投影目标语言表示的影响。这种公式将源语言表示向目标语言空间移动,同时保留原始语言特征。修改后的隐藏状态 hq,lmix 随后用于继续前向传播并生成最终输出。
该干预作为在输入最后一个 token 位置上的最小修改执行。该方法不修改所有 token 位置,也不替换模型参数,而是将转换后的表示注入到选定的内部层。这种单 token 残差更新使 LLM 在推理阶段利用目标语言能力,同时减少对其余表示的扰动。
实验
该实验在九个判别式和生成式多语言任务上评估 INCLINE,覆盖 21 种语言,使用 BLOOMZ 和多个其他 LLM 主干模型,并与机器翻译、监督微调和激活干预方法等基线进行比较。结果表明,通过将非英语表示对齐到英语,INCLINE 在两类任务中均提供高效且有意义的性能提升,其中隐藏状态干预效果最强。进一步分析表明,该方法计算成本较低,提升跨语言预测一致性,跨模型泛化,随模型规模扩展,与上下文学习互补,受益于更高质量的平行数据,并且需要依赖于语言的干预强度。
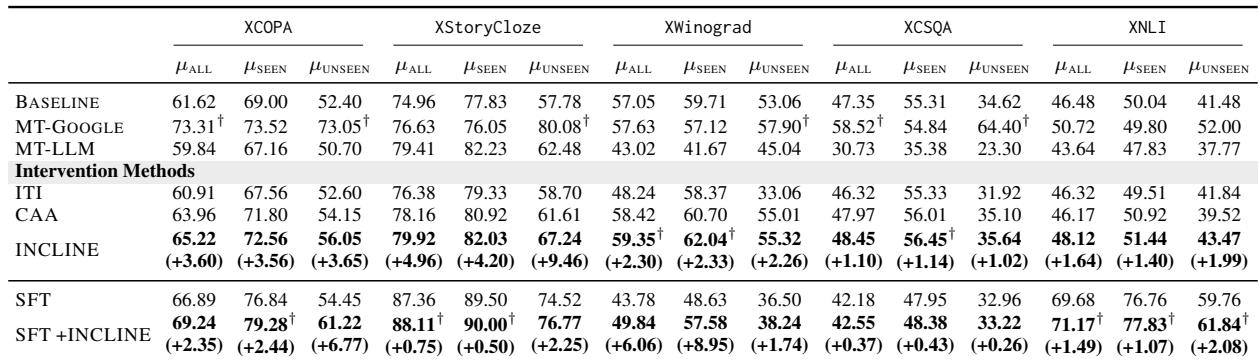
在以准确率评估的判别式任务中,INCLINE 显著优于基线和轻量级激活干预方法,同时避免昂贵的微调或第三方翻译依赖。较强的机器翻译基线在某些任务上表现良好,但论文将其相对于表示对齐方法描述为成本更高。报告的汇总结果还显示,已见语言的准确率比未见语言更高。INCLINE 相比更简单的干预方法产生更大的判别式增益,同时在推理时保持高效。MT-GOOGLE 在若干判别式平均指标上具有竞争力,但其优势伴随着外部机器翻译成本。在判别式任务中,已见语言通常比未见语言取得更高的宏平均准确率。
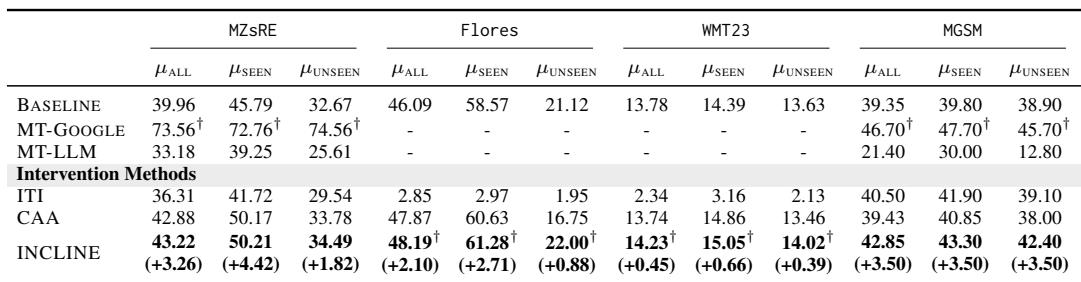
在生成式任务中,MT-GOOGLE 在关系抽取和数学上表现出最强的报告性能,尽管其翻译结果缺失。干预方法仅提供有限的整体增益,其中 ITI 在机器翻译上尤其弱,CAA 大多只相对于基线提供适度变化。报告的 INCLINE 比较显示,相比基线和干预方法,它有更广泛的生成式改进,并在数学准确率上有显著增益。MT-GOOGLE 在 MZsRE 和 MGSM 上具有最佳报告分数,但没有报告的 Flores 或 WMT23 分数。ITI 大幅降低机器翻译质量,仅略微提升数学准确率。CAA 相比基线改进关系抽取,但数学几乎不变,并给出混合的翻译性能。
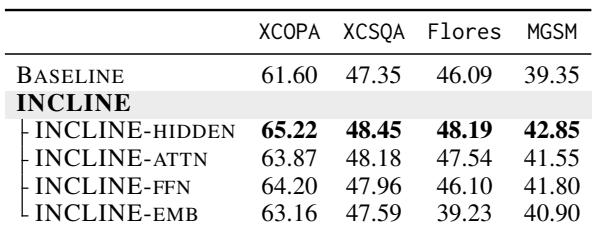
在多语言任务中,INCLINE 变体总体优于基线,其中隐藏状态干预产生最大的整体增益。对注意力输出、前馈模块和嵌入进行干预也可提升性能,但增益在任务间更具波动性。隐藏状态干预在测试的 INCLINE 变体中带来最稳定的提升。注意力和前馈干预仍具有竞争力,而嵌入干预更依赖任务。
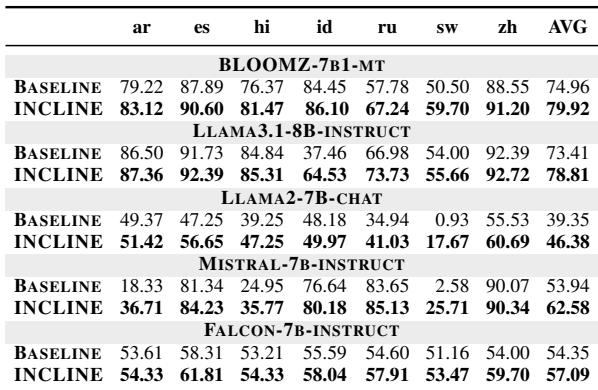
在五种 LLM 主干模型上的 XStoryCloze 中,相比相应基线模型,INCLINE 产生平均准确率提升。稳定的改进表明,INCLINE 在不同模型系列中普遍有效,而不受限于单一架构。相对于基线,INCLINE 提高了每个受评估主干模型的平均准确率。改进幅度因模型而异,其中一些指令模型和对话模型表现出尤其大的增益。语言级结果显示广泛改进,包括某些模型在基线得分较低语言中的显著提升。
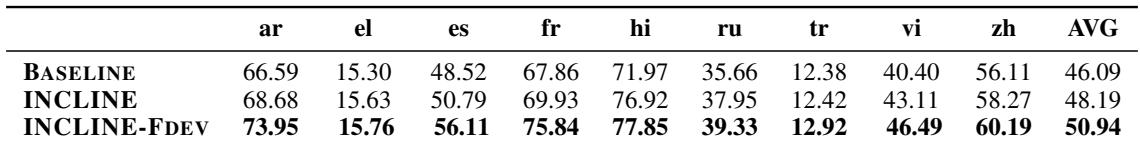
该表格比较了基线、INCLINE 和 INCLINE-FDEV 在九种语言上的 BLEU 分数。INCLINE 在报告语言和平均分数上均优于基线,而 INCLINE-FDEV 提供额外增益,表明使用更高质量的平行句子进行对齐训练是有益的。INCLINE 在报告语言上相对于基线一致提升 BLEU。INCLINE-FDEV 优于基线和标准 INCLINE,支持高质量平行训练数据的益处。平均 BLEU 从基线到 INCLINE 提升,并进一步提升到 INCLINE-FDEV。
这些实验在判别式、生成式、跨模型和翻译任务上将 INCLINE 与基线及轻量级激活干预方法进行比较。INCLINE 在不进行微调且不产生外部翻译成本的情况下产生一致的多语言增益,其中隐藏状态对齐最有效,已见语言和更高质量平行数据带来的收益更大。尽管机器翻译基线在某些生成式任务上可以表现出色,但它们成本更高且不均衡,而激活干预仅提供有限或依赖任务的改进。总体而言,INCLINE 在各任务和模型系列中表现稳健,相对于轻量级基线提升准确率和翻译质量。