Command Palette
Search for a command to run...
Mapping 1,000+ Language Models via the Log-Likelihood Vector
Mapping 1,000+ Language Models via the Log-Likelihood Vector
Momose Oyama Hiroaki Yamagiwa Yusuke Takase Hidetoshi Shimodaira
摘要
To compare autoregressive language models at scale, we propose using log-likelihood vectors computed on a predefined text set as model features. This approach has a solid theoretical basis: when treated as model coordinates, their squared Euclidean distance approximates the Kullback-Leibler divergence of text-generation probabilities. Our method is highly scalable, with computational cost growing linearly in both the number of models and text samples, and is easy to implement as the required features are derived from cross-entropy loss. Applying this method to over 1,000 language models, we constructed a "model map," providing a new perspective on large-scale model analysis.
一句话总结
来自京都大学和 RIKEN 的研究人员提出,将语言模型表示为在预定义文本集上计算的对数似然向量。在该表示中,平方欧氏距离可近似文本生成概率的 KL 散度,从而能够以线性计算成本扩展比较 1,000 多个模型。
核心贡献
- 论文提出一种针对自回归语言模型的可扩展比较方法。该方法基于在预定义文本集上计算的对数似然向量,其特征直接来自交叉熵损失,无需代价高昂的成对文本生成。
- 论文建立如下关系:这些对数似然向量可作为模型坐标,其平方欧氏距离近似文本生成概率分布之间的 KL 散度。
- 在 1,000 多个语言模型上的实验构建了模型地图,表明相邻模型具有相似的文本生成分布,并验证所得特征能够预测基准性能、检测数据泄漏,以及检验模型坐标与 KL 散度之间的关系。
引言
语言模型在 AI 系统中的核心地位日益提升,因此理解它们之间的关联、专长和差异,对选择、比较和管理模型十分重要。已有研究常使用输出、激活、排行榜,或不同提示之间的概率差异来比较模型,但这些方法可能需要昂贵的文本生成或成对评估,难以扩展到大型模型集合。
作者将语言模型视为概率模型,并把每个模型表示为在固定文本语料上的对数似然向量。这一表示构造出模型坐标,捕捉概率分布之间的几何关系,其中平方欧氏距离近似 KL 散度。主要贡献是一种高效、可扩展的方法,无需生成文本即可比较大量语言模型,并可用于模型地图、相似性分析、数据泄漏检测和基准性能预测。
数据集
-
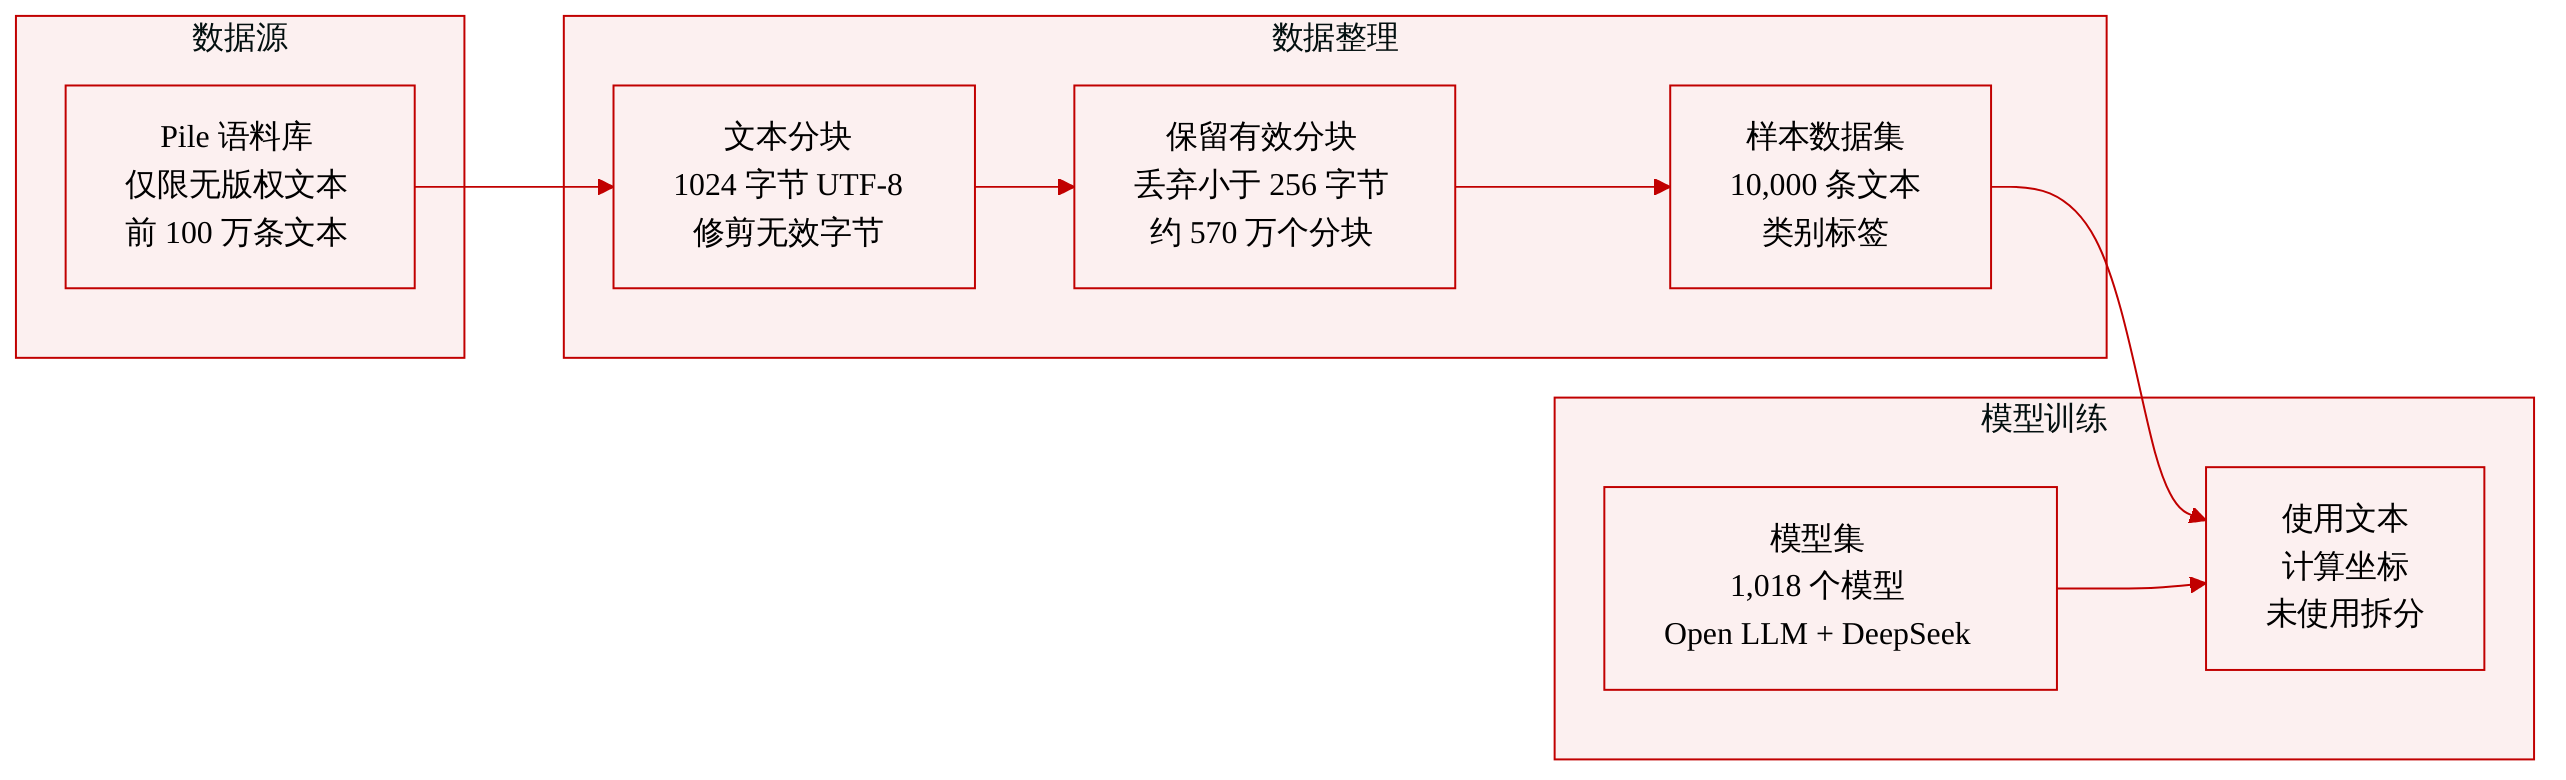
作者从 Pile Uncopyrighted 语料库构建文本数据集,先移除五类受版权保护的材料。
-
最终数据集包含 10,000 条文本,每条文本都带有来自 Pile 的类别标签。
-
为创建数据集,作者从 Pile Uncopyrighted 语料库的前 1,000,000 条文本开始,将它们拆分为采用 UTF-8 编码的 1024 字节片段。
-
当出现解码错误时,作者逐个移除字节,直到该片段可以成功解码。
-
小于 256 字节的片段会被丢弃,留下约 570 万个有效片段。
-
作者从有效片段中随机采样 10,000 个,形成最终文本数据集。
-
采样文本的平均长度为 972.3188 字节。
-
作者使用该文本数据集计算语言模型的模型坐标,而不是用于模型训练。
-
本研究共使用 1,018 个语言模型:从 Open LLM Leaderboard v1 的因果语言模型中选取 1,000 个模型,再加上 DeepSeek 语言模型系列中的 18 个模型。
-
文本数据未描述训练划分、验证划分或数据集混合比例;该数据作为坐标计算的采样输入语料。
方法
核心方法通过在固定文本集合上评估文本生成概率,将每个语言模型映射到有限维坐标系中。作者不直接比较模型参数,而是将语言模型视为文本概率分布的生成器,并根据其对共同探测语料分配似然的好坏来定义其位置。由此得到的几何结构使点之间的距离对应于相应语言模型之间 KL 散度的近似值。
流程从一个具有 token 词表 V 的自回归语言模型 pi 开始。一条文本 x 是 token 序列 x=(y1,…,yn),模型定义联合概率
pi(x)=t=1∏npi(yt∣y0,…,yt−1),其中 y0 是序列起始 token。给定语料 D=(x1,…,xN),模型通过其对数似然在每条文本上被评分
ℓi(x)=logpi(x)=t=1∑nlogpi(yt∣y0,…,yt−1).对于每个模型 pi,作者构造其对数似然向量
ℓi=(ℓi(x1),…,ℓi(xN))⊤∈RN,并将 K 个模型的向量堆叠为对数似然矩阵
L=(ℓ1,…,ℓK)⊤∈RK×N.该矩阵将每个模型转换为在同一组文本上的特征轮廓。
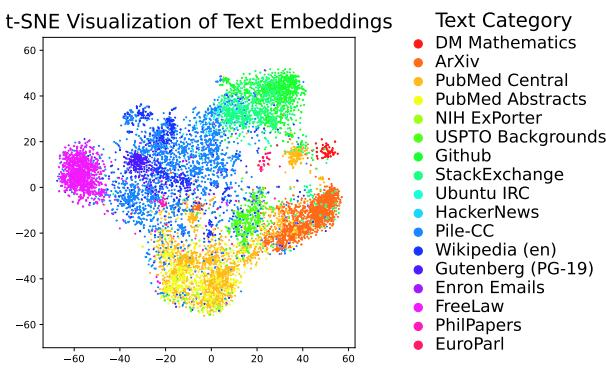
探测语料经过采样,以覆盖多个文本领域。文本从 Pile 的非版权部分抽取,转换为固定大小的字节片段,经过长度过滤,并随机采样形成用于坐标计算的最终数据集。每条采样文本保留类别标签,为评估语言模型提供多样化的提示集合。这种领域多样性有助于确保坐标差异反映不同文本类型上的行为,而不是过拟合某一种语料风格。如下所示:
得到 L 后,该方法应用双中心化以移除全局偏移。首先,对 L 的每一行进行中心化,即减去对应模型的平均对数似然:
ℓˉi=N1s=1∑Nℓi(xs), ξis=ℓi(xs)−ℓˉi.由此得到中心化对数似然向量 ξi。其次,对中心化向量矩阵按列中心化,即减去所有模型的平均中心化向量:
ξˉ=K1i=1∑Kξi, qi=ξi−ξˉ.向量 qi 是主要模型坐标。它同时去除模型特定的平均对数似然和跨模型的文本特定平均值,从而分离模型在语料上分配概率时相对模式差异。
作者证明该坐标系具有有意义的概率解释。两个语言模型之间的 KL 散度为
KL(pi,pj)=Ex∼pi[ℓi(x)−ℓj(x)].在假设文本来自底层分布 p0,且 pi 和 pj 是 p0 的合理近似时,该散度可用对数似然差的方差近似:
2KL(pi,pj)≈Varx∼p0(ℓi(x)−ℓj(x)).利用数据集和双中心化坐标,该近似变为
2KL(pi,pj)≈N∥qi−qj∥2.因此,如果坐标按 qi/N 缩放,则两点之间的平方欧氏距离近似相应模型之间 KL 散度的两倍。
原始对数似然向量也可几何解释。由于 ℓi 与 qi 相差中心化项,原始对数似然空间中的平方距离可分解为
∥ℓi−ℓj∥2=∥qi−qj∥2+N(ℓˉi−ℓˉj)2.第一项捕捉模型之间中心化后的分布差异,第二项捕捉其总体平均对数似然的差异。在这一视角下,qi 表示与分布定位相关的水平轴,而 ℓˉi 可视为可视化中的全局尺度或高度维度。
实验
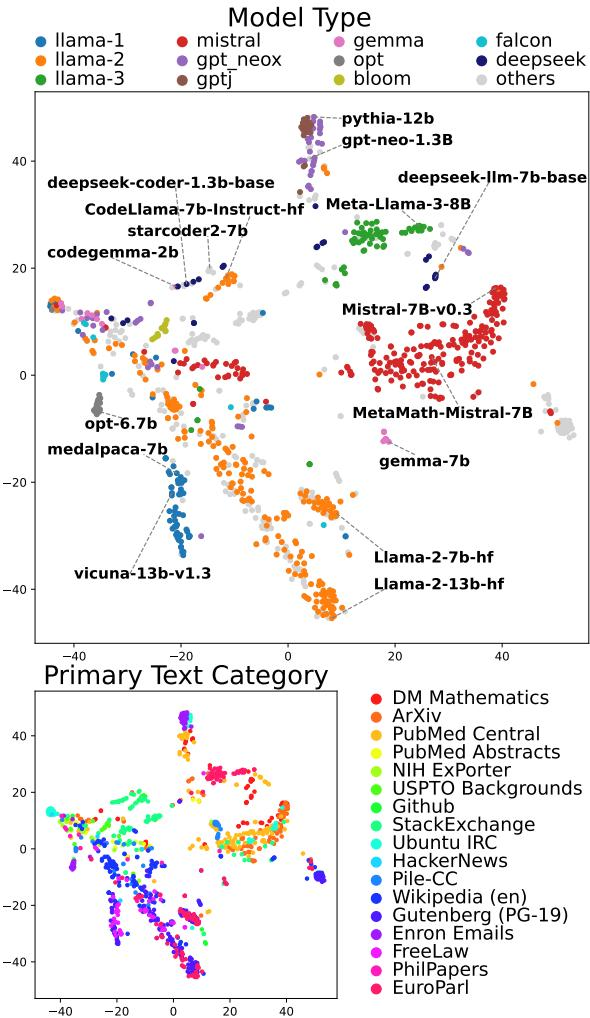
实验利用数千条文本和 1,000 多个语言模型,构建基于对数似然的模型坐标地图,并用它可视化模型家族、专业方向、文本偏好、基准性能、模型规模和创建日期之间的关系。回归分析表明,这些坐标能够强烈预测排行榜分数和平均对数似然,说明模型位置编码了超越简单困惑度的任务相关能力结构。额外验证确认,对数似然空间中的距离近似 KL 散度,且线性权重插值在坐标空间中保留有意义结构,支持将该方法用于探索模型行为。
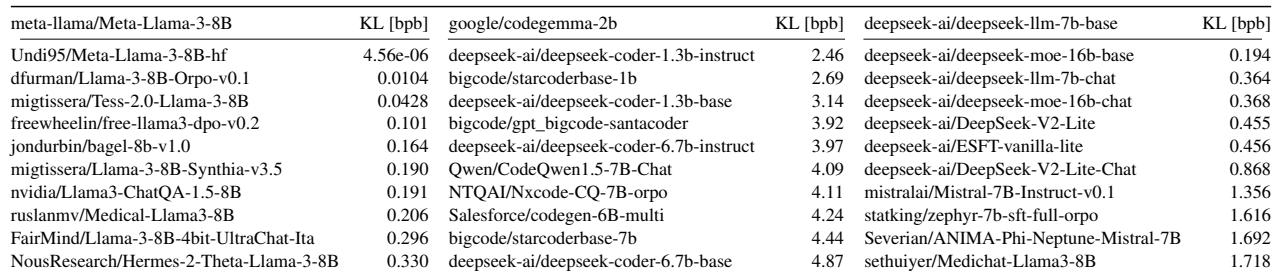
在最近邻比较中,共享基础谱系或微调历史的模型在以每字节比特衡量的 KL 散度下距离最近。代码模型的最近邻主要是其他面向代码或代码系列模型,而更大基础模型的最近邻主要是同一系列中的变体。这些模式支持使用对数似然坐标揭示大量语言模型之间的语义和架构关系。名称相关的模型往往具有较小的 KL 散度距离;面向代码的模型聚集在其他代码生成模型附近;家族变体比跨家族模型更近。
使用模型坐标的岭回归可在各个单独任务上以持续较高的线性相关和秩相关预测基准分数。最强预测出现在平均对数似然上,而六项任务平均值的预测相关性也保持很高。这些结果表明,即使平均值经过双中心化,坐标表示仍保留了足够的性能相关结构。所有评估的基准都显示模型坐标与分数之间具有较强一致性。平均对数似然比单个基准分数更容易被准确预测。六项任务平均值也具有高度 Pearson 相关和 Spearman 相关。GSM8K 在所有单个任务中相关性最低。

平均对数似然与困惑度密切相关,但在所评估任务中与基准分数只呈中等相关。这些相关弱于模型坐标所呈现的强预测能力。关系强度因基准而异,某些任务的一致性明显低于其他任务。平均对数似然与基准分数整体呈中等相关,而不是近乎完美的一致性。TruthfulQA 和 GSM8K 与平均对数似然的关联尤其弱。HellaSwag 和 Winogrande 与平均对数似然的相关性相对更强。
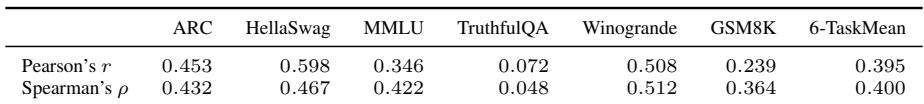
最近邻分析使用以每字节比特计的 KL 散度,结果显示具有共享谱系、代码角色或名称相似性的模型距离最近,表明对数似然坐标捕捉了架构和语义关系。对这些坐标进行岭回归可较强地预测基准分数,其中平均对数似然和六项任务平均值最容易被可靠预测,不过 GSM8K 相对更难预测。相比之下,仅使用平均对数似然时,它与基准分数只呈中等相关,TruthfulQA 和 GSM8K 的一致性较弱,HellaSwag 和 Winogrande 的一致性较强。