Command Palette
Search for a command to run...
从指令遵循能力视角重新审视大语言模型的组合泛化能力
从指令遵循能力视角重新审视大语言模型的组合泛化能力
Yusuke Sakai Hidetaka Kamigaito Taro Watanabe
摘要
在 CommonGen 等生成式常识推理任务中,生成式大语言模型(LLM)需要构造包含所有给定概念的句子。然而,从指令遵循能力的角度来看,若提示中指定了概念的排列顺序,LLM 必须生成符合该顺序的句子。为此,我们提出了 Ordered CommonGen,一个旨在评估 LLM 组合泛化与指令遵循能力的基准。该基准通过有序覆盖率来衡量概念是否按照指定顺序生成,从而能够同时评估这两种能力。我们对 36 个 LLM 进行了全面分析,发现尽管 LLM 通常能够理解指令的意图,但对特定概念排列模式的偏好往往导致输出多样性不足,甚至改变概念顺序时仍产生相同结果。此外,即使是指令遵循能力最强的 LLM,其有序覆盖率也仅约为 75%,这凸显了在指令遵循和组合泛化两方面进行改进的必要性。
一句话总结
奈良先端科学技术大学院大学的研究人员提出 Ordered CommonGen 基准测试,该基准利用有序覆盖率同时评估 LLM 的组合泛化能力和指令遵循能力;对 36 个模型的分析表明,概念顺序偏差会导致输出多样性较低,即使最好的模型也只能达到 ∼75% 的有序覆盖率。
核心贡献
- Ordered CommonGen 扩展了 CommonGen,要求生成的句子以指定顺序包含一个四概念集合,并使用有序覆盖率同时评估组合泛化和指令遵循。
- 该基准对唯一的四概念集合生成排列,并在指令模板中附加短语 “in the specified order”,从而能够系统评估 LLM 是否遵循任意概念顺序,而不只是无序包含概念。
- 对 36 个 LLM 的实验表明,模型能够理解指令意图,但会偏向频繁出现的概念顺序模式,导致输出多样性较低甚至完全相同;即使遵循指令最强的模型也仅达到约 75% 的有序覆盖率。
引言
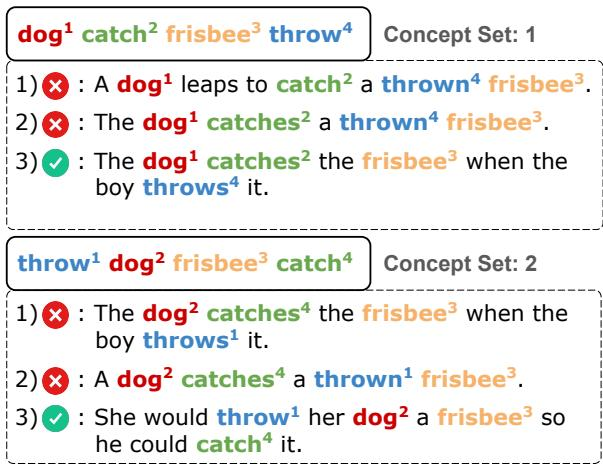
指令遵循 LLM 对创造性生成非常重要,因为在时间线、规划、歌词、广告等任务中,措辞或顺序的变化都可能改变含义。以往的生成式常识推理基准大多只测量覆盖率,这意味着模型只要按任意顺序包含所有概念就可以满足提示,从而掩盖了其遵循特定概念序列的能力。作者基于 CommonGen 提出 Ordered CommonGen,对概念集合进行排列,并添加遵循指定顺序的指令。该设置同时测试组合泛化和指令遵循;对 36 个 LLM 的基准评估显示,顺序控制能力有限,最佳模型的遵循率约为 75%,并表现出对熟悉模式的偏向。
数据集
-
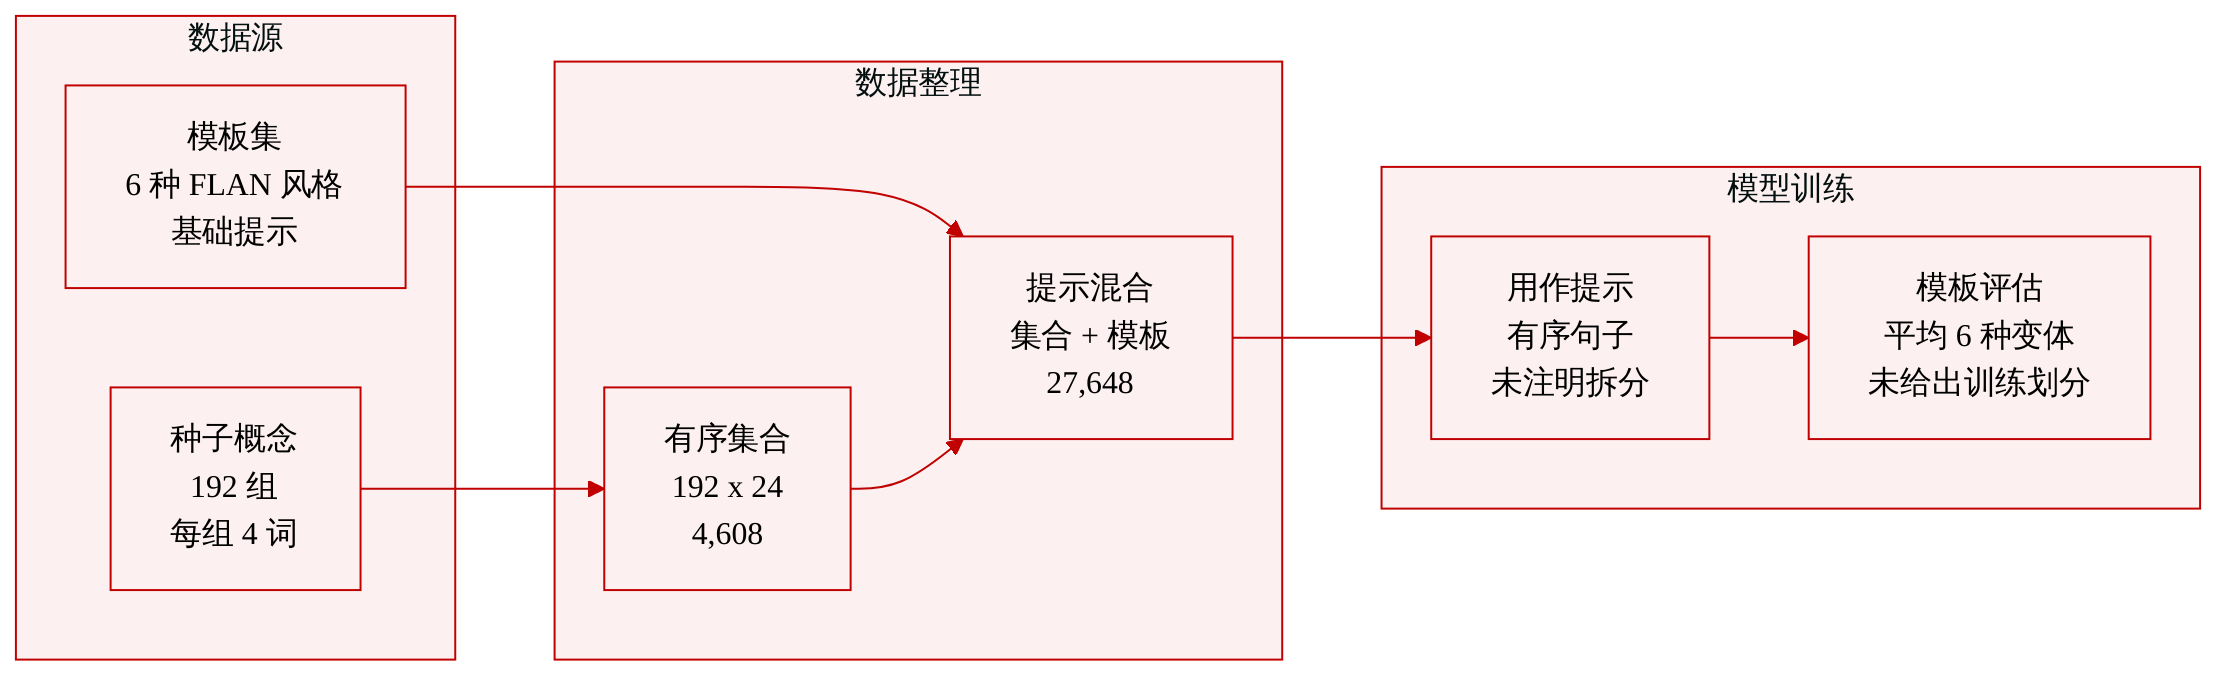
作者从两个部分构建 Ordered CommonGen 数据集:作为句子生成种子的概念集合,以及将这些种子格式化为 LLM 提示的指令模板。
-
种子概念来自 CommonGen-lite,即 CommonGen 测试数据的一个子集。作者提取了全部 192 个种子概念集合,每个集合包含四个概念。
-
作者将每个四概念集合展开为所有可能排列,即每个种子集合有 4! = 24 种排列。最终生成 192 × 4! = 4,608 个有序概念集合。
-
指令模板选自 FLAN,特别是与 CommonGen 相关的六个手工创建 FLAN 模板。
-
作者在基础模板后附加短语 “in the specified order”,使 LLM 按给定顺序使用概念生成句子。
-
将六个修改后的指令模板与 4,608 个有序概念集合组合,得到 6 × 4,608 = 27,648 个实例。
-
生成的数据集用作 LLM 输入提示。六个模板变体还允许通过对各模板得分取平均,来考虑模板性能差异。
-
提供的文本未指定训练/验证/测试划分、混合比例,也未说明除固定种子集合、排列和模板构建之外的额外过滤。
实验
在 36 个指令微调 LLM 上,Ordered CommonGen 评估明确指定概念顺序是否能提升顺序敏感生成,并在排列模板上测量概念覆盖、顺序遵循、自然度和多样性。结果表明,明确的顺序指令通常会提升概念顺序合规性和句法多样性,同时仅轻微降低自然度,但许多模型仍会遗漏概念或产生不合规输出。进一步分析表明,动词密集型概念集合、提示措辞和 one-shot 示例提示对模型行为影响显著,学习到的自然词序模式经常覆盖指定顺序,不过最强模型可以在一定程度上根据指令调整生成。
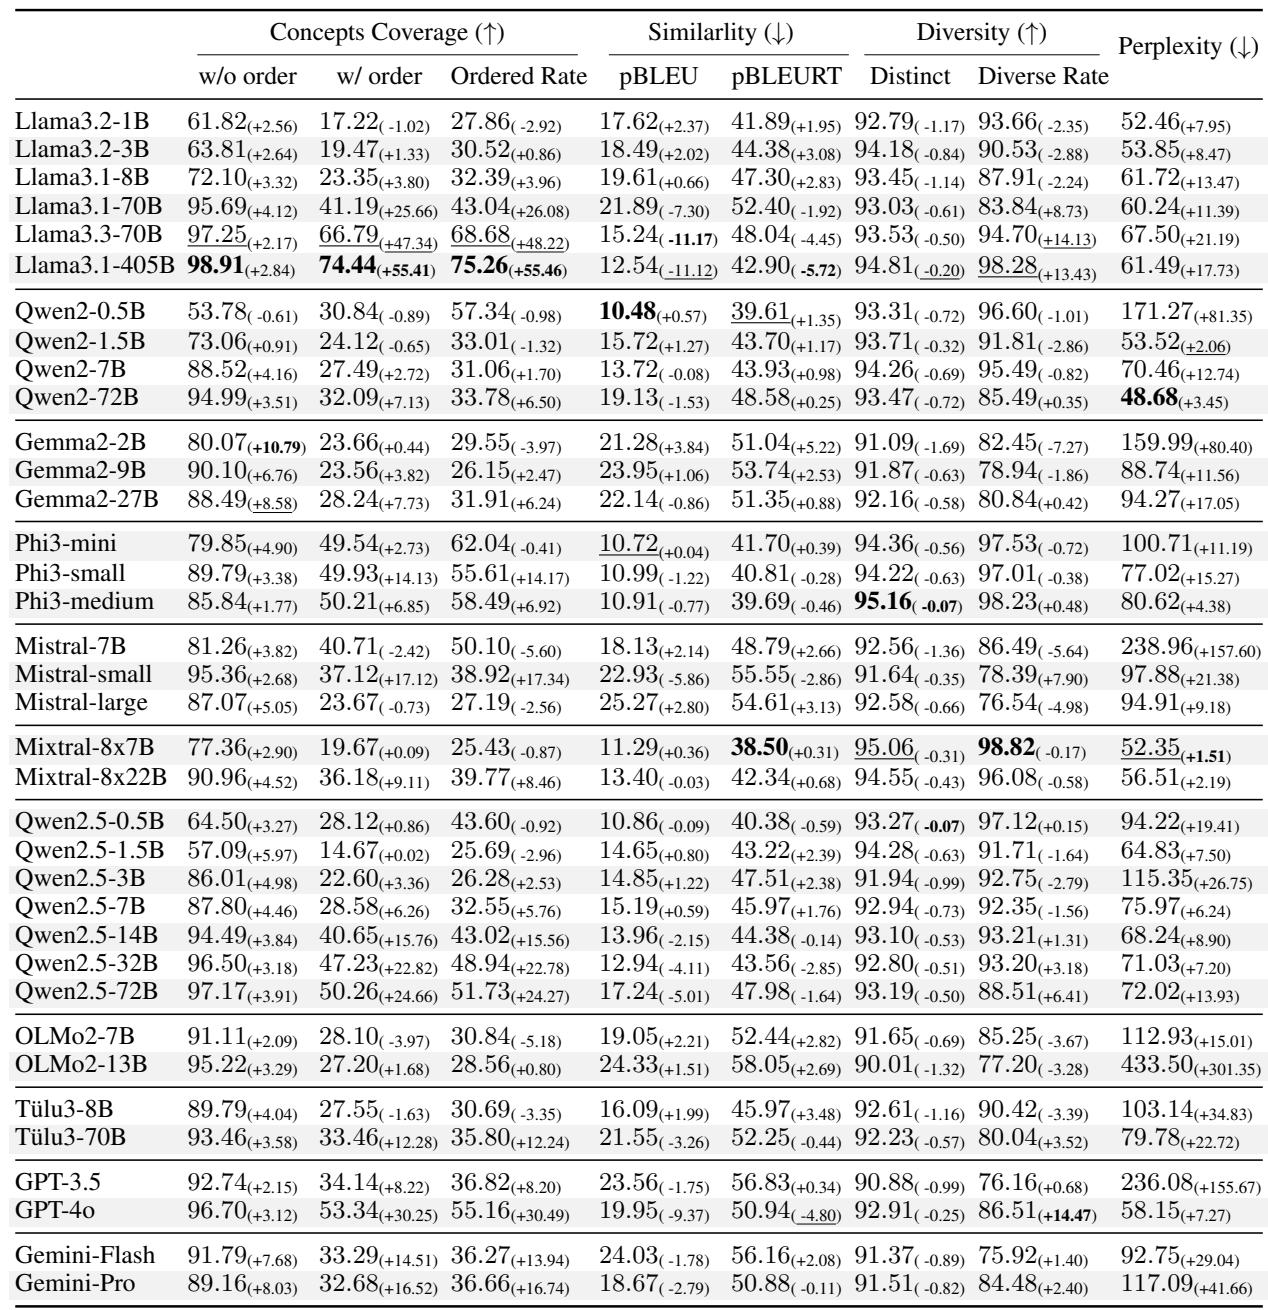
明确指定概念顺序通常会提高所评估 Llama 模型的概念覆盖率和有序合规性,最大规模变体的收益最明显。较小规模 Llama 变体对请求顺序的遵循较不可靠,排序还会对相关生成质量或多样性指标带来轻微变化。总体主要趋势是,在提示中加入明确顺序信息后指令遵循更强。指定概念顺序时,更大规模的 Llama 模型在有序概念覆盖方面显著更强。较小规模 Llama 模型从排序指令中获益较少,且有序率得分可能下降。
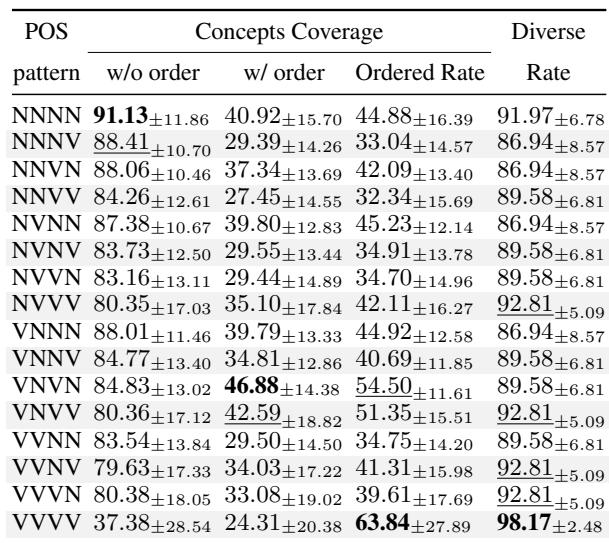
在仅名词的 POS 模式中,LLM 达到最高概念覆盖率,表明更常见对象更容易被纳入。在仅动词模式中,覆盖率明显下降,波动性上升,而有序率和多样率最高,揭示覆盖可靠性与受控多样性之间的权衡。仅名词概念集合在各模型中产生最高概念覆盖率。仅动词概念集合尽管达到最高有序率和多样率,却显示最低概念覆盖率和最大波动性。
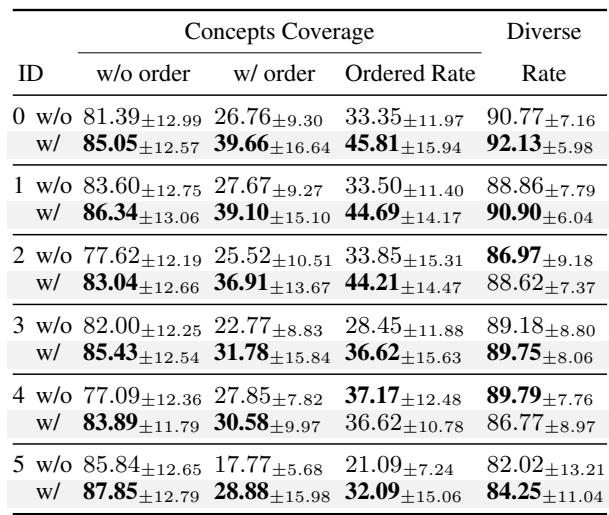
提示措辞会影响多个大语言模型的指令遵循。添加指定所需顺序的短语通常会提高概念覆盖率、多样率和有序率的平均表现,但收益随提示模板不同,且并非对每个模型都一致。较大的得分范围表明没有单个提示能始终产生最佳结果。在提示中指定顺序通常比省略它带来更高平均概念覆盖率。顺序指定也往往提高所测提示的多样率。大多数情况下,有序率会因顺序短语而改善,但效果并非始终一致。各提示模板之间仍存在表现差异,难以确定普遍最佳提示。
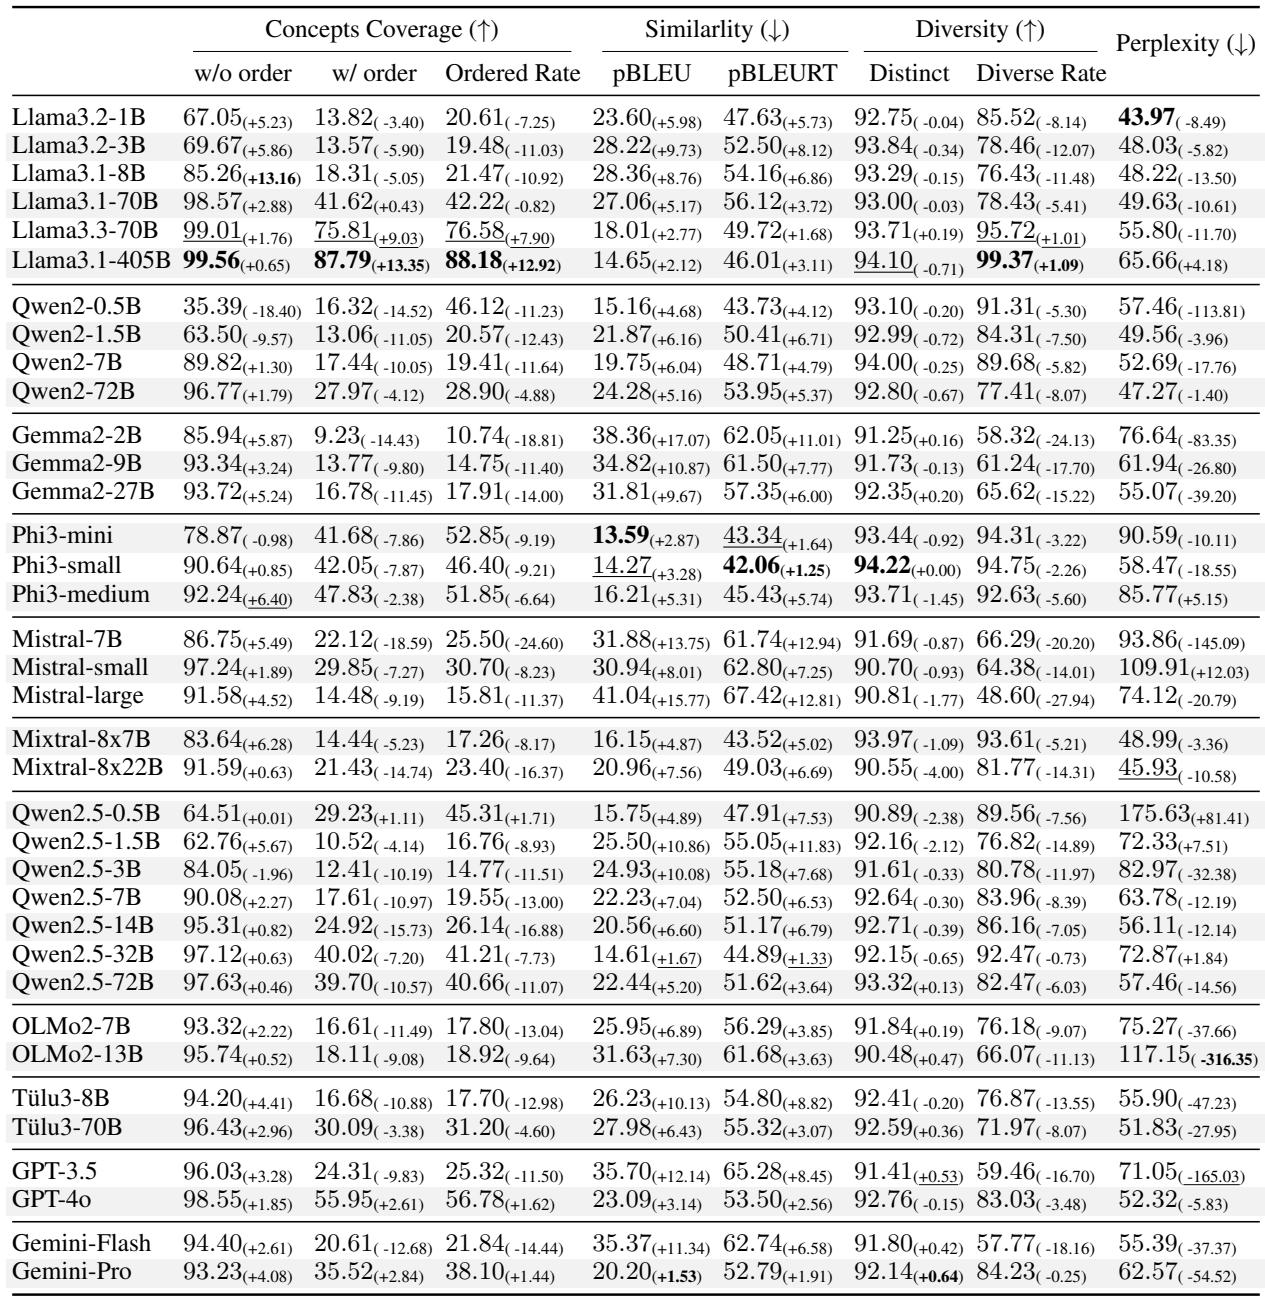
在理想的 one-shot 示例提示评估中,对于规模较大且指令能力较强的 Llama 模型,有序概念覆盖率提升最明显,而多个较小模型的有序准确率下降。多数模型在不要求概念顺序时表现改善,但多样性下降且相似度上升,表明示例使输出更公式化。结果表明,one-shot 模式可以引导指令遵循,但常常抑制多样化的句子生成。Llama3.3-70B 和 Llama3.1-405B 的有序概念覆盖率上升,但多个其他模型下降。无序概念覆盖率在多数模型中提高,而多样性和相似度趋势显示输出更单调。
实验评估了显式概念顺序指令、概念集合词性模式、提示措辞和 one-shot 示例提示对 Llama 模型指令遵循的影响。添加顺序信息通常会提升概念覆盖率和有序合规性,对较大模型尤其明显,而较小模型响应较不稳定,并可能在多样性或质量上出现权衡。概念组成也很重要:基于名词的集合更容易覆盖,基于动词的集合可靠性较低,但可能产生更有序且更多样的输出。总体而言,显式结构和示例提示可以增强有序控制,但收益依赖模型,且常常伴随多样性降低或生成质量一致性下降。