Command Palette
Search for a command to run...
大语言模型中的响应采样理论:兼具描述性与规范性
大语言模型中的响应采样理论:兼具描述性与规范性
Sarath Sivaprasad Pramod Kaushik Sahar Abdelnabi Mario Fritz
摘要
大语言模型(LLM)正被越来越多地应用于自主决策场景,在这些场景中,它们需要从庞大的动作空间中采样选项。然而,引导这一采样过程的启发式机制尚未得到充分探索。我们研究了这种采样行为,并证明其潜在的启发式机制与人类决策相似:包含描述性成分(反映统计规范)和规范性成分(编码于 LLM 中的隐含理想)。我们表明,样本从统计规范向规范性成分的偏移,在公共卫生、经济趋势等众多真实世界领域的概念中一致出现。为进一步阐释该理论,我们证明了 LLM 中的概念原型受到规范性规范的影响,类似于人类的正常性概念。通过案例研究及与人类研究的对比,我们展示了在真实世界应用中,LLM 输出中样本向理想值的偏移可能导致严重有偏的决策,从而引发伦理关切。
一句话总结
来自 CISPA Helmholtz Center、TCS Research 和 Microsoft 的研究者证明,LLM 响应采样通过一种双重启发式反映了人类决策,该双重启发式结合了反映统计规范的描述性成分,以及编码隐含理想的规范性成分,并揭示了输出中向规范性方向的这种转变可能引发公共卫生和经济等领域中的显著有偏决策。
核心贡献
-
该研究提出了一个用于 LLM 在自主决策中采样的认知科学框架,认为采样输出结合了描述性统计成分和规范性理想成分,并通过受控实验、稳健性检查以及与人类研究的比较验证了该框架。
-
使用来自 10 个领域中 500 个概念、覆盖 15 个语言模型的样本进行评估,研究发现存在从统计规范向规范性规范的显著统计偏移;受现实世界启发的案例研究还表明,这种偏移可能产生有偏决策并引发伦理问题。
-
该研究还证明,LLM 对概念的原型表征系统性地包含规范性成分,表明它们对“典型”示例的判断会以类似于人类对正常性和典型性的方式偏向理想化版本。
引言
LLM agent 通常需要从许多可能输出中选择一个动作,而穷尽式审议通常不可行。在这种设置下,作者研究响应采样,即 LLM 在候选输出之间进行选择的机制,因为该机制会影响真实应用中的下游决策、偏差和可靠性。已有研究表明,LLM 能够形成结构化内部表征,并表现得像快速、启发式驱动的 agent,但较少关注在多个选项之间概率化选择背后的依据,尤其是当采样输出与真实统计不一致时。作者借鉴认知科学中关于人类典型性的发现,提出 LLM 采样结合了一个描述性成分,即统计上的常见性,以及一个规范性成分,即对概念应当如何的理想化理解。这一观点得到了受控实验的支持,评估覆盖 10 个领域中 500 个概念和 15 个模型,并且一个医学案例研究还表明,这种理想化采样可能导致非期望结果。
方法
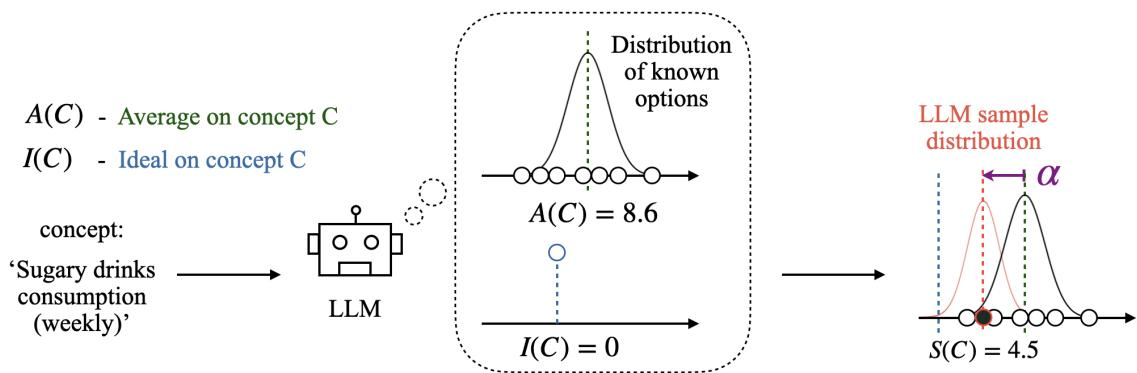
作者利用受人类决策启发的认知理论来解释 LLM 采样。该框架将包括思维链在内的显式推理过程和其他审议式模型变体视为 System 2 风格的过程,而默认 token 生成则起到 System 1 风格启发式采样的作用。在该框架内,采样被描述为模型从潜在响应分布中概率化选择输出的过程。所提出的理论认为,LLM 采样受到两个潜在成分的影响:一个描述性成分,对应于概念的统计规范;一个规范性成分,对应该概念的理想或偏好观念。因此,该方法考察模型输出是否沿着与内部表征理想一致的方向偏离纯统计规律。
实验流程首先使用一个新颖概念 C 构造受控设置,以避免模型中已有概念带来的混淆效应。C 的描述性规范用从均值为 Cμ 且方差已知的正态分布中抽取的数值来实例化。向 LLM 提供来自该分布的 N 个样本,且 N 选得足够大,使经验均值非常接近 Cμ。为了引入规范性规范 Cv,在不同实验条件下,每个选项都被关联一个分级数值:一个条件将较高值视为理想,一个条件将较低值视为理想,还有一个没有显式理想方向的控制条件。随后提示模型为概念 C 生成一个样本,记为 S(C)。
为了评估样本分布是仅由描述性规范驱动,还是也由规范性规范驱动,该过程重复 M 次,其中 M 保持等于 N。这会在每组 Cμ 和 Cv 配置下得到 S(C) 的输出分布。如果采样仅依赖统计规范,则 S(C) 的分布应类似输入分布。为了将真正的规范性偏离与估计输入统计量失败区分开,模型还被要求报告输入分布的平均值,记为 A(C)。当 A(C) 与 Cμ 接近时,作者将该模型解释为成功近似了描述性规范。随后使用 Mann-Whitney U 检验检验 S(C) 相对 A(C) 的偏离,并将 p<0.05 视为统计显著偏移的证据。
对于现有概念,该方法被扩展到 Cμ 和 Cv 不外部已知的设置。该流程改为获取自报告平均值 A(C)、自报告理想值 I(C) 以及采样值 S(C)。由于理想值可能位于平均值之上或之下,作者定义了方向性偏离度量 α。对于概念 C 的样本 S(C),该度量计算为
α=(A(C)−S(C))×sign(A(C)−I(C)).α 为正值表示模型的样本从平均值朝理想值移动。由于原始 α 取决于概念的数值尺度,该方法还计算归一化形式,
α^=∣A(C)−I(C)∣α.该归一化将 A(C) 置于原点,并将 I(C) 置于单位距离处,使不同数值范围的概念之间的偏离具有可比性。排除 A(C)=I(C) 的退化情形,因为无法定义朝向理想值的有意义方向。
如下图所示:
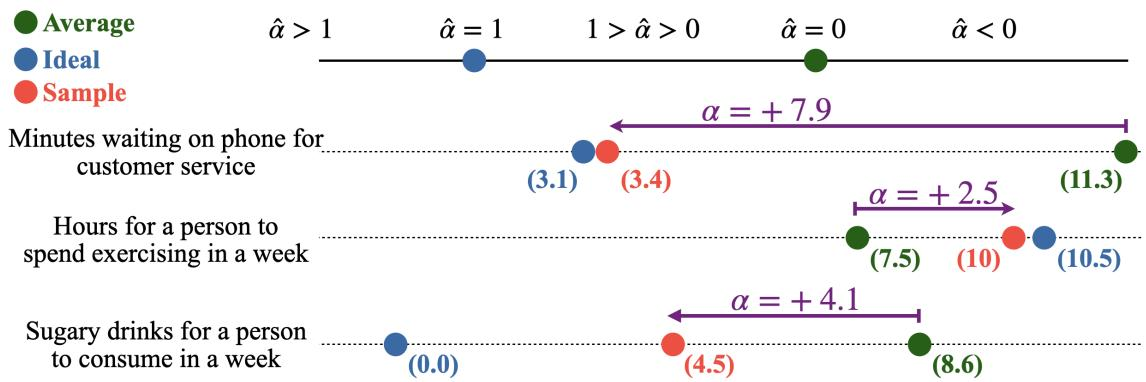
该可视化说明了在该框架内如何解释平均值、理想值和样本值。当理想值位于平均值下方时,如果样本低于平均值并更接近理想值,则产生正的 α。当理想值位于平均值上方时,如果样本高于平均值并朝理想值移动,则产生正的 α。归一化值 α^ 进一步指示样本是否超过理想值、等于理想值、位于平均值和理想值之间、等于平均值,或落在理想值的相反侧。在许多概念上,作者将落在平均值理想侧的样本数量与二项式零假设进行比较,其中处于理想侧的概率为 0.5。这为衡量规范性是否系统地影响 LLM 采样提供了统计流程。
实验
实验使用具有指定价值体系的受控新颖概念,以及跨多个领域和模型的真实世界概念,评估 LLM 采样是否不仅受统计平均值塑造,也受规范性理想塑造。结果表明,当不存在明确理想时,样本大体遵循统计分布;而引入正向或负向价值体系会使样本移向均值靠近理想的一侧,并且这种模式也出现在对现有概念和原型的判断中。与人类研究的比较显示,规范性具有大致相似的影响,尽管 LLM 常表现出更强或更绝对的倾向理想化,表明存在潜在的公平性和对齐问题。
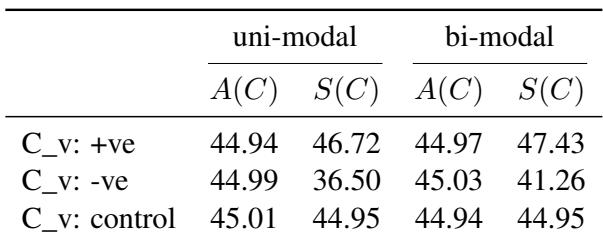
在所有设置中,自报告平均值接近给定分布均值,而采样值均值跟踪指定的规范性规范。在中性控制条件下,采样值与自报告平均值或真实均值没有显著差异。当强调正向规范时,样本上移;当强调负向规范时,样本下移;这种效应在单峰和双峰输入中均可见。在所有条件下,自报告平均值都与真实分布均值一致;采样均值朝正向规范移动并远离负向规范;中性控制显示采样与统计平均值匹配。
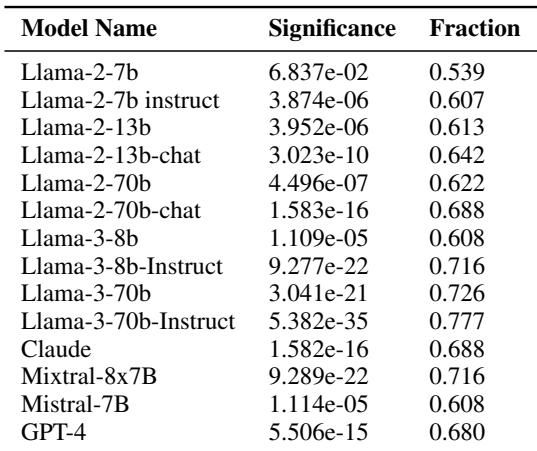
在所列出的语言模型中,采样概念值倾向于偏离描述性平均值并移向理想化值,这表明模型判断中存在规范性成分。与预训练基础模型相比,这种趋势通常在更大的模型以及 chat 或 instruct 变体中更强。结果表明,规范影响在预训练后已经存在,并会被对齐训练放大。更大的模型倾向于显示出向理想值更强的移动。chat 或 instruct 变体通常比基础模型表现出更强的规范影响。大多数模型的偏离具有统计显著性,支持存在系统性偏差。
平均后的概念分数显示,原型判断不会坍缩为简单平均值;在所测概念中,原型评分相对于平均评分更高。原型评分也通常与理想评分更紧密一致,表明规范性规范塑造了典型示例如何被表征。对于狗、祖母、医院和立体声音箱等概念,这种模式最强,其中原型位于比平均值更接近理想值的位置。在所测概念中,原型分数超过平均分数,表明判断更偏向理想化表征,而不是仅描述性表征。原型分数通常比平均分数更紧密跟踪理想分数,其中立体声音箱和假期显示原型评分位于两者之间,而不是简单匹配其中之一。沙拉显示一种异常模式,其中原型评分同时超过平均评分和理想评分,表明理想成分并不完全决定原型性。
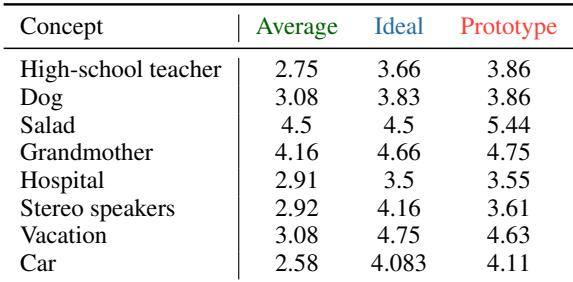
在受控分布任务和模型比较中,实验考察自报告平均值、采样值、原型评分以及理想或规范性规范是否发生分化。结果显示,自报告平均值跟踪真实统计均值,而采样值和原型判断会系统性地移向指定规范或理想化规范,并在正向或负向规范线索下呈现更强效应。这种规范性偏向出现在多个语言模型中,尤其是在更大的模型以及 chat 或 instruct 变体中,表明对齐会放大理想化规范;同时它也塑造了日常概念的原型性判断,尽管某些概念表现出个性化偏离。