Command Palette
Search for a command to run...
PARME:面向中东低资源语言的平行语料库
PARME:面向中东低资源语言的平行语料库
摘要
中东地区以其显著的语言多样性为特征,拥有超过4亿人口,使用跨越多个语系的60多种语言。本研究首次为该地区八种严重资源不足的语言变体开发了平行语料库——PARME,解决了低资源场景中的基本挑战,包括非标准化书写和方言复杂性。通过一项广泛的社区驱动倡议,志愿者贡献了超过36,000个翻译句子的创建,标志着资源开发的一个重要里程碑。我们通过零样本方法和使用预训练机器翻译模型的微调实验评估了机器翻译能力,并提供了对局限性的全面分析。我们的发现揭示了现有技术在处理所选语言方面的显著差距,突出了中东语言技术改进的关键领域。
一句话总结
苏黎世大学及合作机构的研究人员提出了PARME,这是首个针对八种严重资源不足的中东语言变体的平行语料库,通过社区驱动的努力构建,包含超过36,000个翻译句子,并通过零样本和微调实验表明,现有的机器翻译技术无法应对这些语言,揭示了需要改进的关键差距。
核心贡献
- PARME引入了首个针对八种严重资源不足的中东语言变体的平行语料库,通过社区驱动的努力,由超过40名母语志愿者参与,包含36,384个三语翻译对,为先前缺乏数据集的语言提供了公开可用的数据集。
- 评估使用零样本方法和微调实验,使用NLLB等预训练模型在各种多语言配置下进行,为这些低资源语言的翻译性能和局限性提供了系统分析。
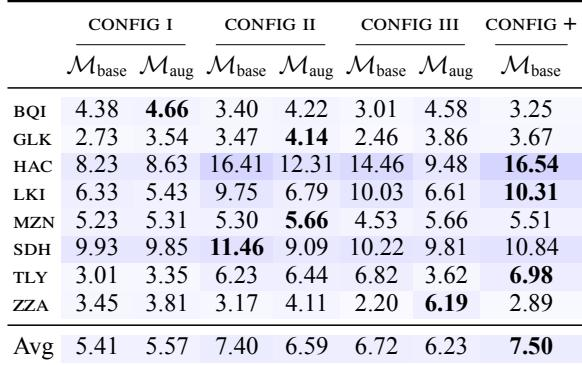
- 基线X到英语BLEU分数在多种语言中低于1,而最佳微调模型的平均X到英语BLEU分数达到7.50,其中Hawrami以16.54达到最高性能,展示了可衡量的改进,并揭示了该地区现有语言技术的关键差距。
引言
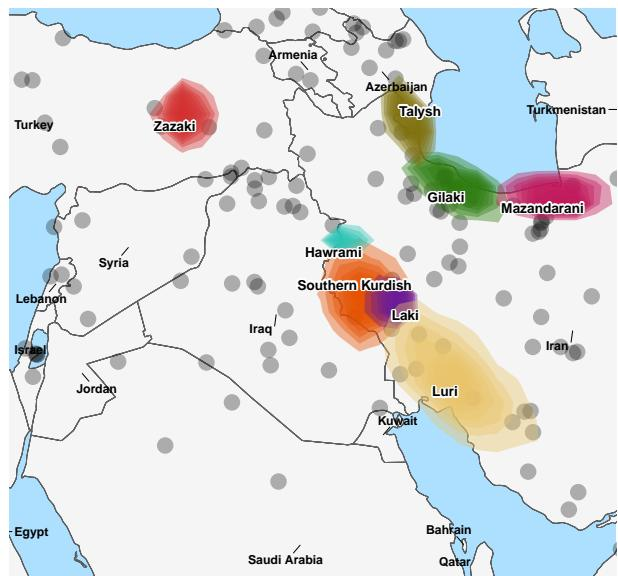
中东地区拥有超过4亿人口的丰富语言景观,然而其许多语言在数字工具和资源中仍然严重缺乏代表性。联合国教科文组织将该地区的60种语言变体列为濒危语言,其中许多面临政治边缘化、拼写系统竞争、教育材料有限以及代际传承下降等问题。此前针对这些语言的NLP工作尚处于起步阶段,因为大多数语言以口头传统为主,没有标准化的书写系统,也缺乏现代机器翻译(MT)系统所必需的平行语料库。为了解决这一差距,作者专注于八种代表性不足的语言,包括Luri Bakhtiari、Gilaki、Hawrami、Laki Kurdish、Mazandarani、Southern Kurdish、Talysh和Zazaki,并实施了一项社区驱动的倡议来构建平行语料库,以评估和创建MT系统。他们对预训练模型在零样本和微调场景中进行了实验评估,表明要开发有效的翻译工具仍需大量工作,并为更广泛的低资源语言开辟了新的研究途径。
数据集
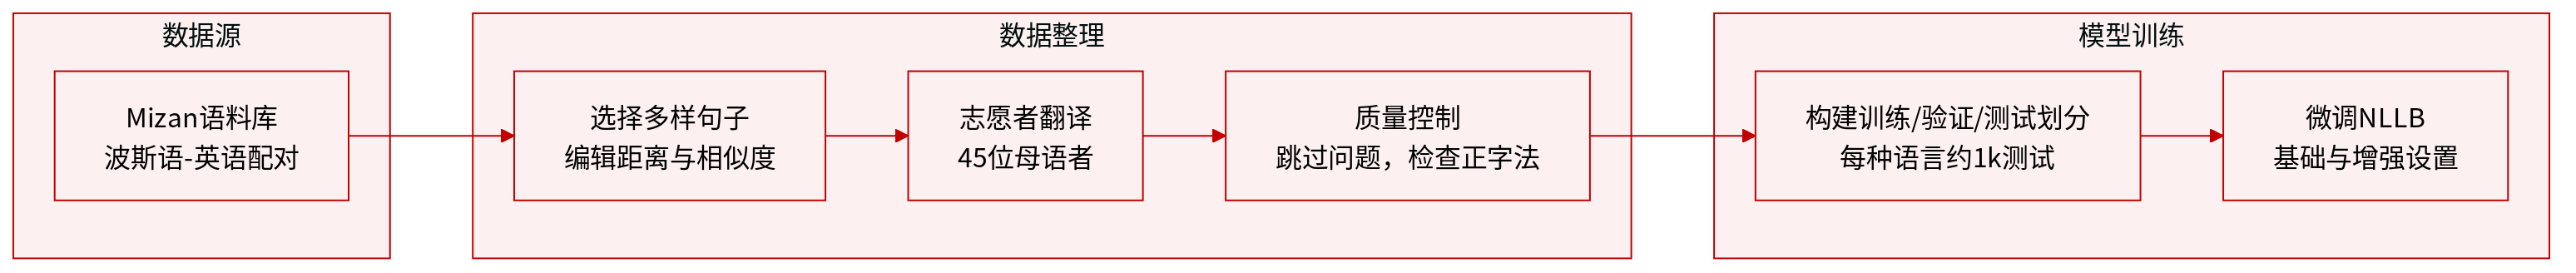
作者介绍了PARME,这是一个新的平行语料库,旨在解决机器翻译(MT)中低资源中东语言的数据稀缺问题。数据集的构建受到技术需求和实际约束的驱动,例如缺乏标准化的语言变体和依赖志愿者贡献。
数据集组成和来源
- PARME是一个平行语料库,包含八种资源不足语言的36,384个翻译对:Luri Bakhtiari(BQI)、Gilaki(GLK)、Hawrami(HAC)、Laki(LKI)、Mazandarani(MZN)、Southern Kurdish(SDH)、Talysh(TLY)和Zazaki(ZZA)。
- 源句子选自Mizan Farsi-English双语语料库。还提供了额外的参考翻译,以英语和波斯语作为主要参考语言,但Zazaki除外,它使用英语和Northern Kurdish。
翻译倡议
- 该语料库由45名目标语言母语的志愿翻译者创建,通过社交媒体和个人网络招募。
- 贡献者收到了英语和他们熟练掌握的第二语言(如波斯语或土耳其语)的源句子。翻译工作主要使用电子表格完成。
- 为解决资源限制问题,做出重大贡献的志愿者被提供论文的共同署名权。
数据选择和处理
- 作者使用特定算法从源语料库中选择句子,以最大化词汇多样性、句子长度多样性和语义丰富性。
- 选择过程涉及清理数据,以移除包含命名实体、省略、语码转换、URL和其他信息量较少的句子。
- 根据每个候选句对与先前选择句子的编辑距离与其语义相似度的比率计算分数。该分数旨在奖励编辑距离较高的新颖句子,同时惩罚与现有选择语义过于相似的句子。
- 选择过程是迭代的,使用3,000句的批次,并重复直到源语言达到15,000句的最终语料库大小。相似度使用Sentence-BERT嵌入计算。
语料库统计和质量控制
- 最终语料库包含所有语言的36,384个句对。在规模方面,Luri Bakhtiari(BQI)的句子最少,Southern Kurdish(SDH)最多。
- 质量控制措施包括允许翻译者跳过有问题的句子,标记空翻译以排除,并要求一致的拼写。最终翻译也由至少另外两名翻译者检查。
评估集构建
- 为测试目的,为每种语言创建了约1,000个实例的独立评估集。测试集的选择标准旨在:
- 避免数据污染,确保翻译成多种方言的句子位于同一分割中。
- 确保一致的拼写。
- 对于没有标准形式的语言,保证方言分布的平衡。
- 优先选择PARME中被翻译成最多语言的句子。
模型中的数据使用
- 论文探索了两种训练实验设置:
- 基础设置使用带有英语翻译的官方训练集。对于缺乏专门训练数据的语言(BQI和TLY),其验证集被重新用作训练数据。
- 增强设置通过使用NLLB将额外参考句子(来自Northern Kurdish或Farsi)翻译成英语来扩展训练数据。
- 训练时,所有平行句子被合并并转换为JSON Lines格式,每个条目包含源句子及其英语翻译。NLLB模型在此数据上进行微调,英语(
eng_Latn)设置为目标语言,而源语言token根据数据动态设置。
方法
作者通过构建平行语料库PARME,并通过迁移学习流水线将预训练的多语言翻译模型适配到这些语言,来解决低资源中东语言平行数据稀缺的问题。整体方法结合了精心控制的数据收集工作和对NLLB模型的基于token的扩展,然后在两种实验配置下进行微调。
语料库构建
鉴于所选语言缺乏广泛接受的标准变体以及存在显著的方言差异,作者采用了务实的数据收集策略。通过社交媒体和个人网络招募具有良好写作技能的母语志愿翻译者。每位翻译者收到英语和他们熟练掌握的另一种语言(通常为Farsi或土耳其语)的源句子,以适应不同的英语水平并实现潜在的跨语言学习。翻译任务主要通过电子表格进行,并有质量控制机制。翻译者可以跳过包含不一致、拼写错误、语码转换或命名实体的句子,并且需要保持一致的拼写并保持源文本不变。活动结束时,至少另外两名翻译者验证了翻译。
数据选择
为了最大化有限人工翻译工作的效用,作者引入了一种选择算法,旨在增加词汇多样性和语义覆盖。给定一个大型双语语料库P,包含源句子s(使用高资源语言如Farsi)及其英语翻译t,该方法分批进行。在第一批中,随机采样一个有效的子集C1,其中有效性通过过滤命名实体、省略、语码转换、URL和其他信息量较少的内容来确定。对于每个后续批次,根据两个标准对候选对进行评分。每个新源句子sj′与所有先前选择句子之间的平均编辑距离计算为
Di=∣Ck−1∣1i∈Ck−1∑Levenshtein(si,sj′),候选句的英语翻译与先前选择的句对之间的平均语义相似度在嵌入空间中计算为
Si=∣Ck−1∣1j∈Ck−1∑cosine(E(ti),E(tj′)),其中E是基于Sentence-BERT(all-MiniLM-L6-v2)的句子嵌入函数。每个候选的最终多样性分数是编辑距离与语义相似度的比率:
scorei=SiDi.编辑距离较高的候选被奖励,而语义相似度高的候选被惩罚。每批选择得分最高的n个句对,过程迭代直到语料库达到15,000句的目标大小。源语料库是Mizan Farsi-English语料库,因为志愿翻译者熟悉Farsi。计算编辑距离时,两个句子的标点符号都会被移除。
翻译模型微调
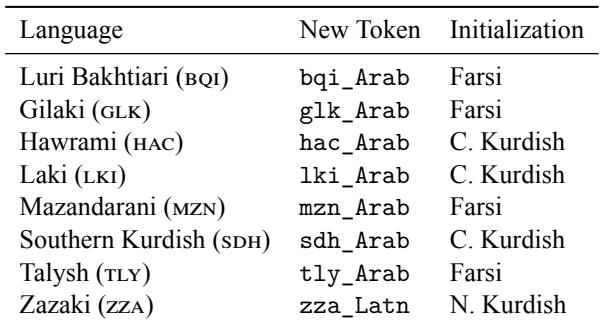
对于训练,作者采用以NLLB模型为中心的迁移学习方法,这是一个支持203种语言的多语言编码器-解码器系统。由于目标语言不是原生支持的,他们通过基于token的嵌入初始化策略扩展模型的语言能力。新的语言特定token(例如Southern Kurdish的sdh_Arab)被添加到tokenizer中,每个新token的嵌入从NLLB中已存在的语言相关语言克隆。例如,Southern Kurdish使用Central Kurdish嵌入进行初始化,其他语言也根据语言相似性应用类似的映射。这种初始化利用模型对相关语言和书写系统的现有知识,无需架构更改或完全重新训练。
基线和转写
作者使用两种模型变体评估NLLB的零样本性能:3.3B模型及其600M蒸馏变体。由于NLLB的训练数据不包含目标语言的指示token,零样本性能通过使用阿拉伯语、土耳其语、Central Kurdish、Northern Kurdish、Farsi和英语等邻近语言token输入句子来评估。为减轻不同书写系统(Perso-Arabic与拉丁字母)的影响,还探索了转写流水线。对于Southern Kurdish、Laki、Hawrami和Zazaki,基于规则的转写系统扩展了特定变体的字符映射;对于其余语言,基于音位的映射将每个字符转换为其最接近的拉丁语音等效字符。
微调设置和配置
微调专注于X到英语的翻译方向。训练数据被合并并转换为JSON Lines格式,每个条目指定新引入的源语言token,与由eng_Latn表示的英语翻译配对。基础设置使用与英语配对的训练集,对于缺乏专门训练数据的语言(BQI和TLY),验证集被重新用作训练数据。增强设置通过使用NLLB将额外可用的翻译翻译成英语来扩展训练数据,利用Northern Kurdish翻译Zazaki,利用Farsi翻译所有其他语言。探索了三种微调配置:初始设置使用批量大小8、学习率3e-5和20个epoch;增强设置使用批量大小16、学习率5e-4和50个epoch;第三种配置保留增强参数但训练100个epoch。多语言tokenization在预处理期间明确设置源语言token,同时将英语固定为目标语言。
实验
该研究通过在策划的评估集上微调NLLB来评估低资源方言翻译,零样本基线表现不佳。微调带来了显著的收益,基础设置通常优于增强设置,表明数据质量优于数量。消融研究表明,训练数据大小和跨语言迁移影响质量,但超参数和数据质量也起关键作用,而排除某些语言偶尔会使其他语言受益,表明密切相关的变体之间存在干扰。
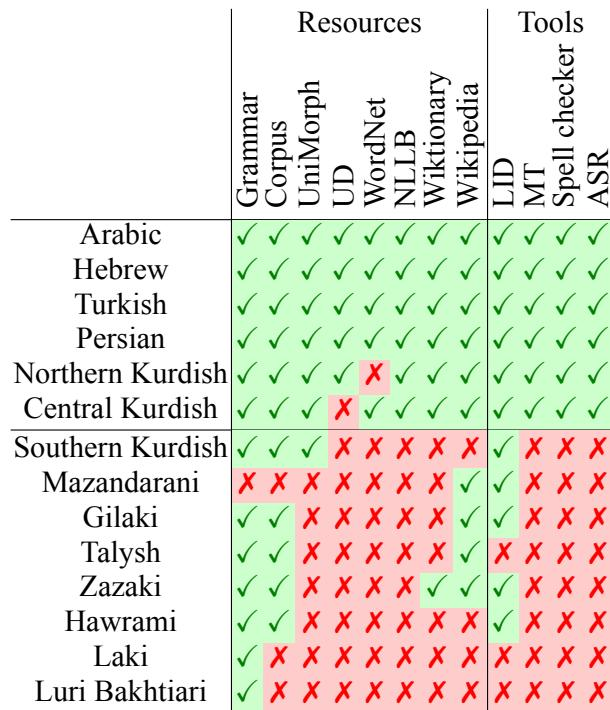
表格显示,阿拉伯语、希伯来语、土耳其语和波斯语等主要区域语言具有完整的资源和工具覆盖,而Northern Kurdish和Central Kurdish等少数民族语言缺乏某些资源,分别是WordNet和Universal Dependencies。这与主导语言形成鲜明对比,凸显了所选变体之间数字准备度的不均衡。阿拉伯语、希伯来语、土耳其语和波斯语在所有列出的资源和工具中都具有完整的可用性。Northern Kurdish缺乏WordNet支持,而Central Kurdish缺乏Universal Dependencies注释。所有选择的语言都有语言识别、机器翻译和拼写检查器,但某些变体在ASR等工具方面存在一些差距。
初始化策略向NLLB添加新的语言特定token,从密切相关的语言克隆嵌入:Luri Bakhtiari、Gilaki、Mazandarani和Talysh使用Farsi,Hawrami、Laki和Southern Kurdish使用Central Kurdish。这种方法利用预先存在的语言知识,特别是书写系统,有效扩展模型的多语言能力。新token使用四种语言的Farsi嵌入和另外三种语言的Central Kurdish嵌入进行初始化。初始化选择遵循语言相似性,旨在受益于模型对源语言书写系统的先前知识。
微调相比零样本基线大幅提高了BLEU分数,基础数据设置通常优于增强设置。在各配置中,CONFIG II取得了最佳平均性能,进一步训练适度提高了性能。增强设置对与Farsi密切相关的语言特别有帮助,而数据质量似乎比数量更具影响力。基础数据设置在各配置中大多优于增强设置,表明数据质量比数量更重要。CONFIG II实现了最高的平均BLEU分数,额外的微调仅产生了轻微的进一步改进。与Farsi密切相关的语言受益于增强设置,有些超过10个BLEU点。
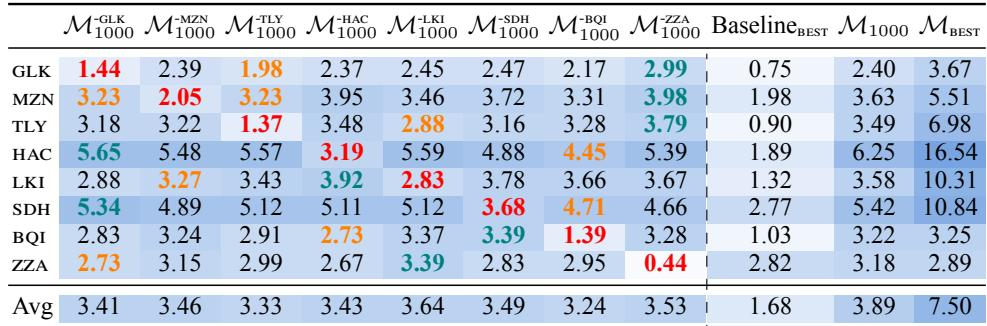
排除一种语言的微调数据通常会降低该语言的BLEU分数,与在所有1,000样本语言上训练的模型相比,但效果因语言而异。跨语言迁移是明显的,因为某些语言在排除另一种语言时得分更高,而其他语言则受损。完全微调的模型始终优于所有消融变体和零样本基线。移除一种语言的训练数据通常会降低其自身的BLEU分数,例如Gilaki从2.40降至排除时的1.44。某些排除改善了其他语言,例如当排除Zazaki时Gilaki达到2.99,超过了在完整1,000样本模型中的分数。完全微调的模型在每种语言上都取得了最高的BLEU分数,而零样本基线则远远较低。
评估凸显了所研究语言之间数字准备度的不均衡:主要区域语言具有完整的资源覆盖,而少数民族变体在WordNet和Universal Dependencies等资源方面面临差距。从密切相关的语言(例如Luri Bakhtiari使用Farsi,Hawrami使用Central Kurdish)初始化新token有效扩展了多语言模型。微调大幅优于零样本基线,数据质量比数量更具影响力,最佳配置通过进一步训练获得适度收益。消融研究表明,排除一种语言的训练数据通常会降低其自身性能,但跨语言迁移可以使其他语言受益,而完全微调的模型始终取得最高分数。