Command Palette
Search for a command to run...
I0T:迈向零模态间隙的嵌入标准化方法
I0T:迈向零模态间隙的嵌入标准化方法
Na Min An Eunki Kim James Thorne Hyunjung Shim
摘要
对比语言-图像预训练(CLIP)使下游任务(如图文检索和分类)中的零样本推理成为可能。然而,近期扩展 CLIP 的工作面临着模态间隙问题,该问题源于图像和文本嵌入被投影到不同的流形上,偏离了图文对比学习的预期目标。我们发现这一现象与每个图像或文本编码器各自具备的模态特异性特征有关。为此,我们提出两种方法来应对模态间隙问题:(1)一种事后嵌入标准化方法 I0T,可将模态间隙降低至近似为零;(2)一种可训练方法 I0T,通过为每个编码器添加两个归一化层来缓解模态间隙问题。我们的 I0T 框架能够在保持已训练模型原始嵌入表示及其冻结参数的同时,显著缩小模态间隙。在实践中,I0Tpost 可作为广泛使用的 CLIPScore(CLIP-S)的替代性可解释自动评估指标。代码已开源至 https://github.com/xfactlab/I0T。
一句话总结
KAIST AI 提出 I0T,将模态特定的编码器特征视为 CLIP 中模态间隙的来源,并通过两个变体解决该问题:一种后验标准化方法(I0Tpost),以及一种带有归一化层的可训练方法。两者都能将间隙缩小到接近零,同时保留原始嵌入,并提供一种可解释的 CLIPScore 替代方案。
核心贡献
- 该分析使用余弦距离、长度尺度和平均余弦距离对 CLIP 模态间隙进行分类,并表明归一化图像和文本编码器嵌入中持续存在的峰值激活在理论上会限制余弦相似度,并引发该间隙。
- 论文提出 I0T_post,一种后验嵌入标准化方法。该方法无需重新训练即可将模态间隙缩小到大约零,保留已训练模型的语义嵌入表示,并且可以作为可解释的 CLIPScore 替代方案。
- 论文提出 I0T_async,一种可训练方法。该方法为每个模态添加独立的归一化层。实验表明,与七个基于 CLIP 的模型和 BLIP 相比,I0T_post 和 I0T_async 都能缩小模态间隙并提升下游性能。其中,I0T_post 不增加额外训练参数,而 I0T_async 增加 10M 额外训练参数。
引言
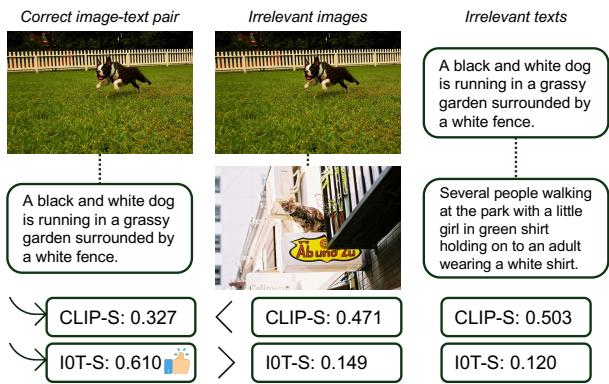
CLIP 等视觉语言模型被广泛用于多模态检索、描述生成评估和其他零样本任务,但其图像和文本嵌入通常占据潜空间中彼此分离的区域。这种模态间隙会使跨模态相似度分数变得不够可靠,尤其是在 CLIPScore 等指标中,正确的图像文本对可能比无关的同模态对获得更低的分数。早期方法主要尝试将嵌入拉近,或修改训练目标,但并没有完全识别导致该间隙的嵌入模式。作者表明,每个编码器都会形成模态特定的激活峰值,随后提出 I0T 框架,通过事后嵌入标准化和异步训练变体,在降低间隙的同时保留语义性能,并引入 I0TScore 用于跨模态评估。
方法
作者为 CLIP 等视觉语言模型提出一个两阶段框架 I0T。总体目标是在保留编码器所学语义信息的同时,缩小图像嵌入与文本嵌入之间的分离。该框架组织为两个阶段。第一阶段是即插即用的语义微调模块,如果用户只希望解决模态间隙,可以跳过该阶段。第二阶段在第一阶段之后异步执行,重点是从归一化后的图像和文本嵌入中去除模态特定特征。
在第一阶段,作者通过组合多种微调策略来改进 CLIP 的语义表示。他们沿用 Long CLIP 的实现风格,但仅使用长描述进行对齐,而不使用混合描述设置。这在保持较强下游性能的同时降低了训练成本。训练目标将标准对比学习与循环对齐损失结合,鼓励图像表示和文本表示保持相互一致。组合目标写作
LCyCLIP=LCLIP+0.25LIcyclic+0.25LCcyclic.作者使用 AdamW 优化器对 CLIP 编码器微调 3 个 epoch,学习率为 1e−6,权重衰减为 1e−2。批次大小设置为 128,对比温度使用对数值 4.6052。该阶段旨在强化语义对齐,而不直接尝试消除模态间隙。
第二阶段在语义编码器冻结后应用。作者首先考察一种事后方法来缩小模态间隙。他们观察到,简单裁剪大激活值并不充分,因为剩余激活值仍可能包含分别由图像编码器或文本编码器形成的共享方向。为了消除这些共享的模态特定模式,作者对所有隐藏维度上的归一化嵌入激活进行标准化。令 xi 和 yi 为归一化后的图像和文本嵌入激活,令 xˉ 和 yˉ 为估计得到的图像模态和文本模态均值向量。标准化后的激活为
xi′=Normalize(xi−xˉ),yi′=Normalize(yi−yˉ).该操作去除与每个模态关联的均值方向,然后对结果重新归一化。原始激活、裁剪后激活、所提出的标准化激活以及此前的一种偏移方法的比较如下所示。
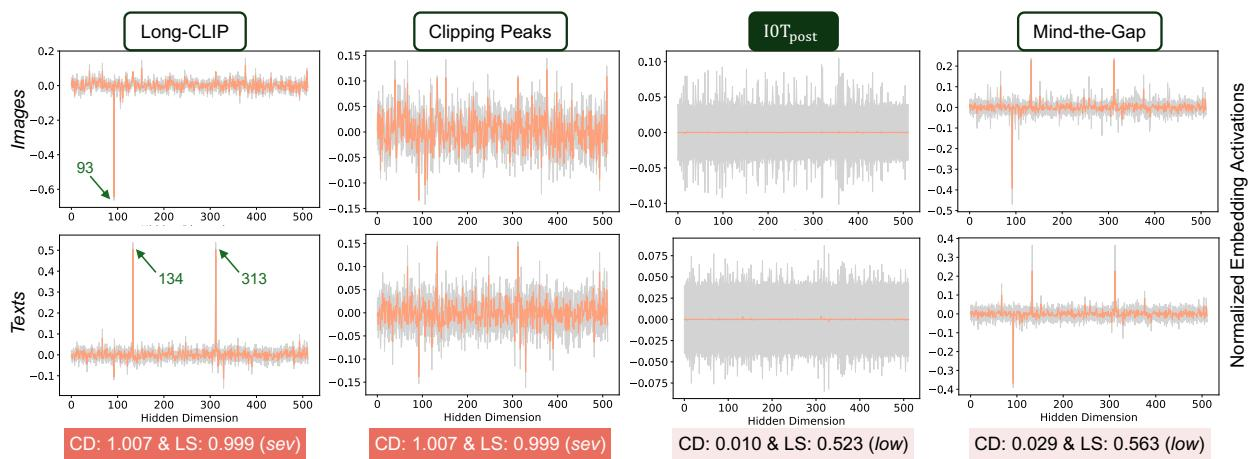
标准化后,所有隐藏维度上的均值激活接近零,方差模式也更具模态不变性。作者认为,这比仅偏移嵌入簇的方法更强,因为该方法直接消除了导致该间隙的底层激活模式。
虽然事后方法有效,但它需要从可用数据中估计模态特定的均值向量,因此并不天然支持单个样本的零样本推理。为解决该限制,作者提出一种可学习的异步方法。他们在图像编码器和文本编码器后分别添加两个独立的批归一化层。由于这些层位于冻结编码器之后,原始语义参数保持固定,而新的归一化参数则学习模态特定的均值和方差。
在训练期间,模型会更新归一化后图像和文本激活的运行均值与方差。若 xˉB 和 yˉB 为批次均值向量,则运行均值更新为
xˉt+1=αxˉB+(1−α)xˉt,yˉt+1=αyˉB+(1−α)yˉt.作者使用平均因子 α=0.1。训练结束后的最终运行统计量,记作 xˉtrain、yˉtrain、σxtrain 和 σytrain,作为学习到的模态特定特征。在推理时,转换后的嵌入由学习得到的批归一化统计量和仿射参数获得,形式为
x^i=Normalize(Wimg(σxtrain+ϵxi−xˉtrain)+bimg), y^i=Normalize(Wtxt(σytrain+ϵyi−yˉtrain)+btxt).其中 Wimg、Wtxt、bimg 和 btxt 分别为图像和文本归一化层的仿射权重与偏置。为保证数值稳定性,epsilon 值设置为 1e−5。
作者在冻结微调后的编码器之后异步训练这些归一化层。这种分离是设计的核心,因为它可防止间隙缩小模块重写 CLIP 编码器已经编码的语义内容。因此,批归一化层只学习与每个模态相关的统计偏移和缩放。
为了使学习到的统计量更鲁棒,作者引入了一种基于无监督正样本对的多模态对比增强流程。在图像和文本编码器的每一个多头注意力层中,都应用丢弃率为 0.1 的 Dropout。这会产生增强后的图像特征和文本特征,训练损失则在原始特征与增强特征的所有组合上计算。概念上,该损失可以写作
LMCSIE=EI∈{I,Iaug},ET∈{T,Taug}∑L(EI,ET).该策略扩大了正多模态关联集合,并帮助归一化层更可靠地学习模态特定统计量。最终架构保留语义编码器参数,同时允许新增的归一化分支吸收并中和产生图像文本嵌入间隙的激活模式。
实验
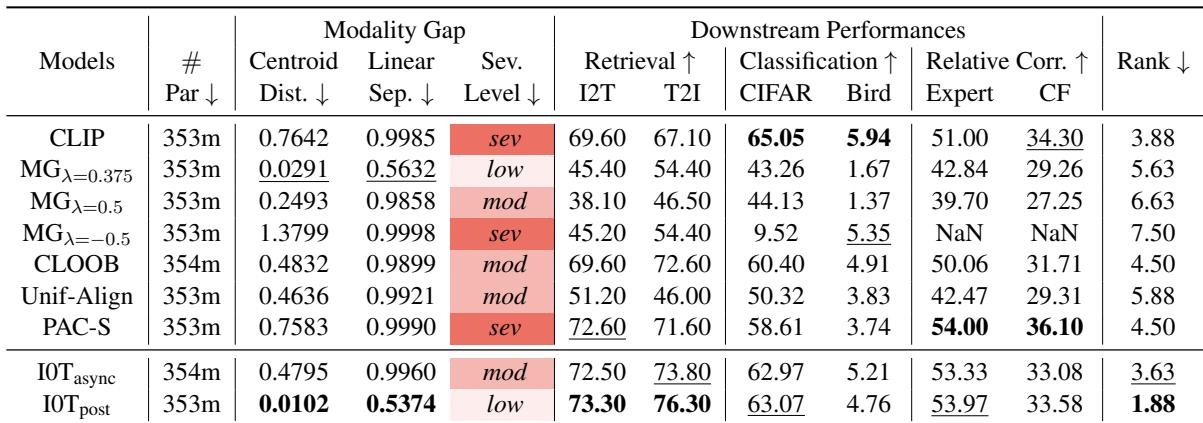
实验首先评估基于 CLIP 的训练和事后对齐能否在保留检索、分类和人工排序相关性任务的语义质量的同时,缩小图像文本模态间隙。结果表明,所提出的异步变体和事后变体可显著缩小间隙,而不损害下游效果。其中,事后方法在检索任务上尤其强,并在相关性和分类基准上具有竞争力。研究结果也支持将事后模型用作可解释、无需参考的评估指标,并表明其对齐收益在较小样本子集上即可饱和。
在所有 Long-CLIP 变体中,添加循环损失可改善下游检索,但模态间隙仍然严重。MCSIE 会略微缩小间隙,但也会略微降低下游性能,而层归一化并没有显著缓解间隙。编码器特定批归一化会产生中等程度的间隙,而异步变体在间隙缩小和检索上表现最佳。循环损失训练可以在不消除模态间隙的情况下改善检索。对每个编码器进行异步批归一化,能够在更低的模态间隙与检索性能之间取得更好的平衡。
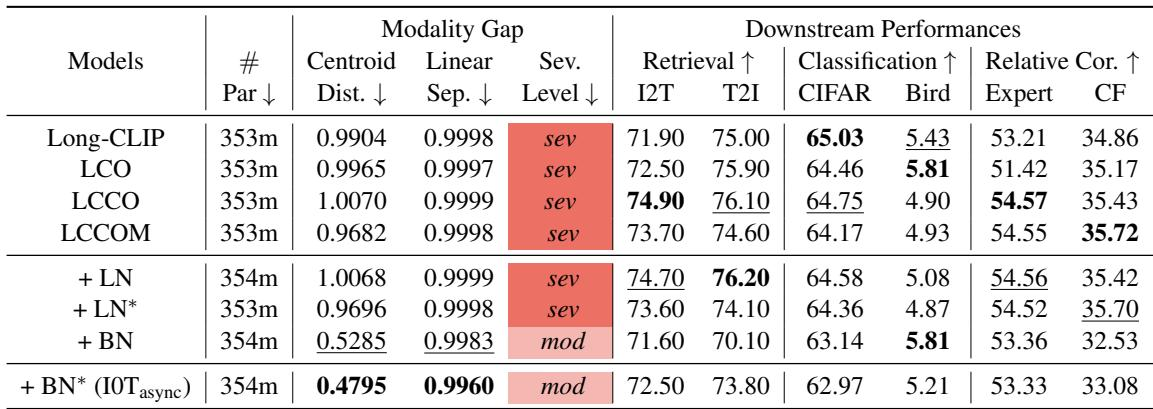
比较结果表明,缩小模态间隙可以保留具有竞争力的下游性能,尤其是在检索任务上。基线模型表现出严重的模态间隙,而所考察的变体将间隙缩小到低或中等水平,并没有广泛损害语义评估。结果也表明,间隙缩小并不保证在每个下游任务上都取得最佳结果。基线模型具有严重的模态间隙,而间隙缩小方法产生显著更低的分离度量。具有较小模态间隙的方法在图像到文本检索和文本到图像检索上仍保持竞争力。分类和相关性性能并不始终随间隙缩小而提升,因此仅凭间隙大小并不能完全预测下游质量。
为事后嵌入偏移使用更多测试样本会持续缩小模态间隙,并且在所有测试样本量下严重程度都保持较低。检索性能在小样本量时快速提升,随后趋于饱和,因此无需大型子集即可实现具有竞争力的图像文本检索。使用完整测试样本集时获得最佳检索结果。较小的测试子集已经可以产生较低的模态间隙严重程度。当样本数量超过小型子集后,检索收益变得较为有限。使用整个测试集可获得最强的整体检索性能。
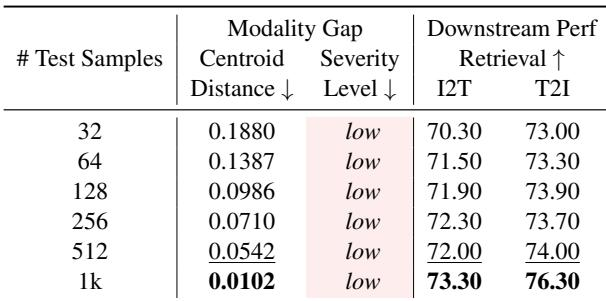
实验评估了 Long-CLIP 的间隙缩小策略,包括循环损失、MCSIE、层归一化、编码器特定批归一化和异步批归一化。循环损失和异步编码器特定归一化能够在缩小模态间隙的同时改善检索,而 MCSIE 和层归一化带来的权衡较弱,或更不利。进一步分析表明,使用适度测试样本的事后嵌入偏移已经可以产生较低的间隙严重程度和接近饱和的检索性能,尽管使用完整集合会带来最佳结果。总体而言,缩小模态间隙支持具有竞争力的检索,但并不一致地保证在所有下游任务上都取得更好性能。