Command Palette
Search for a command to run...
闪光的未必是创新:AI 生成研究中的抄袭问题
闪光的未必是创新:AI 生成研究中的抄袭问题
Tarun Gupta Danish Pruthi
摘要
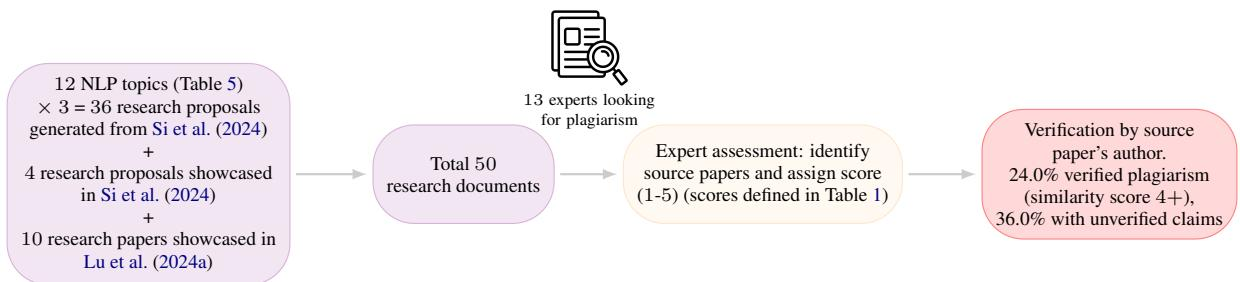
科研自动化被视为科学的终极前沿。近期,多篇论文声称自主科研智能体能够生成具有原创性的研究想法。在一片乐观氛围中,我们记录了一个关键隐忧:相当比例的研究文档存在精心伪装的抄袭行为。与以往由专家评估研究想法新颖性和可行性的做法不同,我们邀请 13 位专家在一种不同的情境逻辑下工作:识别大语言模型(LLM)生成的研究文档与已有工作之间的相似性。令人担忧的是,在评估的 50 份研究文档中,专家识别出 24% 为改写(方法一一对应)或大幅借鉴自已有工作。这些被报告的实例已由源论文作者交叉验证。此外,专家发现另外 32% 的想法与已有工作存在部分重叠,仅有极少数为完全原创。问题在于,这些 LLM 生成的研究文档未标注原始来源,且能绕过内置的抄袭检测器。最后,通过控制实验,我们表明自动抄袭检测器在捕获此类系统的抄袭想法方面表现不足。我们建议对 LLM 生成的研究成果进行审慎评估,并讨论了这些发现对学术出版的影响。
一句话总结
印度科学研究所的研究人员评估了由自主研究 agent 生成的 50 份 LLM 生成研究文档,发现其中 24% 是对现有工作的改写或显著借用,32% 与既有研究部分重叠;同时,受控实验表明,自动抄袭检测器不足以捕获这类被抄袭的想法,这凸显了对 LLM 生成研究内容进行审慎评估的必要性。
核心贡献
-
该论文首次以专家主导方式对 LLM 生成研究文档中的抄袭进行系统审计,要求 13 位专家将 50 份生成文档与现有文献比较,而不是孤立地判断新颖性。
-
审计发现,受评估文档中有 24% 存在一对一方法论映射的改写,或显著借用现有工作,另有 32% 与既有研究部分重叠,缺少来源标注,且报告案例已由来源论文作者交叉核实。
-
受控实验表明,当前自动抄袭检测器,包括传统文本匹配工具和检索增强型 LLM 系统,未能捕获 LLM 生成研究文档中复杂微妙的想法抄袭。
引言
作者研究了一个在自动化科学发现中既有现实性又有后果性的问题:LLM 正越来越多地被用于生成研究假设、提案和论文,因此必须评估其输出是否真正新颖,还是只是回收既有工作。已有研究主要通过让专家评分新颖性或使用基于 LLM 的评审器来评估 LLM 生成的想法,且通常使用相对较小的样本。这具有挑战性,因为科学新颖性是主观的,而现有自动抄袭检测器可能遗漏高度改写或结构相似的内容,尤其是当 LLM 输出没有明确引用来源时。
作者提出一种更具对抗性的专家主导评估方式,要求研究人员主动寻找 LLM 生成研究文档中的抄袭。在这 50 份文档中,作者发现,当被引用论文的作者可联系时,24.0% 的文档显示出明显抄袭迹象;在纳入涉及无法联系作者的声明后,该比例升至 36.0%。作者还表明,当前工具如基于嵌入的检索和商业检测器并不充分,这提示 LLM 生成的研究内容可能表面上看起来新颖,却大量借用了既有工作。
数据集
-
数据集目的与构成
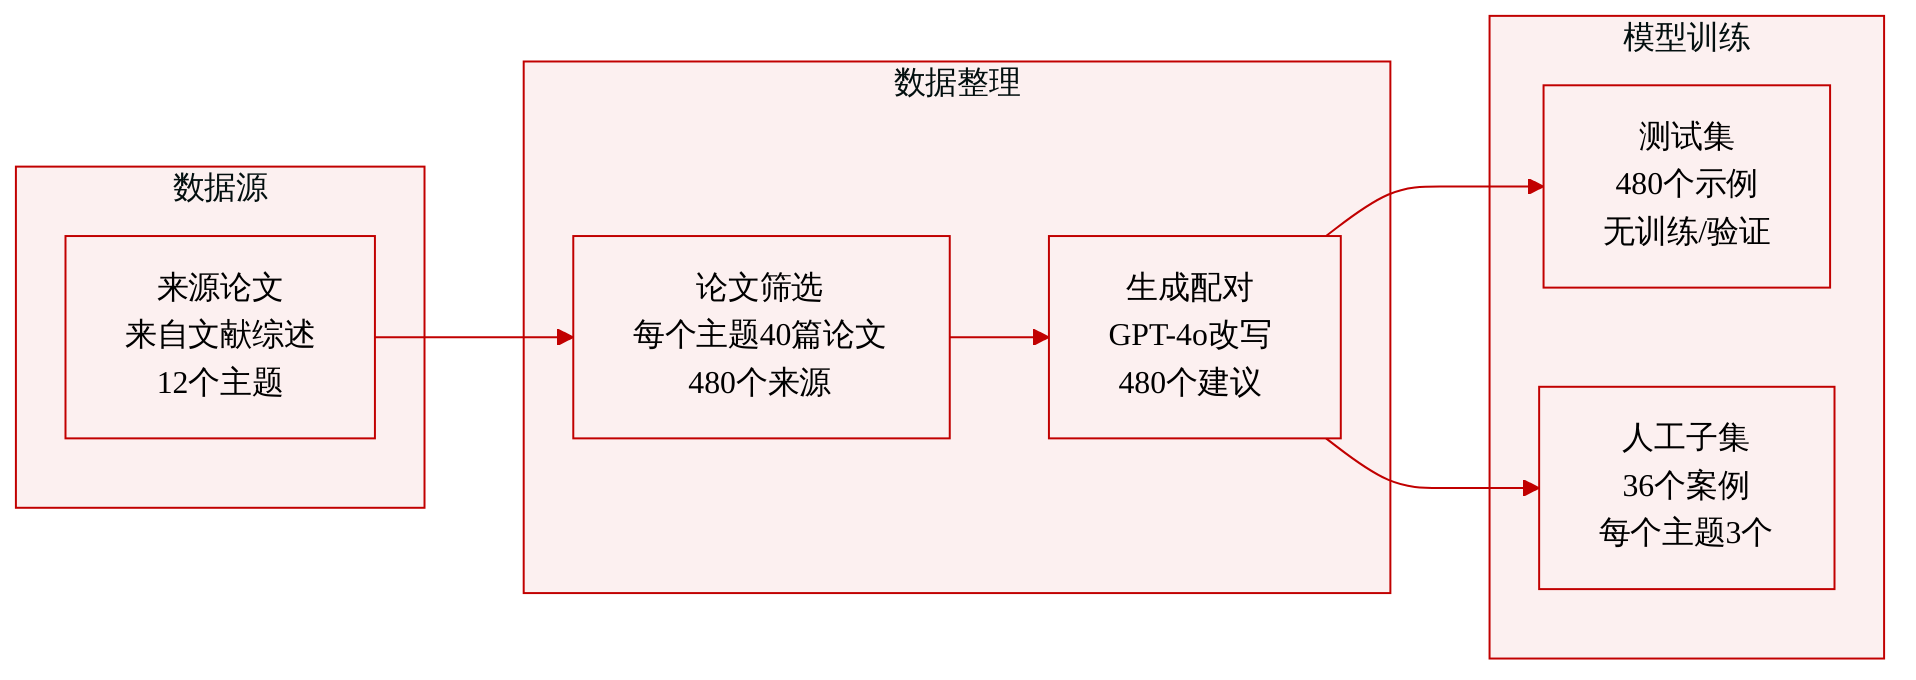
- 作者为抄袭检测构建了一个合成评估数据集,由生成的抄袭研究提案与其原始来源论文配对组成。
- 该数据集用作测试集,而不是用于模型训练的训练语料或混合训练数据。
-
来源论文与子集规模
- 原始来源论文是在基准方法的文献综述步骤中检索得到的。
- 作者选取 12 个研究主题,每个主题使用 40 篇论文,形成一个包含 480 篇来源论文的测试集。
- 每篇来源论文与一份生成的抄袭提案配对,得到 480 个提案与来源论文配对样本。
-
生成过程
- 使用 GPT-4o 生成抄袭提案,通过改写来源论文细节来规避检测。
- 作者选择 GPT-4o 是因为 Claude 3.5 Sonnet 会拒绝涉及抄袭的请求。
- 生成所用 prompt 在论文中另行提供。
-
Schema 与元数据
- 每个数据集样本可理解为包含研究主题、原始来源论文以及生成的抄袭提案。
- 论文未说明除主题选择和基于 prompt 的生成之外的裁剪、多模态提取或额外过滤。
-
数据使用方式
- 完整 480 个样本集用于在多种设置下评估抄袭检测器。
- 在 oracle 访问设置中,模型同时接收提案及其来源论文,并判断是否发生抄袭。
- 在参数知识设置中,模型必须仅依靠内部知识检索并判断相似度,不使用外部检索工具。
- 在 Semantic Scholar 增强检索设置中,系统先通过 Semantic Scholar 检索候选论文,再判断提案与检索到的论文之间的相似度。
-
用于人工工具的缩减评估子集
- 对于 OpenScholar 和 Turnitin,由于人工提交和人工审查限制,每个研究主题只评估 3 份生成的提案。
- 这将在 12 个主题上形成包含 36 个提案案例的缩减子集。
-
数据集解读
- 该数据集比现实世界中的抄袭检测更容易,因为每份提案都是针对单篇已知来源论文生成的抄袭内容。
- 作者指出,检测器在这个合成集合上的表现,可能会高估其对旨在生成新颖研究内容的系统所产生更隐蔽抄袭的检测能力。
方法
提案生成流程被组织为多阶段工作流,Claude 3.5 Sonnet 作为中心语言模型。对于每个研究主题,流程首先启动一个检索增强生成模块,该模块查询 Semantic Scholar API,检索相关论文,并对其进行排序,以提供证据基础。这些检索到的论文随后用于生成初始 seed ideas。初始 idea 通过文本嵌入去重,仅保留约 5% 的原始 idea,以移除语义重复并保留多样性。其余 idea 被扩展为完整项目提案,每个提案包含标题、问题陈述、动机、拟定方法、实验计划、测试用例和备选方案。这些提案随后进入瑞士锦标赛选择模块,通过五轮两两比较进行评估,以识别最强候选。
在提案生成之后,流程应用一个基于 Semantic Scholar Augmented Generation 的抄袭检测模块。该模块迭代生成面向 Semantic Scholar API 的搜索查询,并将先前检索到的论文作为上下文,以优化后续查询。迭代检索在收集到 100 篇论文或完成 10 次搜索迭代后停止。随后,语言模型对这些检索到的论文进行与提案相关性的评分,并保留最相似的十篇。Claude 3.5 Sonnet 在提案与每篇 top 论文之间进行两两比较,判断提案是否与某篇检索到的论文存在显著相似。若检测到显著相似,该提案将被丢弃。这一过滤阶段仅移除很小比例的提案,约为 1%,表明该检测模块作为保守的最终保障。
为优化计算成本,流程调整初始 idea 生成量。与每个主题生成极大数量 idea 不同,流程为每个主题生成 500 个 idea。经去重后,每个主题约得到 138 个唯一 idea,而在更大规模设置中约为 200 个。唯一 idea 数量的降幅远小于原始生成 idea 数量的降幅,这反映收益递减:随着生成 idea 数量增加,重叠增加,新增唯一 idea 的份额下降。排名、抄袭检测和其余生成步骤遵循与原始流程相同的整体设计,而减少的采样成本提供了更具成本效益的版本,同时保留相当比例的唯一提案。选择该方法是因为它反映研究 idea 生成中常见的 prompt 工程模式,支持更广泛的评估设置,并使用相对简单的 prompt,从而在较少受到复杂 prompt 构造干扰的情况下评估语言模型的原始能力。
实验
实验结合了对 LLM 生成研究提案的专家评估、作者核实,以及一个用于自动抄袭检测器的合成测试集。专家评估验证了领域专家能够识别严重的方法论重叠和未注明出处的借用,而检测器研究则验证了基于 LLM 的工具和商业工具中的检索与相似度判断。总体而言,LLM 生成的提案表现出显著的内容挪用和多样性不足,当前自动抄袭检测方法不足以进行可靠识别。
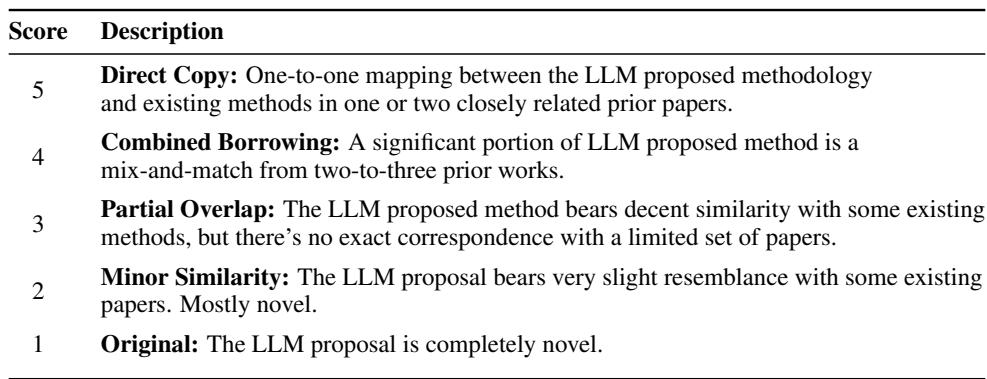
评分表提供五个等级,用于判断 LLM 生成研究提案与既有工作的接近程度。得分越高表示方法论重叠越强;最高等级专用于直接复制,最低等级专用于完全原创提案。中间等级用于区分部分或轻微相似,而不是与少量既有论文存在精确对应。最高分数标识那些与密切相关既有论文中现有方法存在一对一映射的提案。仅次于最高分数的得分表示从多篇既有作品中进行了显著但未注明出处的借用。中间分数描述尚可的相似性,但并未与有限论文存在精确对应。较低分数表示轻微相似且大体原创的提案。
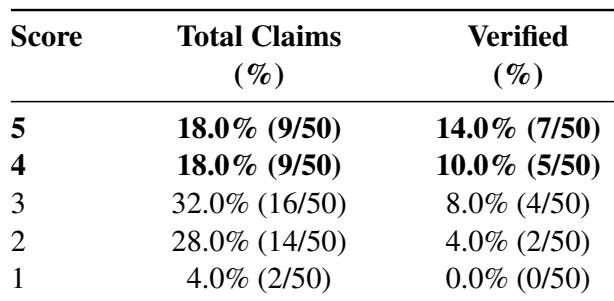
专家评估表明,LLM 生成的研究提案可能包含抄袭内容,已确认案例出现在高相似度等级。由于核实仅限于初始得分较高的提案,所报告抄袭率可能低估真实程度;纳入未经核实的最高分声明会提高疑似比例。经核实的抄袭出现在最高相似度评分的提案中。纳入未经核实的最高分声明会提高估计抄袭率。现有自动工具未能一致识别已核实高相似度文档的来源论文。
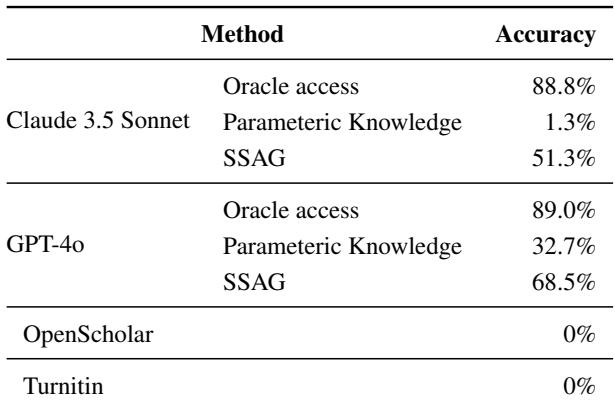
即使在提案被刻意抄袭的更现实式场景中,自动抄袭检测器的表现也很差。同时提供来源论文和疑似提案可获得最强检测准确率,但这种 oracle 设置很少可用,因为来源未知。基于检索的方法和参数知识方法明显更弱,OpenScholar 未能检测到抄袭。oracle 访问产生最佳结果,表明来源已知时相似度评估更容易。SSAG 和参数知识方法仍然有限,表明检索到正确来源论文是主要瓶颈。
该表表明,从人写论文的同行评审中识别出的抄袭迹象,远低于报告给 LLM 生成提案的整体比例。估计比例因会议场所而异,其中某个会议场所显示出最强信号,而若干会议场所仅显示出少量由评审引发的担忧。该模式支持定性比较,而非对实际抄袭的确切测量。自动同行评审分析仅在人写论文中检测到有限的抄袭迹象。人写论文中的抄袭信号明显低于 LLM 生成提案中发现的信号。检测到的担忧因会议而异,较高分数的信号很少见。
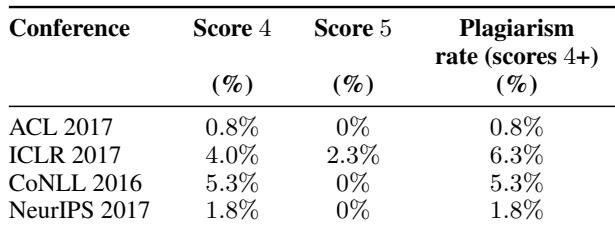
实验使用五级相似度评分表和专家核实,评估 LLM 生成研究提案是否复制既有工作,确认抄袭集中在最高相似度提案中。自动检测实验显示,工具在给定来源论文时表现最强,而检索方法和参数知识方法较弱,表明识别正确既有工作是主要瓶颈。相关基于评审的比较发现,人写论文中的抄袭信号远少于 LLM 生成提案,但该分析可能低估实际案例。