Command Palette
Search for a command to run...
LATIM:度量 Mamba 模型中潜在的 Token 间交互
LATIM:度量 Mamba 模型中潜在的 Token 间交互
Hugo Pitorro Marcos Treviso
摘要
状态空间模型(SSM)如 Mamba 已成为 Transformer 在长上下文序列建模方面的高效替代方案。然而,尽管其应用日益广泛,SSM 仍缺乏对于理解及改进注意力机制架构至关重要的可解释性工具。尽管近期研究为理解 Mamba 的内部机制提供了见解,但它们难以在层级上捕捉精确的 token 级交互,使得对 Mamba 如何在各层间选择性处理序列的理解仍存在空白。本文提出了 LATIM,一种面向 Mamba-1 和 Mamba-2 的新型 token 级分解方法,能够实现细粒度的可解释性分析。我们在包括机器翻译、复制和基于检索的生成在内的多种任务上对方法进行了广泛评估,证明了其在揭示 Mamba 的 token 间交互模式方面的有效性。代码已开源,地址为 https://github.com/deep-spin/latim 。
一句话总结
Instituto de Telecomunicações 的研究人员提出 LATIM,一种针对 Mamba-1 和 Mamba-2 的 token 级分解方法,用于在层级别捕获精确的 token-to-token 交互,并在机器翻译、复制和检索式生成上得到验证。
核心贡献
-
LATIM 被提出为一种针对 Mamba-1 和 Mamba-2 的 token 级分解方法,它将特征交互分析扩展到状态空间模型,以实现对长上下文序列建模的细粒度可解释性。
-
该方法对 Mamba 层中的单个 token 贡献进行分解,以揭示 token-to-token 交互模式和选择性信息流,并且还可以应用于 DeltaNet 和 mLSTM 等线性循环架构。
-
在复制、机器翻译和检索式生成上的实验表明,LATIM,尤其是 ell_2 变体,阐明了 Mamba 的召回行为,包括对相关 tokens 的稀疏且逐渐衰减的关注;同时,精确对应版本在不损害可解释性或任务性能的情况下消除了近似误差。
引言
Mamba 等状态空间模型越来越多地用于长上下文序列建模,因为它们可以比 Transformer 更高效地处理长输入,但由于缺乏显式注意力图,其内部决策更难检查。早期可解释性方法近似隐式注意力或跟踪逐层信息流,但未能完全捕获跨层的精确 token 级别贡献。作者提出 LATIM,一种针对 Mamba 1 和 Mamba 2 的 token 级分解方法,该方法重新表述状态空间计算,以便将 ALTI 等注意力风格的可解释性方法适配到 Mamba。该方法在复制、机器翻译和检索式生成上进行了评估,为分析状态空间模型中的 token 交互提供了更透明的方式。
方法
作者提出 LATIM,一种用于 Mamba 的分解框架,该方法重新排列前向传播,以便隔离输入 token xj 对输出 token yi 的贡献。该方法直接建立在 Mamba 风格状态空间模型使用的内部递推之上,并将原本纠缠的 token 交互转换为显式的 token-to-token 归因形式。
大致而言,一个 Mamba block 包含一个序列混合层、一个门控机制和一个输出投影。在 Mamba-1 中,输入先经过投影,然后通过因果一维卷积。卷积输出再经过 SiLU 激活进行变换,从而产生供循环状态空间模块使用的信号。SSM 参数依赖于输入,这意味着 Bi 等矩阵和 ci 等向量是当前输入的学习投影。在 SSM 产生循环输出后,第二条分支通过另一个 SiLU 激活生成门控,两条分支逐元素相乘,最后通过线性投影将结果映射回模型维度。
LATIM 使用的一个关键洞见是,Mamba 递推可以被展开为下三角交互结构。通过在位置上展开递推,SSM 输出可以被解释为通道输入乘以一个矩阵的结果,该矩阵的元素编码较早位置如何影响较晚位置。这揭示了一种隐藏的类注意力结构。然而,与标准 Transformer 注意力不同,每个 token 的贡献不会直接暴露出来。主要障碍是 SiLU 激活。由于 SiLU 是非线性且非加性的,若不引入近似,SSM 之前的信号无法干净地拆分为单独的逐 token 贡献。
对于 Mamba-1,作者通过引入加性近似函数 f 来应对这一限制,f 用于近似作用于卷积输出的 SiLU 激活。从因果卷积出发,位置 i 处的预激活值可以写成局部卷积窗口上的求和:
ψi=k=1∑wWc(k)(Wx⊤xi−w+k)+bc.如果加性函数 f 近似 SiLU 激活,则 SSM 输入可以分解为
ϕj=k=1∑wf(Wc(k)Wx⊤xj−w+k+δk,0bc),其中每一项捕获来自移位输入位置的局部卷积贡献。将该分解代入展开后的 SSM 递推,可得到循环输出的显式展开式。在加入与直接前馈分量相关的 skip 项后,位置 i 处的输出可以表示为
vi=j=1∑ik=1∑w(Mi,j+k+δi,j+kD)φj(k).这里,φj(k) 表示与第 k 个卷积核位置对应、且关联于第 j 个输入 token 的加性分量。矩阵 M 通过循环状态空间转移编码 token-to-token 交互,而 Kronecker delta 项考虑了直接输出通路。
从该表达式出发,作者分离出源自 token xj 的 SSM 输出部分:
vi←j=k=1∑w(Mi,j+k+δi,j+kD)φj(k).随后,他们将该 token 专属循环贡献传递通过门控机制和最终输出投影。如果 Zi 表示位置 i 处的门控,则来自 xj 对 yi 的贡献向量为
Ti(xj)=Wo⊤(Zi⊙vi←j).于是,block 输出可以写成这些 token 专属贡献之和:
yi=j=1∑iTi(xj).这种结构提供了与 Transformer block 中注意力分解类似的解释接口:每一项 Ti(xj) 表示较早 token 对当前输出位置的贡献。
对于 Mamba-2,block 设计相似,但有两个重要差异。首先,该递推通过将 Ai 定义为单位矩阵的标量倍数,采用了状态转移矩阵的更简单形式。其次,Mamba-2 在门控操作之后引入 GroupNorm 层,得到
ui=GroupNorm(Zi⊙vi).为了在 GroupNorm 下保留逐 token 分解,作者观察到,在推理时,GroupNorm 可以被视为围绕 ui 的某个固定值的仿射映射。具体地,
GroupNorm(ui)=γi(ui)ui+βi,其中,一旦 ui 的完整值确定,γi(ui) 就被视为固定线性算子。由于 token 专属部分 ui←j 经过相同的线性算子,因此 Mamba-2 的贡献向量变为
Ti(xj)=Wo⊤[γi(ui)ui←j].得到的贡献向量可以使用不同的聚合函数降低为标量可解释性分数,例如基于范数的归约或考虑 logit 的归约。
该方法还包括两种分解模式。近似模式不需要重新训练,并用加性替代函数 f 替换非加性 SiLU 激活。Taylor 展开被探索作为 f 的候选,但作者发现直接将 f 设置为相同的 SiLU 函数可得到最低近似误差。该近似模式会引入一些不匹配,因为原始 block 并非恰好可以分解为加性 token 贡献。
精确模式通过修改 Mamba block 本身来消除这种不匹配。卷积之后的 SiLU 激活被移除,因此 SSM 输入变为单纯的卷积输出。在这种情况下,加性函数实际上就是恒等函数,分解能够无近似误差地复现 block 输出。这一精确版本需要训练修改后的模型,但它保持相同类型的 token 贡献结构,同时实现零分解误差。
实验
实验在复制、机器翻译、检索式生成和近似误差分析上,将 LATIM 与 Mamba 可解释性基线进行比较,并把定性检查与忠实度、对齐、召回率和误差评估结合起来。在复制和翻译中,LATIM 变体,尤其是 l2 变体,比粗略的全局归因恢复出更细粒度且更可靠的 token 交互;而某些聚合变体保留稀疏性,但错过 token 级对齐。检索实验显示,Mamba 在多 key 和频率追踪任务中的选择性召回可能遇到困难,LATIM 揭示出对第一个 key 的偏好以及对 repeated tokens 的注意力逐渐下降。最后,近似误差分析表明,替换非线性激活可以得到精确且有效的方法,而实践中使用 SiLU 近似仍保持可比的解释性和翻译质量。
这些方法通过将 Mamba 计算分解为源自 token 的组件,并以不同方式对这些组件进行评分,从而计算 token 交互的贡献分数。各变体比较直接贡献幅度、移除某个贡献后的输出范数变化,以及向输出 logits 的投影。这些分数用于评估 Mamba 在召回、机器翻译和检索设置中的可解释性。基于范数的 LATIM 分数反映单个 token 贡献的幅度。基于 ALTI 的分数通过移除某个贡献导致的输出范数下降来估计重要性。基于 logit 的评分将 token 贡献与模型输出决策联系起来。这些变体与 Mamba 特定归因方法和注意力替代方法进行比较,以评估它们揭示交互结构的程度。
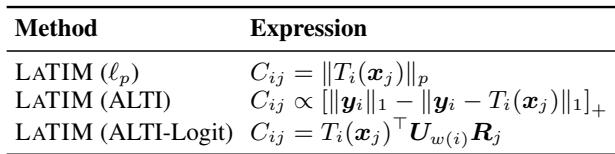
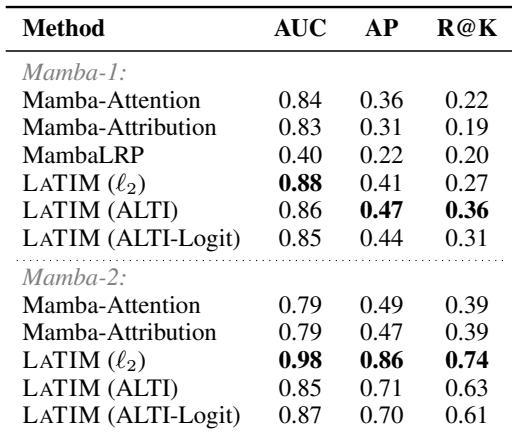
在复制任务中,LATIM 变体是 Mamba 模型中最忠实的可解释性方法,更好地恢复了预期的源 token 到 copied token 关系。它们在各种忠实度指标上优于基线注意力、归因和 LRP 方法。采用 ALTI 的 LATIM 在面向精确率与召回率的指标上领先,而采用 l2 的 LATIM 在整体曲线下面积上最强。LATIM 变体在忠实度指标上超过基线注意力、归因和 LRP 方法。在所示结果中,采用 ALTI 的 LATIM 给出了最强的平均精确率和 Recall at K。在比较方法中,采用 l2 的 LATIM 取得了最高 AUC。
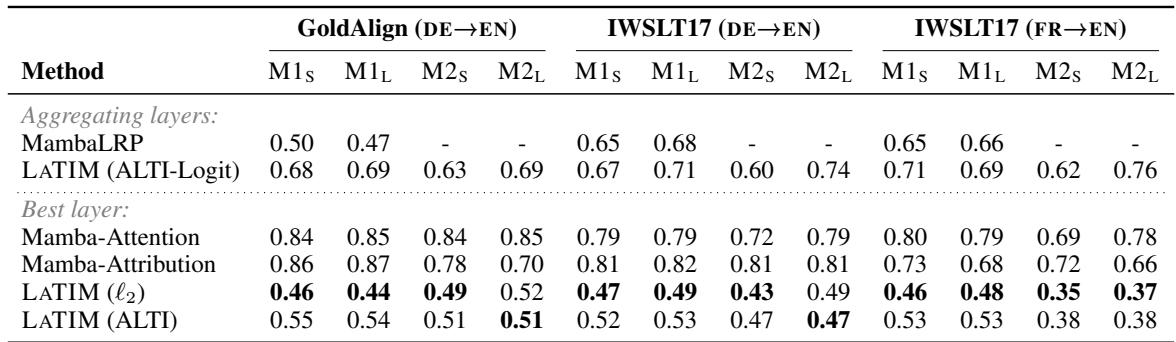
对于机器翻译 token 对齐,LATIM l2 产生最低的对齐错误率,表明其对 token-to-token 交互的捕获最强。跨层聚合相关度的方法整体效果较差,尽管 MambaLRP 的得分优于 LATIM ALTI-Logit。结果还表明,逐层对齐估计可能优于合并后的全局表示。在比较方法中,LATIM l2 取得了最佳翻译对齐准确率。当各层相关度被聚合时,MambaLRP 始终优于 LATIM ALTI-Logit。较小和较大的 Mamba 变体在解释方法之间显示出大致相似的定性差异。
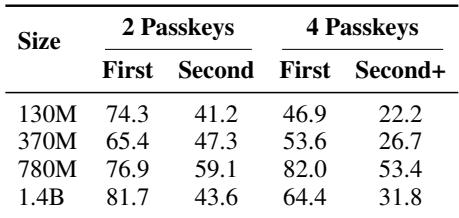
Mamba-2 在多 passkey 检索中显示出对第一个 passkey 的强烈偏好,当目标位于第一时,准确率始终高于位于第二或更后位置时。这种第一个 key 偏好在四 key 设置中尤其严重,其中较后的 keys 更难被恢复。更大的模型规模并不能一致地解决该问题,因为在若干检索条件下 780M 可以优于 1.4B。在各个模型规模上,第一个 key 的检索准确率远高于较后的 keys。四 passkey 设置会导致目标不在第一时准确率大幅下降。增加模型规模并不保证较后 passkeys 的召回率更好。780M 模型在若干条件下表现尤为突出,在某些第二个及以后 key 的情况下超过 1.4B 模型。
该比较显示,激活函数的选择同时影响近似误差和下游翻译行为。恒等激活得到精确分解和最有利的解释性指标,而 SiLU 和继续预训练的 SiLU 仍与之接近。ReLU 会产生明显更大的近似误差,尤其在更深层中,并且翻译质量更低。恒等激活实现零近似误差和最佳 AER。对于非线性激活,近似误差随层深度增加而增大。继续预训练略微改善 SiLU 误差和 COMET。ReLU 在近似误差和 COMET 上表现最差。
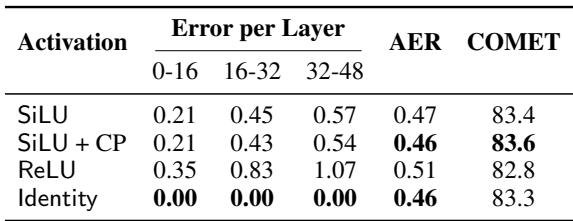
这些实验通过将 LATIM 评分变体应用于复制、机器翻译对齐、多 passkey 检索和激活敏感性等 token 交互任务来评估 Mamba 可解释性,并与注意力、归因和 LRP 基线进行比较。总体而言,LATIM 方法更忠实地恢复 token 关系,其中基于 ALTI 的分数在复制任务中表现最强,而基于 l2 的分数在翻译对齐中最佳;同时,逐层估计通常优于跨层合并后的聚合结果。检索和激活分析进一步揭示 Mamba 模型的限制,包括对较早 passkeys 的显著偏好,这一偏好无法通过模型规模扩展完全消除,以及相比 ReLU 等非线性选择,恒等激活在忠实分解方面具有明显优势。