Command Palette
Search for a command to run...
Capability Salience Vector:面向下游任务缩放定律的损失与能力细粒度对齐
Capability Salience Vector:面向下游任务缩放定律的损失与能力细粒度对齐
摘要
缩放定律建立了训练计算量与验证损失之间的关系,使研究者能够有效预测模型在不同计算水平下的损失趋势。然而,验证损失与模型下游能力之间仍存在差距,使得将缩放定律直接应用于下游任务的性能预测并非易事。损失通常代表对预测令牌的累积惩罚,其中隐含地认为各令牌具有同等重要性。然而,我们的研究表明,当考虑不同的训练数据分布时,无法直接建立下游能力与计算量或令牌损失之间的关系。为了弥合验证损失与下游任务能力之间的差距,本文提出了 Capability Salience Vector,该方法将整体损失分解,并为不同令牌分配差异化的重要性权重,以评估特定的元能力,从而在模型能力维度上将验证损失与下游任务性能对齐。在多个主流基准上的实验表明,所提出的 Capability Salience Vector 能够显著提升语言模型在下游任务上性能的可预测性。
一句话总结
来自上海人工智能实验室和复旦大学的研究人员提出了能力显著性向量,它将整体训练损失分解为与特定元能力对齐的 token 级重要性权重,从而弥合验证损失与下游任务性能之间的差距,并能够通过缩放定律实现直接能力预测。
核心贡献
- 提出能力显著性向量,将整体 token 级损失分解并给 tokens 分配可学习的重要性权重,将验证损失与特定元能力及下游任务性能建立联系。
- 开发一种自动优化方法,在文本片段上构建该向量,使用 token 级加权来捕捉与推理相关的能力,并建模语言模型交叉熵损失与下游结果之间的模型缩放关系。
- 在多个流行基准测试上评估该方法,包括一个 BBH 可视化,结果表明能力加权损失能够识别与推理相关的 tokens,并显著提升语言模型在下游任务上的可预测性。
引言
大型语言模型利用缩放定律,根据模型规模、训练数据和计算量预测验证损失,从而减少预训练期间代价高昂的试错。这一点很重要,因为验证损失是衡量进度的实用代理指标,但它并不总能预测下游基准测试上的性能,而在这些基准测试上真正重要的是任务能力。先前工作要么尝试直接从计算量建模下游性能,常常忽略预训练数据分布变化的影响,要么构建源自基准测试的代理指标,而这需要在许多模型和数据集上进行代价高昂的评估。作者表明,单独使用计算量或原始验证损失都不是可靠的预测指标,随后提出了能力显著性向量,这是一种 token 加权损失指标,具有自动优化方法,能够突出与下游能力相关的 tokens。在六个基准测试和不同模型家族上,该加权验证损失与下游分数之间产生了显著更强的相关性,并将预测均方误差保持在 0.001 以下。
方法
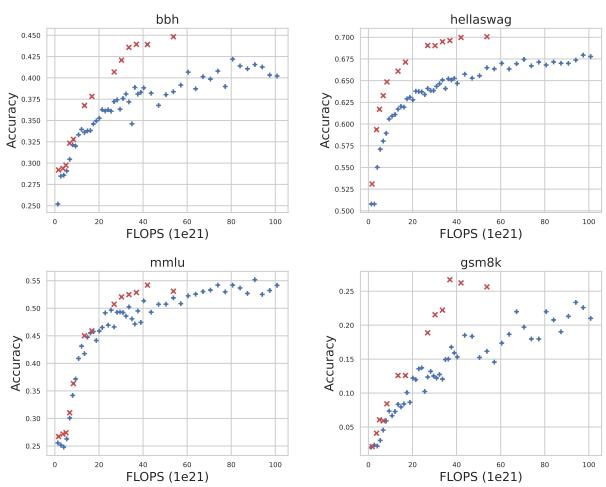
作者围绕 token 加权验证损失指标设计了下游缩放定律预测框架,而不是围绕原始计算量。他们首先测试总 FLOPs 是否能直接预测下游准确率。为此,他们在相同预训练数据池上以不同混合比例训练模型系列,并在不同计算预算下评估 checkpoints。生成的图表显示,在相同计算量下训练的模型在下游任务上可能产生显著差异,尤其是在 BBH 和 HellaSwag 等基准测试上。这表明,当预训练数据分布发生变化时,仅靠计算量无法成为稳定预测指标。如图下所示:
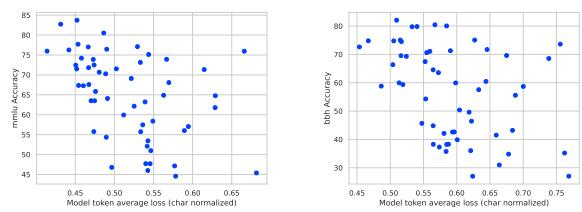
该框架随后测试第二个候选信号:平均 token 验证损失。为了减少 tokenizer 引入的失真,作者在跨模型汇总结果之前,在字符级别对损失进行归一化。即使经过归一化,平均 token 损失相似的模型仍可能获得不同的下游准确率,这表明均匀平均会丢失关于哪些 tokens 对给定能力最具信息量的信息。下图如下:
主要方法引入能力显著性向量(Capability Salience Vector,CSV),该向量给 token 级验证损失分配可学习权重。其直觉是,不同 token 片段测试不同元能力,因此某些 tokens 应当对目标下游任务的预测贡献更大。给定验证集
S={Xs}s=1∣S∣和样本 Xs=(x1,x2,…,x∣Xs∣),模型 m 的能力得分计算为
Cm=−Nc1s=1∑∣S∣i=1∑∣Xs∣ws,ilogp(xi∣x<i),其中 ws,i 是样本 Xs 中 token xi 的显著性权重,Nc 表示验证文本字符数。该能力得分用验证难度的加权汇总替代了标准均匀平均损失。
为了将该能力得分映射到下游性能,作者使用 sigmoid 函数:
At,m=γ+1+exp(−α(Cm−β))1−γ,其中 At,m 是任务 t 和模型 m 的预测准确率,α 和 β 是拟合参数,γ 表示随机猜测下的期望准确率。该公式使模型能够捕捉验证难度与下游成功之间的非线性关系,包括类阈值行为。
能力显著性向量的优化被组织为三阶段流程。首先,作者使用带有附加评分头的语言模型提取 token 权重。在分配权重之前,不同词表空间中的 token 损失需要先在对应字符上对 token 级损失取平均,以获得字符级损失,再根据目标 tokenizer 对这些损失进行聚合。评分头实现为作用于最终隐藏状态的线性层,产生
ws,i=fθ(xs,i∣xs,<i),其中 θ 包含评分头参数。在该阶段中,语言模型的其余参数保持冻结,因此模型专注于学习哪些 tokens 携带最丰富与能力相关的信号。
其次,在固定评分头参数后,作者从多个模型收集 token 损失和观测到的下游准确率,并通过估计 α 和 β 来拟合下游缩放定律函数。他们使用 Levenberg-Marquardt 算法最小化预测性能与观测性能之间的平方误差:
α,βminm∑(At,m−A^t,m)2.第三,将拟合后的下游缩放定律函数作为学习信号来优化显著性向量。作者使用随机梯度下降,针对 θ 最小化相同的预测误差:
θminm∑(At,m−A^t,m)2.这些阶段会迭代多次。因此,整体工作流会学习一种既经过 tokenizer 归一化又具备能力感知的验证损失表示,并使用该表示在拟合的非线性定律下预测下游任务性能。
实验
实验评估了在不同预训练数据分布下训练的模型,其下游缩放定律是否能由计算成本或验证损失预测。结果表明,单独使用计算成本以及均匀加权的验证损失均不充分,而赋予 token 级重要性权重的能力显著性向量能更好地使模型能力与下游性能对齐。在多种开源和自训练模型及多个基准测试上验证,该方法能够跨模型家族和数据分布预测下游能力,并且更丰富的验证样本能带来更准确的预测。
在大多数评估任务上,能力显著性向量产生的下游性能预测 MSE 低于全部 token 损失和标签 token 损失,表明预测更可靠。标签 token 损失始终具有最大误差,而全部 token 损失有时具有竞争力,但在不同基准测试上不够鲁棒。这些结果支持使用 token 加权损失作为跟踪模型能力的实用代理指标。能力显著性向量通常比全部 token 损失和标签 token 损失产生更低预测误差。标签 token 损失在所报告基准测试中是最弱的代理指标。全部 token 损失在某些任务上可以接近,但预测能力不如加权方法稳定。
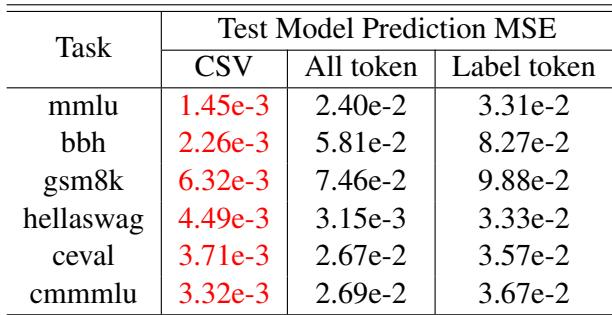
实验比较了能力显著性向量、全部 token 损失和标签 token 损失作为预测下游模型性能代理指标的效果。结果表明能力显著性向量通常更可靠并产生更低预测误差,而标签 token 损失始终是最弱的代理指标。全部 token 损失在某些任务上可以表现良好,但整体鲁棒性不足,这支持使用 token 加权损失作为实用的能力跟踪信号。