Command Palette
Search for a command to run...
HATEDAY:基于 Twitter 单日数据的全球仇恨言论代表性数据集洞察
HATEDAY:基于 Twitter 单日数据的全球仇恨言论代表性数据集洞察
Manuel Tonneau Diyi Liu Niyati Malhotra Scott A. Hale Samuel P. Fraiberger Victor Orozco-Olvera Paul Röttger
摘要
为应对网络仇恨言论这一全球性挑战,已有研究开发了检测模型以在社交媒体上标记此类内容。然而,由于评估数据集中存在系统性偏差,这些模型在真实场景下的有效性仍不明确,尤其在不同地理区域之间。我们提出了 HATEDAY——首个具有社交媒体代表性的全球仇恨言论数据集,基于 2022 年 9 月 21 日发布的全部推文的随机样本构建,覆盖八种语言和四个英语国家。利用 HATEDAY,我们发现仇恨言论的普遍程度和构成在不同语言和地区间存在显著差异。研究表明,基于学术数据集的评估会大幅高估真实世界的检测性能,而实际性能非常低,尤其是对于非欧洲语言。我们的分析识别出导致这一差距的关键因素,包括模型难以区分仇恨言论与冒犯性言论,以及学术数据集所强调的目标群体与真实场景中最常被攻击的群体之间存在错配。我们认为,糟糕的模型性能使得公开模型不适合用于自动仇恨言论审核,并发现只有借助大量人工监督才能实现较高的审核率。我们的结果强调,需要在反映真实世界社交媒体复杂性和多样性的数据上评估检测系统。
一句话总结
牛津大学、世界银行和其他机构的研究者推出 HATEDAY,这是首个具有全球代表性的仇恨言论数据集,它由 2022 年 9 月 21 日发布的所有推文中的随机样本构建,涵盖八种语言,并证明学术评估数据集大幅高估了真实世界检测性能,对于非欧洲语言尤其如此。
核心贡献
- HATEDAY 被引入为首个全球仇恨言论数据集,它由 240,000 条已标注推文构成;这些推文从 2022 年 9 月 21 日发布的所有推文中随机抽样,跨越八种语言和四个英语国家。
- 使用 HATEDAY,研究表明标准学术数据集大幅高估真实世界检测性能,尤其对于非欧洲语言,并识别出若干原因,例如难以区分仇恨言论与冒犯性言论,以及学术数据与真实话语中的目标群体不匹配。
- 审核评估显示,完全自动使用公开可用模型的错误率过高,而对被标记内容进行人工审核可以在不同语言和国家实现更高的审核率,但需要大量监督。
引言
社交媒体平台越来越依赖自动仇恨言论检测来审核可能升级为线下伤害的内容,因此模型在真实信息流中的性能成为现实安全问题。既有研究提供了不完整图景,因为平台模型通常不透明,学术基准使用有偏且不平衡的数据集,并且大多数资源仅使用英语,这限制了泛化能力和跨语言比较。作者还指出,仅按语言对内容分组可能会掩盖共享同一种语言的国家之间的重要差异。为解决这些空白,作者推出 HATEDAY,这是一个全球 Twitter 数据集,包含从八种语言和四个英语国家中抽样的 240,000 条推文,并利用它比较仇恨内容流行程度、评估公开检测模型并测试审核工作流。其评估显示,标准学术基准高估真实世界性能,公开模型在部署环境中表现较差,尤其对于非欧洲语言,完全自动审核错误率过高,而人工审核可以在付出较大人工成本的情况下提升审核效果。
数据集
-
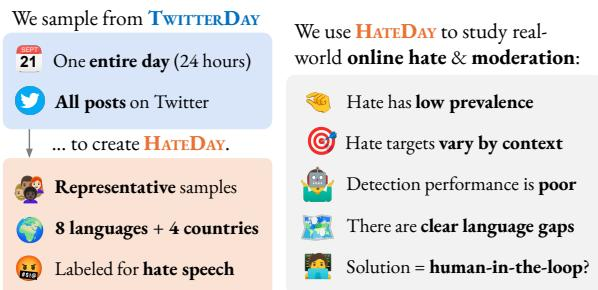
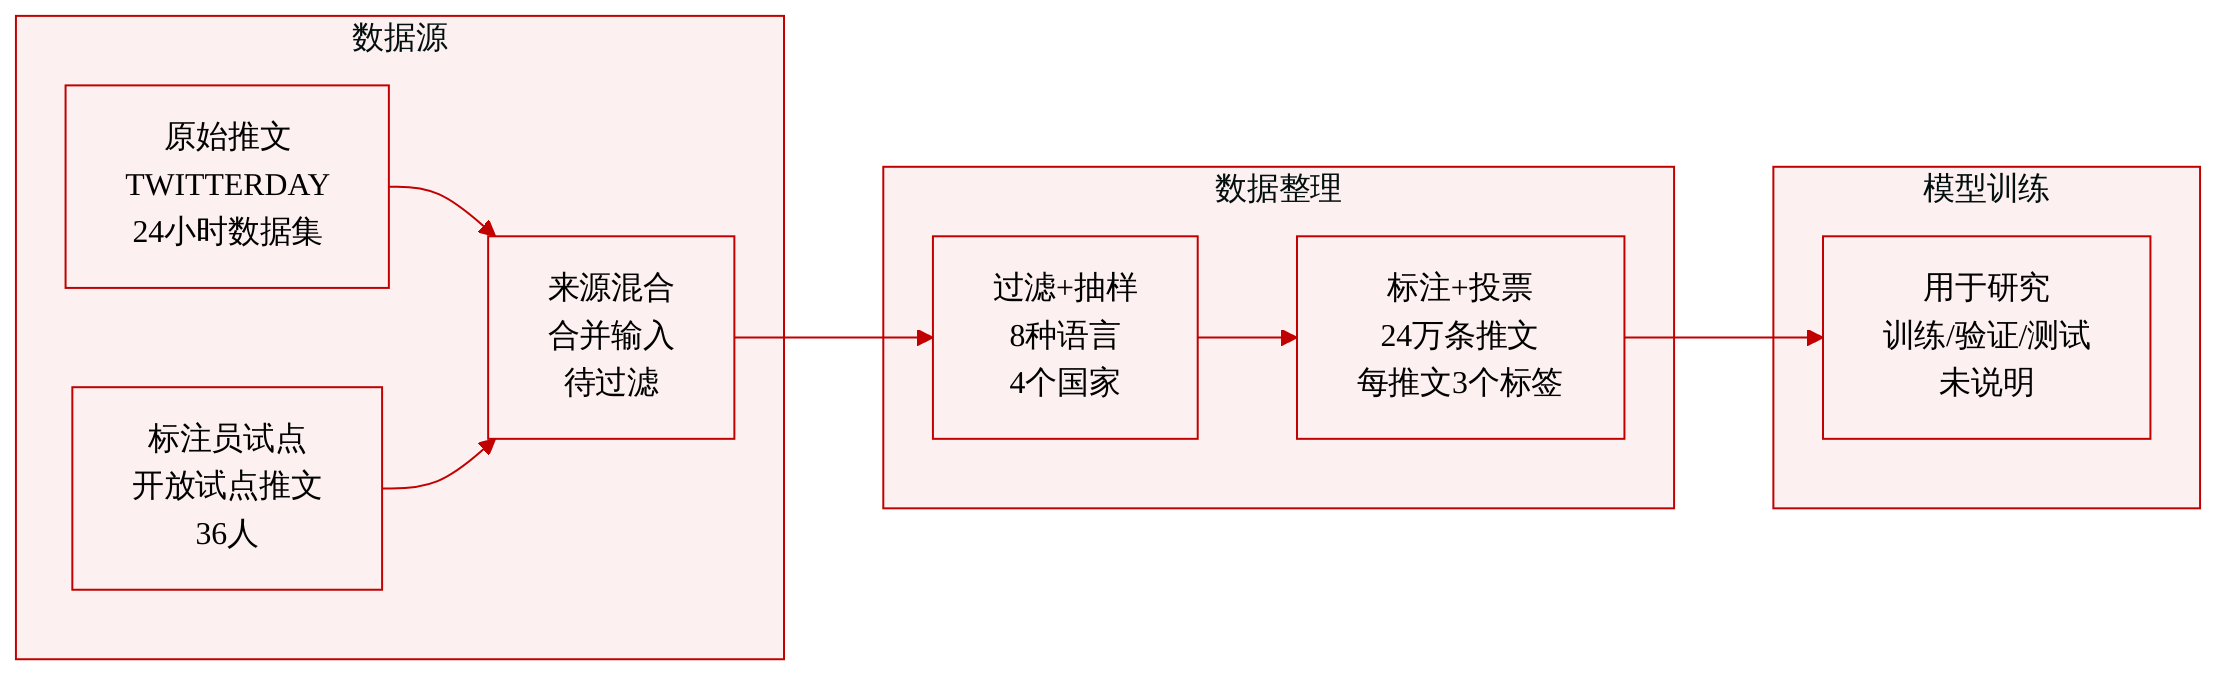
作者基于 TWITTERDAY 集合构建 HATEDAY 数据集。TWITTERDAY 包含 2022 年 9 月 21 日开始的一个 24 小时时段内的所有 Twitter 帖子,总计约 3.75 亿条推文,来自约 4000 万用户。
-
数据集通过对 TWITTERDAY 应用语言级别和国家级别过滤器构建:
- 语言过滤器:作者保留八种广泛使用且有仇恨言论检测资源可用的语言:阿拉伯语、英语、法语、德语、印尼语、葡萄牙语、西班牙语和土耳其语。
- 国家过滤器:对于英语,作者额外聚焦四个以英语为主的 Twitter 市场:印度、肯尼亚、尼日利亚和美国。
-
用户国家由自述个人资料地点通过 Google Geocoding API 推断,作者指出这种做法存在局限。
-
在抽样之前,作者移除转发推文,使数据集强调原始用户内容。
-
最终 HATEDAY 数据集由 240,000 条已标注推文组成:
- 对保留的八种语言,每种语言随机抽样 20,000 条推文。
- 对保留的四个国家,每个国家随机抽样 20,000 条推文。
- 这些样本旨在代表每种语言和国家背景下的真实 Twitter 活动。
-
标注设置包括 36 名标注员,每种语言或国家分配三名标注员。
- 对于英语、阿拉伯语和法语等全球性语言,作者尽可能提高标注员地理多样性。
-
推文被标注为三类:
- 仇恨:基于感知身份特征,直接攻击、辱骂或威胁个人或群体,或宣扬暴力的帖子。
- 冒犯:令人反感但不具仇恨性的帖子,包括侮辱、威胁、粗俗语或脏话。
- 中性:既非仇恨也非冒犯的帖子。
-
对于仇恨推文,标注员还会将目标群体记录为自由文本元数据。
-
每名标注员先完成试点阶段,标注从 Hugging Face 上开源仇恨言论数据集中抽取的 100 条推文,并重复该过程,直到标注员间一致性达到 Krippendorff 的 alpha 阈值 0.7。
-
最终样本中的每条推文由三名标注员标注,最终标签由多数投票决定。一致性统计显示,93.4% 的推文完全一致,6.4% 的推文部分一致,仅 0.2% 的推文完全不一致。
-
作者使用最终得到的数据集研究 Twitter 上有害内容的流行程度和性质。
- 仇恨言论总体上较为罕见,平均约占帖子的 0.7%,在不同语言和国家中均低于 2%。
- 冒犯性内容远比仇恨性内容常见,比例从法语中的 2.5 倍到葡萄牙语中的 19 倍不等。
-
标注数据还支持仇恨言论目标分析。
- 最常见目标是政治、种族和性别相关群体。
- 出现了上下文相关模式,例如印度存在较高的宗教仇恨言论,德国有较强的政治仇恨言论,种姓歧视等主要出现在印度。
方法
作者采用结构化标注流程,为仇恨言论检测生成一致且受控主观性的标签。工作流首先将每条推文归入三个语义类别之一。如果一条推文宣扬暴力,或基于性别或种族等感知特征对个人或群体进行直接攻击、辱骂或威胁,则被标注为仇恨。如果一条推文包含可能令人反感但不具仇恨性的语言,包括侮辱、威胁、粗俗语或脏话,则被标注为冒犯。如果一条推文既非仇恨也非冒犯,则被标注为中性。对于被分类为仇恨的推文,标注员还会提供自由文本标签,指出目标群体,这形成了超出单一类别分配的更丰富标注信号。
标注过程旨在通过规范性说明和质量控制训练减少标注员主观性。标注员团队按语言或国家组织,团队会尽量从不同来源选择参与全球性语言工作的标注员。所有标注员遵循详细指南,指南描述仇恨言论分类体系,并澄清仇恨、冒犯和中性内容之间的边界。在标注主样本之前,每名标注员会使用此前开源的已标注数据集中的帖子完成试点阶段。在该阶段,标注员标注 100 条帖子,并重复该过程,直到由 Krippendorff 的 α 衡量的标注员间一致性达到 0.7 阈值。
标注员通过试点阶段后,会为其分配的语言或国家标注一个包含 20,000 条推文的随机样本。每条推文由三名标注员独立标注,最终标签由简单多数投票决定。这种多标注员设计创造了冗余,并通过共识化解有噪声的个体判断。最终一致性统计表明标注过程高度一致:三名标注员在 93.4% 的推文上达成一致,在另外 6.4% 的情况下两名标注员达成一致,只有 0.2% 的情况下三名标注员都不一致。因此,该工作流结合预定义分类体系、引导式训练、重复一致性检查、冗余标注和多数投票,为下游模型训练构建可靠的监督信号。
实验
实验在具有代表性的 HATE-DAY 社交媒体数据上评估监督式仇恨言论检测器、广泛使用的毒性 API 和 zero-shot 大语言模型,同时使用学术数据集和功能测试进行验证。结果证实,真实世界检测远弱于基准评估所示,监督式方法通常优于 zero-shot 模型,API 往往领先,而性能会因语言和国家而异。进一步分析将该差距归因于冒犯性假阳性、上下文缺失、学术数据集与真实世界仇恨流行度之间的目标错位,以及审核所需的人工审核负担高,这意味着完全自动审核不可行。
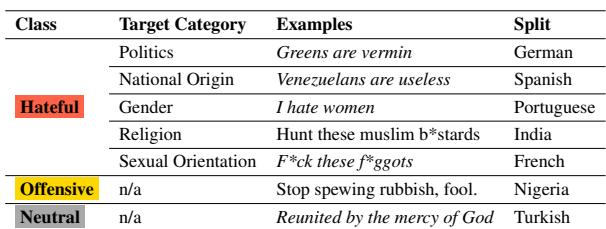
这些示例区分仇恨推文和冒犯推文:仇恨推文针对政治、民族、性别、宗教或性取向等特定群体,冒犯推文则包含令人反感的语言但没有指定目标。示例还将中性推文展示为既非仇恨也非冒犯的普通语言。这表明目标识别是仇恨类别的核心,而冒犯推文更多由语气和脏话定义,而非群体目标。仇恨示例与具体目标类别相关,包括政治、国籍、性别、宗教和性取向。冒犯示例和中性示例没有目标,冒犯推文仅由侮辱性或粗俗语言标记。
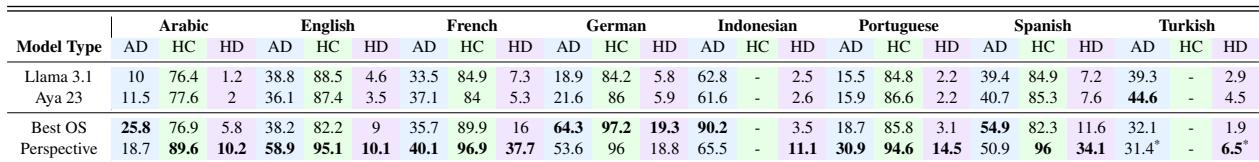
模型在学术仇恨言论数据集和功能测试上的表现明显优于在代表性真实世界数据集上的表现。跨语言和跨国家来看,真实世界检测仍然有限,欧洲语言和印度数据上的结果更强,非欧洲语言和若干其他语境中的结果更弱。监督式模型通常得分高于 zero-shot 开源模型,而 Perspective API 在功能测试中表现出较强性能,并且往往在真实世界检测中优于开源仇恨言论模型。与学术和功能测试设置相比,真实世界数据上的检测性能急剧下降。欧洲语言和印度推文通常表现出比非欧洲语言和其他国家更高的真实世界准确率。监督式开源模型和 Perspective API 在真实世界检测上通常优于 zero-shot 开源模型。
跨国家来看,模型在真实世界评估上的性能远低于学术评估。开源模型在尼日利亚表现出最强的真实世界结果,而 Perspective API 在美国和印度相对较高。肯尼亚缺少可直接比较的开源监督式模型,凸显了覆盖空白。无论是开源模型还是 API 模型,学术评估精确率都持续高于真实世界精确率。在美国和印度,Perspective API 在真实世界数据上优于开源模型,而开源模型在尼日利亚表现最强。肯尼亚语境没有可用的开源监督式模型,限制了那里的模型比较。
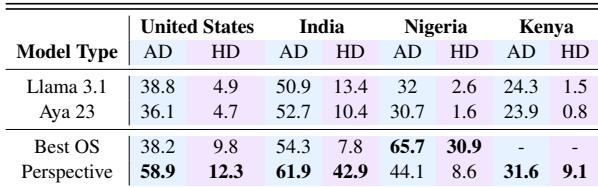
这些示例阐明,仇恨推文依赖于针对特定目标群体的攻击,而冒犯推文主要由没有指定目标的侮辱性或粗俗语言构成。将学术测试与真实世界多语言数据进行比较的实验表明,仇恨言论检测在真实世界环境中难度大得多,欧洲语言语境和印度语境中的性能通常更强,若干非欧洲语言和地区的性能更弱。监督式开源模型和 Perspective API 通常优于 zero-shot 模型,但模型优势会因国家而异,覆盖空白仍然存在。