Command Palette
Search for a command to run...
语言模型抵抗对齐:来自数据压缩的证据
语言模型抵抗对齐:来自数据压缩的证据
Jiaming Ji Kaile Wang Tianyi Qiu Boyuan Chen Jiayi Zhou Changye Li Hantao Lou Juntao Dai Yunhuai Liu Yaodong Yang
摘要
大型语言模型(LLM)可能表现出不符合预期或有害的行为。近期研究集中于通过对齐来缓解 LLM 的有害输出。尽管付出了这些努力,一些异常现象表明,即使是精心实施的对齐过程也可能被轻易规避,无论是有意还是无意的。对齐微调是否对模型产生了稳健的影响,还是其影响仅仅是表面的?在本文中,我们从理论和实证两个角度对这一现象进行了首次探索。在实证方面,我们展示了对齐后模型的弹性,即在进一步微调时倾向于回退到预训练阶段形成的行为分布。利用压缩理论,我们形式化地推导出微调在对齐方面的破坏性不成比例地大于预训练,潜在地可达数量级差异。我们通过在不同类型和规模的模型上进行实验验证了弹性的存在。具体而言,我们发现模型性能在回退到预训练分布之前迅速下降,此后下降速率显著降低。此外,我们进一步揭示弹性与模型规模的增大和预训练数据的扩展呈正相关。我们的研究结果强调了需要应对 LLM 固有的弹性,以缓解其抵抗对齐的问题。
一句话总结
来自北京大学人工智能研究院的研究人员揭示了对齐后大语言模型的弹性,并通过压缩理论证明,相对于预训练,微调会以不成比例的方式破坏对齐,且弹性与模型规模及预训练数据规模呈正相关。
核心贡献
- 该论文识别出对齐后大语言模型中的弹性,即在这些模型上进一步微调可能导致预训练期间形成的行为分布重新显现。这一发现支持了一种对齐阻力机制,该机制能够逆转或削弱对齐效果。
- 该工作基于训练与对齐的压缩理论视角,表明微调扰动下归一化压缩率的变化与数据集规模成反比,因此模型倾向于保留规模更大的预训练分布,并遗忘规模较小的对齐分布。
- 在不同类型和规模的大语言模型上的实验显示,性能会快速下降,随后回退至预训练分布,并且随着模型规模和预训练数据量增加,弹性增强。
引言
大语言模型能够生成流畅、通用文本,因而被广泛部署;然而,其保持与人类意图和安全要求对齐的能力,对于真实世界应用至关重要。在实践中,模型需要在广泛实用性与稳健安全性之间取得平衡,因此可靠对齐成为系统设计中的核心挑战。
先前工作主要依赖基于训练的对齐方法,例如监督微调、基于人类反馈的强化学习及相关变体。尽管这些方法能够减少有害行为,但往往显得表层。高对齐模型在仅经过轻量微调后也可能迅速变得不安全,即便针对良性任务进行微调,也可能削弱安全机制。现有分析指出对齐具有脆弱性,但其底层机制仍不清楚。
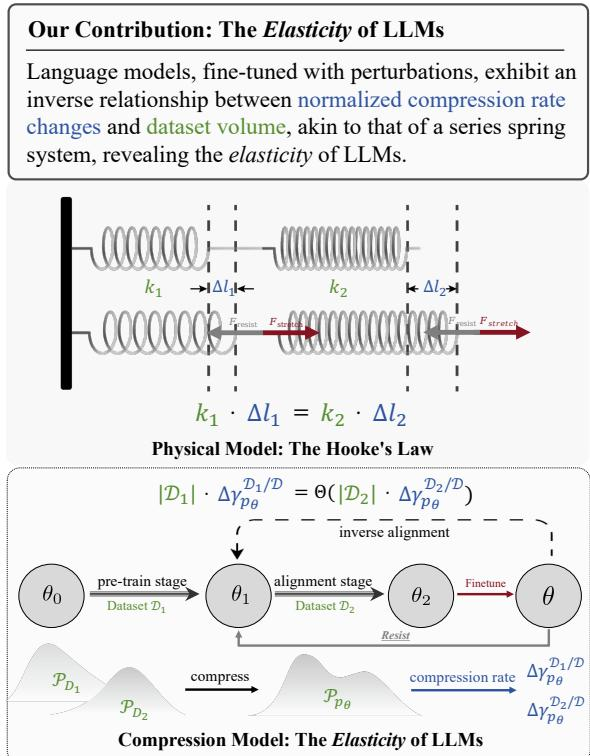
作者将弹性识别为对齐脆弱性背后的关键机制。作者认为,语言模型会抵抗对从大规模预训练数据集学到分布的修改,而由较小数据集引发的变化则更容易反弹。借助压缩理论,他们将训练和对齐建模为影响模型归一化压缩率的过程,并表明对齐扰动可以通过反向微调被逆转或撤销。其贡献在于从理论和实证上解释对齐为何本质上不稳定:预训练分布持续存在,更强的对齐可能更快反弹,并且模型变化与数据集规模成反比,使当前对齐方法容易在微小扰动下被侵蚀。
方法
作者利用预测建模与无损压缩之间的等价关系,将语言模型的训练、对齐和扰动行为重新表述为跨多个数据分布的压缩过程。所提出的框架并未引入新的网络架构;相反,它将现有训练流程重新表述为一系列压缩事件,其中语言模型参数 θ 充当压缩协议。预训练建立一个宽泛的基础分布,监督微调将该分布向对齐目标移动,随后的扰动(例如反向微调)则揭示模型能否被驱动回先前的分布。通过度量模型压缩各个相关数据集的效率,该方法将对齐阻力转化为一个信息论量。
出发点是大语言模型的标准训练目标。在预训练阶段,模型学习在长文本序列中预测 tokens。对于来自预训练语料 DPT 的前缀 x=(x0,…,xN−1),损失为
LPT(θ;DPT)=−E(x,xN)∼DPT[logpθ(xN∣x)].在监督微调中,模型在由高质量对齐分布 DSFT 采样得到的配对 (x,y) 上进行训练,其目标为
LSFT(θ;DSFT)=−E(x,y)∼DSFT[logpθ(y∣x)].当目标分布固定时,最小化该负对数似然损失等价于最小化 pθ 与目标监督微调分布之间的 KL 散度。压缩视角将这一点直接联系到编码理论。如果在算术编码中使用模型 pθ,则序列 x=(x0,…,xm−1) 的期望码长为
L=Ex∼D[0≤k≤m∑−log2pθ(xk∣x0,…,k−1)].因此,最小化训练损失等价于最小化期望码长。在该表述中,训练语言模型与压缩其训练分布被视为等价任务。
为了将顺序生成中的压缩过程显式化,作者将每个数据集建模为一棵 token 树。为简化起见,假设 token 词表只包含二值 tokens(例如 0 和 1),以及一个序列结束标记。token 树中的每个节点都有两条分别标为 0 和 1 的子边;以 EOS 节点终止的叶路径表示数据集中的一条响应。叶节点的权重对应于该响应的概率,内部节点的权重则等于其后代节点权重之和。此时,训练语言模型可被解释为在这一棵无限 token 树的若干部分上学习权重。
由于真实模型参数有限,无法精确表示整棵无限 token 树。该方法引入如下假设:模型只能完美地对 token 树的有限深度进行建模,且这一深度随模型规模单调增加。给定参数化模型 pθ,相应压缩协议分两步定义。首先,对相关数据集的 token 树进行剪枝,仅保留顶部 d 层。其次,对剪枝后的树应用霍夫曼编码,其中每条从根到叶的完整路径被当作编码字母表中的一个符号。这样可以对数据分布中被建模的部分得到最优且无损的压缩过程。
由有限模型压缩响应 x 时的理想期望码长可写为
E[Lpθ(x)]=⌈d∣x∣⌉−l=1∑dj=1∑2l−1pljlogplj,其中 d 是剪枝步骤保留的有效深度,plj 表示在压缩协议下深度 l 处第 j 个叶节点所分配到的概率。当多个不相交的数据集被联合训练时,作者按照数据集规模合并其 token 树权重。对于数据集 D1,…,DN,合并后的节点概率为
pljD=∑i=1N∣Di∣∑i=1NpljDi∣Di∣,其中 ∣Di∣ 是数据集 Di 的规模。该构造允许在同一训练后模型下为每个独立数据集分配压缩率。数据集特定的压缩率为
γpθDi=Ex∼Pi[∣x∣LpθDi(x)]=Θ−d∑l=1d∑j=12l−1pljDilogpljD.随后引入归一化压缩率,以比较结构不同且叶节点数量不同的数据集。如果 Ti′ 是数据集 Di 的剪枝树,且 M 是其叶节点数量,则归一化压缩率为
γpθDi/D=γpθDi−logM.归一化压缩率越小,表示模型分布与目标数据集分布之间的对齐越强。该指标成为研究扰动之后对齐是否稳定的核心可观测量。
正式的反向对齐定义使用该指标。假设基础模型 pθ0 在数据集 Da 上经过对齐得到 pθ1。如果应用一个规模小得多的扰动数据集 Db 后得到模型 pθ0′,且行为或分布距离满足
ρ(pθ0′,pθ0)≤ϵ,则从 pθ1 返回到 pθ0′ 的过程被称为反向对齐。在压缩框架中,ρ 由压缩率实例化,因此可以通过跟踪 γpθDi/D 的变化来分析对齐逆转,而不必仅依赖行为基准。
核心分析流程区分三类数据角色:Dp 用于预训练,Da 用于对齐,Dt 用于扰动。该方法假设对齐分布和扰动分布可以视为更广泛预训练数据分布的子集或重新加权版本。在帕累托型质量分布假设下,作者推导出归一化压缩率变化与数据集规模之间的反比例律。当
l=∣Da∣∣Dt∣≪1,k=∣Da∣∣Dp∣≫1,结果为
dldγpθDa/D=Θ(−kdldγpθDp/D),其中
dldγpθDp/D<0,dldγpθDa/D>0.这意味着,随着扰动数据的加入,模型在规模更大的预训练分布上变得更可压缩,而在规模更小的对齐分布上变得更不可压缩。该方法将此解释为面向大数据量的偏好:模型表现得仿佛压缩协议中的资源被优先分配给更大的分布。这种不对称性解释了为什么对齐可能只是浅层的,以及为什么微小扰动便足以将其抹除。
随后,该方法将这一行为映射到类似于胡克定律的物理不变量上。在弹簧常数为 k1 和 k2 的串联弹簧系统中,外力会产生形变量 Δl1 和 Δl2,满足
F∝k1Δl1=k2Δl2.在语言模型场景中,数据集规模 ∣Di∣ 起到弹簧刚度的作用,而 KL 散度的变化
ΔDKL(Ppθ∥PDi)则起到形变的作用。由此得到的弹性量满足
F∝∣Di∣ΔDKL(Ppθ∥PDi).如下方图示所示:
在该表述下,预训练分布 PD1、对齐分布 PD2 和最终模型分布 Ppθ 均通过压缩率来表示。上半部分表达物理类比,其中刚度更高的元件形变更小;下半部分表达模型行为:扰动之后,归一化压缩率的变化与数据规模成反比。该框架因此将反向对齐表述为在压缩动力学下模型对大规模数据分布的偏好所导致的结果。当预训练分布在对齐期间仍然占据主导地位时,会表现为阻力;当经过微调的模型在反向微调过程中重新向规模更大的原始分布移动时,会表现为回弹。
实验
该论文通过实验评估语言模型弹性,方法是在多个 Llama 模型和数据集上,对连续 SFT 切片比较正向对齐与反向对齐,测试从正向到负向微调后的回弹,并分析回弹如何随模型规模和预训练数据量变化。结果表明,反向对齐始终比正向对齐更容易,支持了阻力机制的存在;在正向数据上对齐更强的模型,在接触相反数据后会出现更强的回弹,随后趋于稳定。进一步分析表明,随着模型参数量和预训练数据增加,回弹更加显著,说明更大、更充分预训练的模型具有更强弹性。
在所选基础模型和数据集上,正向对齐始终产生比反向对齐更高的训练损失。这一差距出现在所有比较的阶段转换中,表明模型更容易从后期阶段响应恢复回早期阶段响应,而不是反过来。该模式说明,预训练模型倾向于保留原始分布,并抵抗对齐更新。在 Alpaca、TruthfulQA 和安全任务设置中,反向对齐损失均低于正向对齐损失。该阻力模式在 Llama2 与 Llama3 模型以及不同切片对选择中保持一致。
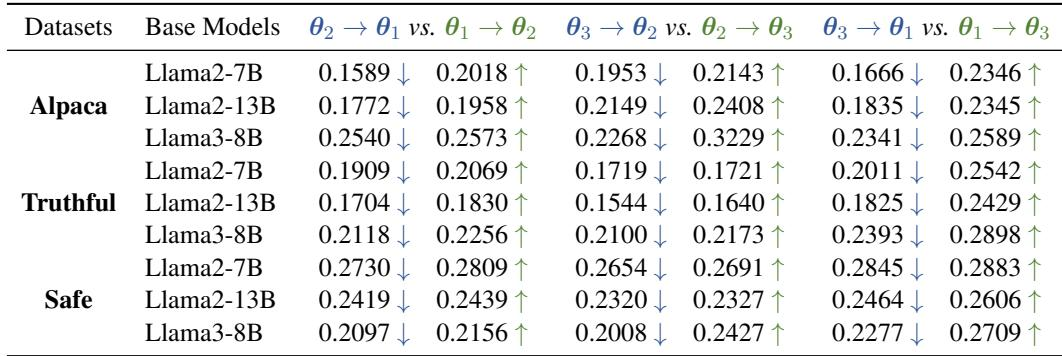
实验比较了多个 Llama2 和 Llama3 设置下的正向对齐与反向对齐训练损失,结果显示反向对齐的损失始终低于正向对齐。这表明,预训练模型更容易从后期阶段响应转换回早期阶段响应,而不是相反,反映其保留原始分布并抵抗对齐更新的倾向。该模式在 Alpaca、TruthfulQA、安全任务以及不同切片对选择中保持一致。